
DIVERGE:打破 RAG 的“思维定式”,让大模型在开放场景中百花齐放
DIVERGE: Diversity-Enhanced RAG for Open-Ended Information Seeking
本文提出了 DIVERGE,一个旨在提升增强检索生成(RAG)系统在开放式问答中输出多样性的智能体框架。该方法通过引入“观点(Viewpoints)”作为中间抽象,并在迭代过程中利用反思引导探索不同视角,实现了在不牺牲回答质量的前提下,将生成结果的多样性提升了约 2 倍。
TL;DR
在处理“如何评价某政策”或“职业发展建议”等开放式问题时,传统的 RAG 系统往往会陷入“复读机”模式:即便检索到了海量信息,模型依然倾向于给出一簇极其相似的回答。来自奥胡斯大学和微软的研究者提出了 DIVERGE。这是一个即插即用的智能体框架,它不再强求模型一次性给出完美答案,而是通过**“反思-发现新观点-针对性检索-定向生成”**的迭代回路,在保持高标准质量的同时,让回答的视角丰富度翻了一番。
背景定位:RAG 界的“知识塌陷”危机
目前大多数 RAG 研究都聚焦于“事实正确性”,默认每个问题都有唯一真理。但在现实世界的开放式信息寻索(Information Seeking)中:
- 用户偏好各异:文化背景、价值观不同,关注点就不同。
- LLM 训练副作用:指令微调(SFT)和强化学习(RLHF)虽然提高了模型服从性,但也让模型变得“谨小慎微”,倾向于输出最稳妥的高概率模式。
作者发现:简单的“增加检索多样性”根本没用。即使给 LLM 投喂了包含 A、B、C 三个视角的文档,模型可能依然固执地只复述视角 A。
核心动机:为什么模型“看”到了却“说”不出来?
作者总结了三大痛点:
- 单一答案偏差 (Single-Answer Bias):RAG 优化目标通常是确定性,导致模型过滤掉了其他合理的可能性。
- 缺乏多样性保持 (Missing Diversity Preservation):模型不记得之前说过什么,多次采样只是简单的重复。
- 闭源兼容性 (Practical Compatibility):很多学术方法需要访问模型的 Logits(Log概率),但 GPT-4o 等闭源模型并不提供。
技术秘密:DIVERGE 的工程直觉
DIVERGE 的核心逻辑是将多样性探索看作一个**“思维演化”**的过程。
1. 架构解析:以“视角(Viewpoints)”为锚点
DIVERGE 不直接让模型“生成多样化的回答”,而是先让模型“想一想还有哪些没说到的观点”。
- 反思引导 (Reflection-Guided):模型首先总结已有的观点,然后问自己:“基于目前搜集的信息,还有哪种合理的立场或细节被忽略了?”
- 轻量级记忆 (Memory Support):不仅记录生成的文字,还记录检索过的文档指纹,确保下一轮迭代不走回头路。
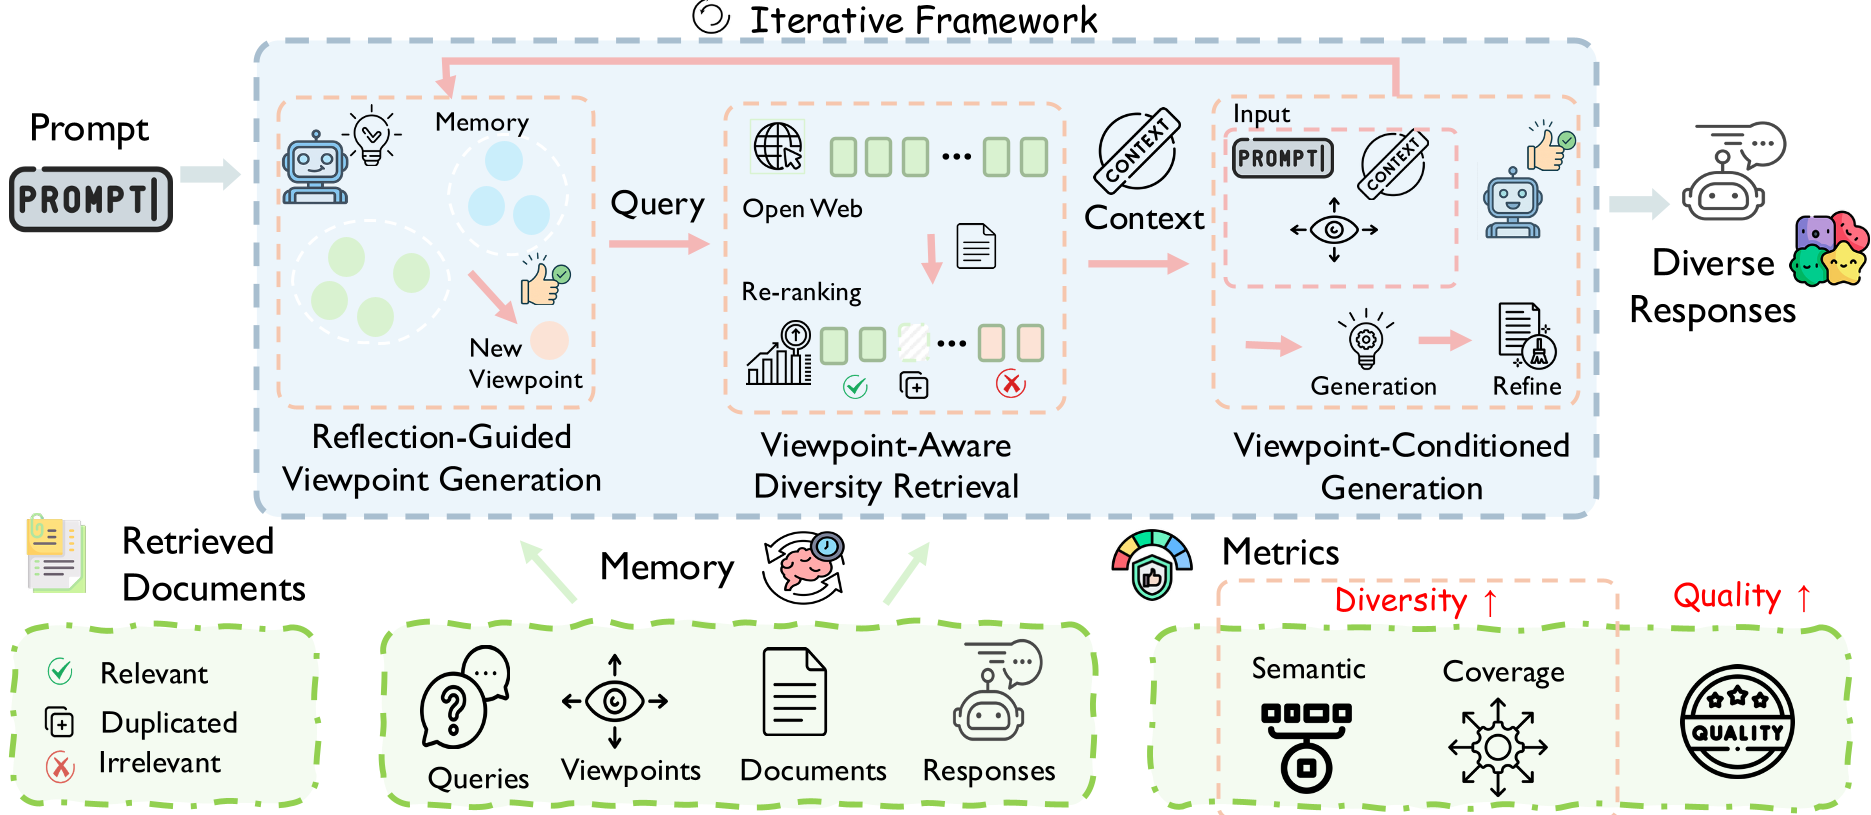 如图所示,DIVERGE 通过 Viewpoint Generation 将抽象的多样性指标转化为具体的生成指令。
2. 改进的多样性检索 (DivReranker)
普通的向量检索只管“像不像”。DIVERGE 扩展了 MMR(最大边际相关性)算法,在评分公式中显式减去了“与历史轮次检索内容”的相似度。这意味着,如果上一轮查了“技术细节”,这一轮它会强迫自己去查“成本分析”或“伦理影响”。
实验战绩:2x 的多样性是怎么来的?
实验涵盖了从开源 120B 到闭源 GPT-5 系列(文中占位名)的顶级模型。
- 关键发现:标准的 RAG 甚至比不加 RAG 的原始模型多样性更低(因为它被参考文档“锁死”了)。
- DIVERGE 表现:在语义多样性(DSem)和覆盖多样性(DCov)上均实现了翻倍。
- 质量守恒:最令人惊讶的是,这种多样性的增加并没有导致胡言乱语。LLM-as-a-judge 的评分显示,其回答质量依然维持在 4.5/5.0 左右的高位。
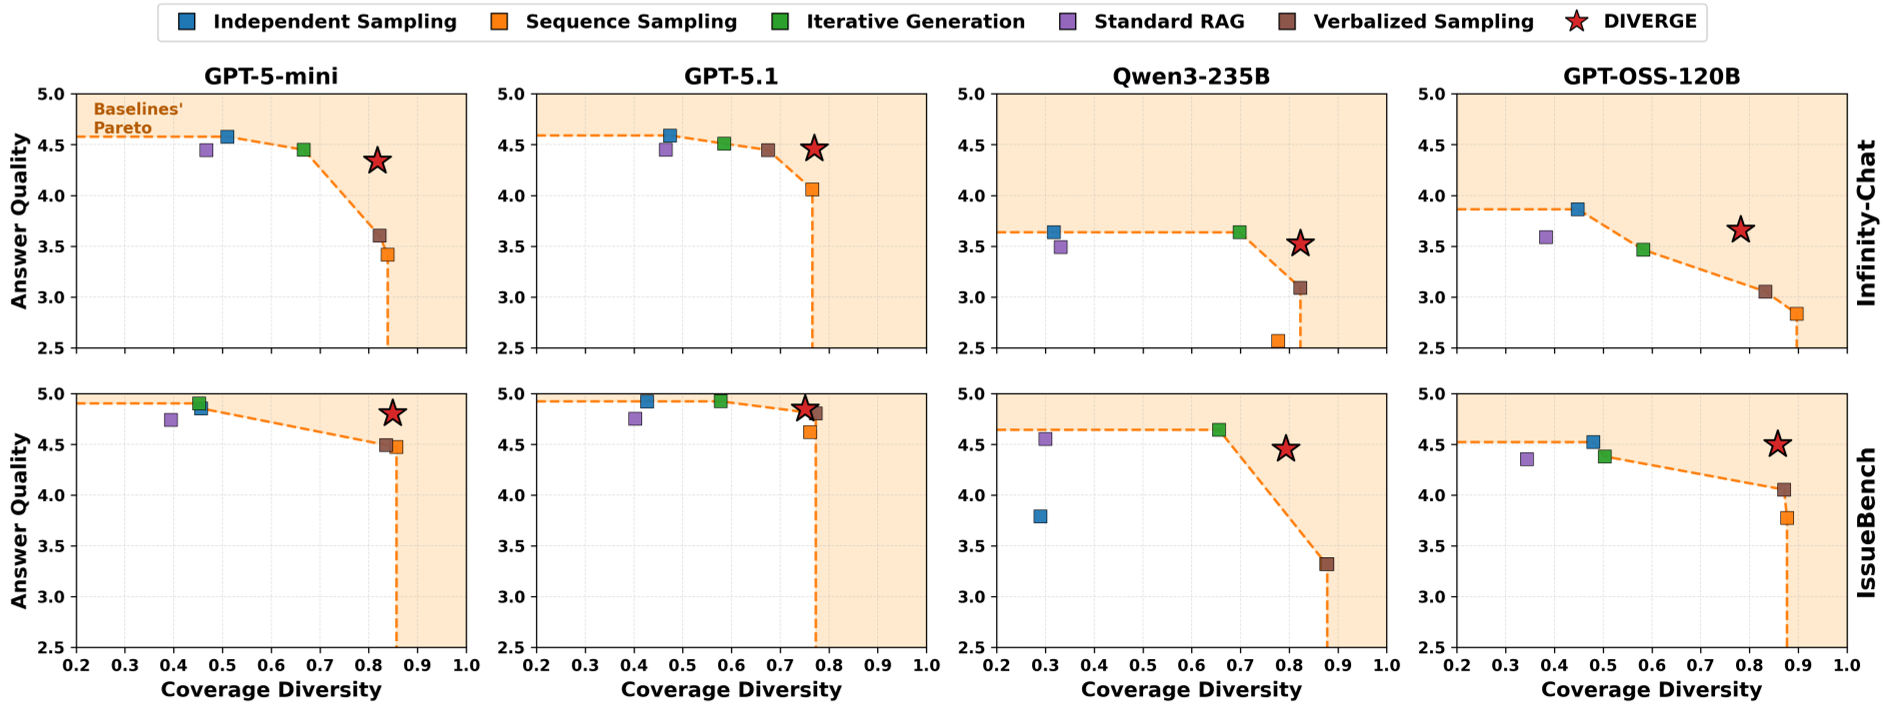 在 Pareto 前沿图中,橙色线条代表基准方法的极限,而 DIVERGE 明显位于右上角,代表了更好的性能平衡。
深度洞察:多样性价值的重估
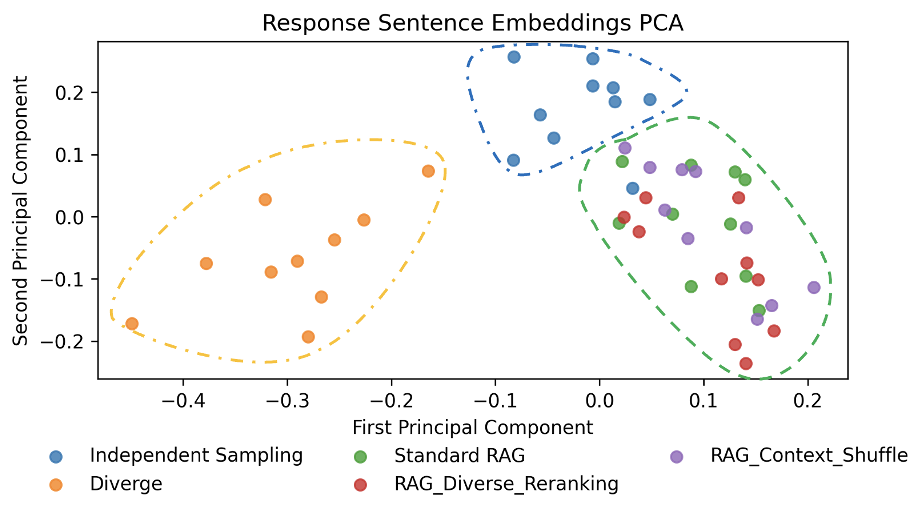
通过 PCA(主成分分析)对回答向量进行降维可视化(如下图),我们可以清晰看到:
- 独立取样的回答聚在一坨。
- 传统 RAG 的回答聚在另一坨。
- DIVERGE 的回答分布在更广阔的空间,这证明它真正探索了不同的语义维度。
总结与局限
DIVERGE 证明了:让模型“生成多样性”是难的,但让模型“由于知道没说什么而生成新内容”是容易的。通过将多样性显式建模为“视角增量”,研究解决了 RAG 生产中一个非常实际的痛点。
局限性:
- 响应时延:由于是迭代式 Agent,耗时和 Token 成本约是 Vanilla RAG 的数倍。
- 高危领域风险:在医疗或安全领域,并非所有“视角”都是安全的,过度追求多样性可能会引入错误信息。
启示:未来的 RAG 不应只是一个简单的管道,而是一个具备“自反思”能力的分析系统。