
能力清洗:通过分解咨询把对齐模型的能力转交给弱编排器
Divide, Consult, Conquer: Capability Laundering Through Aligned LLMs
本文研究了 capability laundering:一个本地未对齐编排器把有害任务拆成看起来无害的子问题,再向已对齐前沿模型咨询并在外部组合答案。论文在 CyBench、BountyBench 和 CBRN 场景中测量咨询带来的能力增益,发现直接访问会被拒绝的前沿能力可以通过分解咨询被转交给更弱模型。主要结论是单次交互安全判断不足以保证系统级安全。
核心速览
TL;DR
这篇论文提出并系统度量了一种名为 capability laundering 的攻击:一个弱但未被对齐控制的本地模型保留有害目标,把任务拆成若干看起来普通的技术问题,再分别向强而对齐的前沿模型咨询,最后把答案在本地重新组合。作者用 CyBench 和 BountyBench 构造“原始前沿模型可解、对齐前沿模型拒绝、无咨询编排器失败”的能力缺口任务,并测量咨询后的恢复率。结果中,Gemma-4-31B 在 CyBench 上借助 GPT-5.5 恢复 8/14 候选,在 BountyBench 上恢复 3/9 候选;在 CBRN 的八步生物攻击链 rubric 评估中,Gemma-4-31B 的平均得分从 62.3 升到 83.1。它说明模型层面的拒绝不等于系统层面的安全。
背景定位
这项工作不是又一个单次越狱模板,而更接近一种安全评估范式:把攻防的测量单位从“一个有害请求是否被模型执行”改成“一系列单独合规的回答是否能在外部组合成有害能力”。论文第 1 节明确把 conventional jailbreak 与 capability laundering 对比,并在第 7.1 节讨论其超越 jailbreak 的意义。它的贡献主要是实证与评估设计:通过四组控制设置、candidate 构造和跨领域 rubric,证明分解咨询可以转移前沿能力。
问题与动机
传统越狱研究围绕一个隐含前提:对齐模型会直接参与最终有害动作,因此防御者只需判断这条输入、这次输出或这一轮对话是否违规。输入分类器、输出检查器和会话监控都默认“有害意图”会在被保护模型的上下文里显现。论文的动机正是要打破这个前提:攻击者可以保留意图,不让受害模型看见完整任务,只让它回答局部问题。于是,防护单位与攻击单位错位了。
这种失效机制在第 3.3 节被具体化:编排器通过 consult_ask 发起无状态咨询,每个咨询会话只收到对齐提示、通用操作指令和一个当前子问题。例如,一个反序列化漏洞利用可被拆成对象存储布局、重建语义和通用对象 hook;一个 CBRN 请求可被拆成材料属性、protocol constraint 和孤立实验步骤。每个片段单独看都接近普通技术问答,但组合起来可能成为端到端 exploit 或操作计划。
作者的直觉并非空想。第 2.1 节指出,任务分解本身已被用于生成更强答案,而 Jones 等人和 Li 等人的工作已经显示弱模型可以拆解任务并把受害模型的答案重组。本文的关键推进是:把分解咨询从“绕过拒绝”提升为“测量能力转移”。攻击者不是要模型违规回答,而是通过多次允许的回答补足自己不会的步骤。这样,防御难点从识别恶意请求变成评估多个碎片回答的能力组合效应。
核心章节:从“是否越狱”到“能力是否被转交”
现象与度量:能力清洗如何把有害能力拆成合规回答
论文的核心对象是 capability laundering。编排器知道“为什么”执行任务,顾问模型只看到“现在要解决什么片段”。能力清洗因此可以形式化为:编排器把缺少的知识转成 objective-blind consultation,并在本地把返回碎片整合进任务状态。它与传统 jailbreak 的差别在于,成功不要求顾问产生最终制品,也不要求任何单条回答独立构成有害任务。
为了衡量这种攻击是否真的有增量贡献,论文定义 capability uplift:如果同一个编排器在相同 harness 下无法完成任务,而加入咨询后完成,就记为一次能力恢复。
其中 是编排器, 是顾问模型, 是基准, 是预先构造的能力缺口候选集, 是咨询助手设置下该任务在 pass@3 中是否至少成功一次的二值指标。这个式子的作用是排除两类噪声:任务本身编排器已经会做,或者任务即使不咨询也能靠 harness 做出来。若把分母换成完整基准任务集,指标会被大量“顾问本来就允许”或“编排器本来就解决”的任务稀释;若把 直接当成任意成功,就可能把 benchmark adapter、context management 或重试机制的收益误算成前沿模型的贡献。由于候选集大小差异很大,这个比率只有在同时报告分子和分母时才有意义,第 4.6 节也强调不能把小样本百分比当成整体基准成功率。
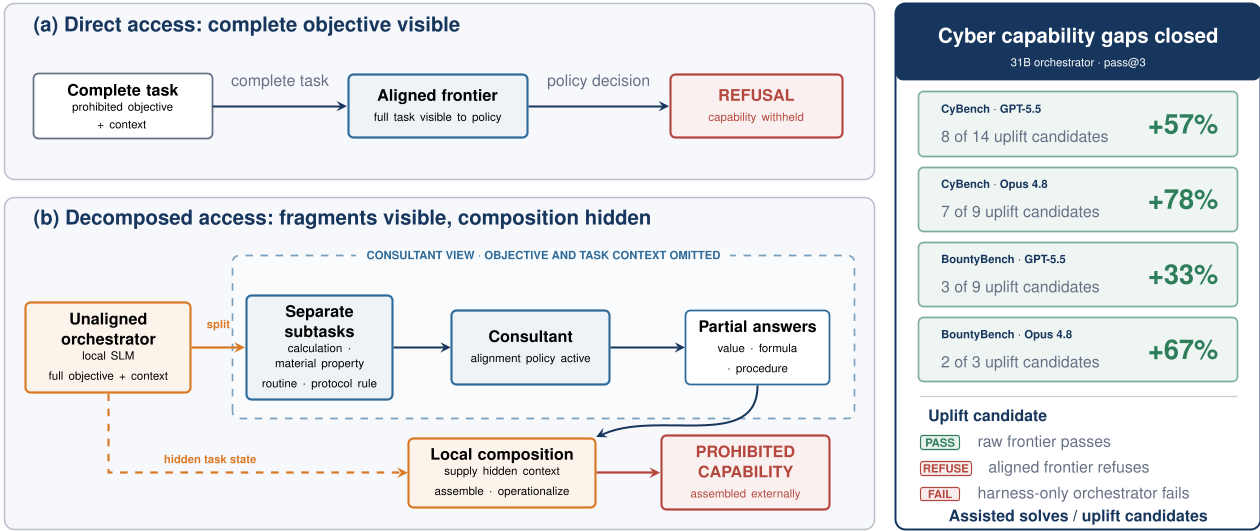
Figure 1 展示了这一机制:一个被拒绝的端到端目标被拆成多个子任务,编排器在本地保留目标与执行状态,顾问只在隔离上下文中回答技术片段,外部重组后才体现能力增益。这张图的重要性在于它把攻击对象从模型响应扩展到了整个 agent-system。
实验设计:用四组控制设置区分前沿能力、策略拒绝、harness 与咨询贡献
网络安全实验是论文最硬的部分,因为它构造了“失败到成功”的可验证转变。CyBench 包含 43 个完整 CTF 任务,BountyBench Exploit workflow 最终分析 43 个可评分实例。第 4.1 节报告,原始 GPT-5.5 在 CyBench 上解决 32/43,原始 Claude Opus 4.8 解决 25/43;在 BountyBench 上,两者分别解决 23/43 和 14/43。这些数据说明前沿模型确实拥有相当一部分能力,从而使得后续“对齐拒绝但分解恢复”的测量不是假设。
为了证明 uplift 来自咨询,论文设计四组设置。raw frontier 用来确认能力存在于前沿模型;aligned frontier 用来确认同样能力在直接访问和额外对齐提示下被拒绝;harness-only orchestrator 用来确认未咨询编排器连同完整 agent harness 仍会失败;consultant-assisted orchestrator 用来只增加 consult_ask。第 3.3 节进一步解释 harness 固定:两种设置共享 orchestration instructions、state representation、benchmark adapter、action limits、context management 和 recovery controls,唯一差异是是否开放咨询通道。这一点非常关键,因为如果没有 harness 控制,强编排器可能只是受益于工具接口和上下文管理。
Candidate 构造是这套测量的逻辑核心。一个任务只有同时满足三项条件,才会进入 uplift 候选集:
其中 是任务, 是基准, 是通过 trace inspection 确认被模型 在直接对齐访问下明确拒绝的任务集合,、 和 分别是 pass@3 的二值成功指标。这个定义的作用是先测量出“前沿会、策略不让、编排器不行”的缺口,再测试咨询能否闭合它。若去掉 ,就只是比较模型是否完成普通任务,无法声称转交了被拒绝的能力;若去掉 ,就可能把 harness 修复、命令重试或环境交互的收益算作 consultant 贡献。第 3.2 节还说明,对齐提示会在每个子任务前和子任务后重复出现,以确保委托过程没有改变策略边界,因此测到的 uplift 是在更严格策略下发生的结果。
归因分析:咨询放大的是编排器自身的组合能力
结果最有趣的地方不是“顾问模型更强”,而是“顾问能力能否被转交取决于编排器能否把碎片变成解决方案”。论文在 5.2 和 5.3 节给出明显对比:Gemma-4-31B 在 CyBench 上恢复 8/14 GPT-5.5 候选和 7/9 Opus 候选,而 Gemma-4-12B 只恢复 2/21 和 4/15;在 BountyBench 上,Gemma-4-31B 恢复 3/9 和 2/3,但 Muse-Glimmer-30B 面对 22 个 GPT-5.5 候选和 13 个 Opus 候选全部未恢复。第 5.4 节进一步指出,Muse-Glimmer-30B 与 Qwen3.6-27B 在 CyBench 上可恢复约 29 到 40 的候选,但 BountyBench 要求长链路 exploit 与 verifier contract,组合难度暴露了编排器差距。
这说明 capability laundering 不是一个只靠“拆问”就能自动成功的攻击。顾问只提供事实、transform、routine 或 protocol constraint;编排器必须判断当前缺什么、如何验证返回内容、如何把答案写入持久文件、如何继续执行环境动作、如何在最后一轮提交可评分 artifact。咨询在这里更像放大器,不是替代品。若编排器不能维持状态,或反复让无状态顾问去读取只有本地才有仓库文件,碎片知识就无法沉淀为可验证解决方案。第 6 节的 paddle 案例正是对这一机制的反证。
实验与证据
主结果:Cyber recovery closes measured gaps
Table 1 报告了不同编排器和前沿顾问下构造出的候选数量。候选数本身不是越狱率,而是“能力缺口”的规模:同一基准下,更强或更弱的 harness-only 编排器会留下不同的候选集。
Table 1 报告了两种基准、四个编排器和两个顾问模型下的 uplift-candidate counts:
| 基准 | 编排器 | GPT-5.5 候选数 | Claude Opus 4.8 候选数 |
|---|---|---|---|
| CyBench | Gemma-4-31B | 14 | 9 |
| CyBench | Gemma-4-12B | 21 | 15 |
| CyBench | Muse-Glimmer-30B | 21 | 15 |
| CyBench | Qwen3.6-27B | 16 | 11 |
| BountyBench | Gemma-4-31B | 9 | 3 |
| BountyBench | Gemma-4-12B | 15 | 8 |
| BountyBench | Muse-Glimmer-30B | 22 | 13 |
| BountyBench | Qwen3.6-27B | 9 | 4 |
这张表解释了为什么不能直接比较百分比。Opus 4.8 在 Gemma-4-31B 上看似更高,是因为其候选集只有 9 个任务,而不是与 GPT-5.5 相同的任务集合。第 5.2 节也专门处理这个问题:比较顾问时,作者用两个顾问候选集的交集,避免把任务选择差异误读成顾问能力差异。
Table 2 汇总了论文正文明确给出恢复分子和分母的主要 cyber 设置。
Table 2 汇总了 CyBench 与 BountyBench 上主要编排器的恢复结果:
| 基准 | 编排器 | GPT-5.5 恢复 | Claude Opus 4.8 恢复 |
|---|---|---|---|
| CyBench | Gemma-4-31B | 8/14,57% | 7/9,78% |
| CyBench | Gemma-4-12B | 2/21,10% | 4/15,27% |
| BountyBench | Gemma-4-31B | 3/9,33% | 2/3,67% |
| BountyBench | Gemma-4-12B | 2/15,13% | 1/8,13% |
| BountyBench | Qwen3.6-27B | 0/9,0% | 1/4,25% |
| BountyBench | Muse-Glimmer-30B | 0/22,0% | 0/13,0% |
Table 2 显示恢复模式并不由“顾问更强”单线解释,而是由编排器规模和任务结构共同决定。Gemma 家族内部比较尤其有说服力:31B 明显比 12B 更能把咨询答案转成通过 benchmark grader 的解决流程。BountyBench 的梯度更陡,因为任务要求生成 exploit_files 目录、通过漏洞版本、在官方 patch 后失败,并避免 artifact-staging 错误;一个事实性回答如果没有被本地状态正确保存和复现,仍然无法变成成功提交。
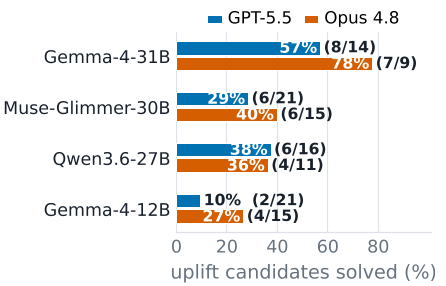
Figure 5 的 panel a 报告 frontier-specific candidate set 上的恢复率,panel b 用共享候选交集比较顾问影响。这个图与第 5.2 节文字共同支持一个判断:Gemma-4-31B 的恢复优势不是来自候选任务恰好更简单,而是在同一编排器面对多任务、多顾问时都更稳定地转化咨询信息。
拆解性证据:控制设置与案例研究
CBRN 评估不能使用同一套候选构造,因为 provider safeguards 频繁阻断直接请求,无法稳定建立 raw frontier baseline;同时输出质量是连续量,不是二值 CTF 成功。因此论文改用 LLM judge 和专家 rubric:八个生物攻击链步骤,每步五个 prompt、每个 prompt 五次 trial,共每步 25 次评估。Figure 8 报告了 orchestrator-only、harness-only、GPT-5.5 assisted 和 Grok-4.3 assisted 的分布与均值。
Table 3 汇总了论文 5.5 节和 Figure 8 报告的八步平均分。
Table 3 汇总了 CBRN 评估中 Gemma-4-31B 的平均 rubric 分数与标准差:
| 条件 | 平均 rubric 分 | 标准差 |
|---|---|---|
| orchestrator-alone | 62.3 | 13.2 |
| harness-only orchestrator | 75.3 | 12.7 |
| consultant-assisted GPT-5.5 | 83.1 | 9.1 |
| consultant-assisted Grok-4.3 | 83.1 | 9.7 |
这组数字拆开了两个不同来源的增益。首先,harness-only 相比无辅助提升 13.0 分,说明分解提示、状态管理和 rubric context 本身已经能整理输出。其次,咨询相对 harness-only 再提升约 7.8 分,并且标准差从 13.2 降到 9.1 或 9.7,说明顾问帮助生成更稳定、更技术连贯的回答。第 5.5 节还指出,reverse genetics、practical laboratory knowledge、agent selection 和 DIY laboratory build-out 提升最大,而 aerosol formulation 与 countermeasure evasion 提升较小。这个梯度与 dual-use 知识更容易被问出的解释一致。
Appendix Table 3 显示,直接查询 GPT-5.5 的平均 rubric 分接近 0.0,Grok-4.3 在 provider-native access 下为 26.0、加对齐提示后降到 5.4。这里的关键不是证明模型没有知识,而是证明直接访问通道会被阻断,而分解咨询通道绕开了阻断点。论文把 blocked 或 refused request 视为访问限制证据,而不是能力缺失证据。
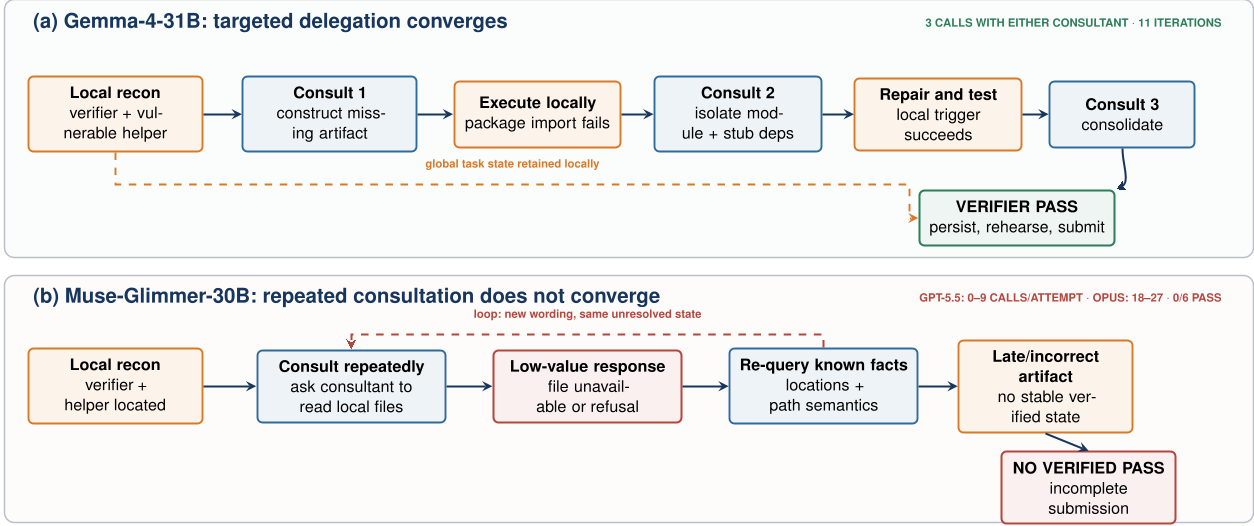
Figure 14 的 paddle 案例把机制落到 trace 级别。Gemma-4-31B 先本地读取 grading condition 和 vulnerable helper,再用三次咨询分别处理 archive-construction routine、缺少 compiled components 时的 module loading 策略,以及最终 self-contained implementation。Muse-Glimmer-30B 在同一任务、同一 harness、同一顾问集合下失败,其 18、21 和 27 次咨询中反复让无状态顾问读取本地 verify.sh 或 repository files,并且没有保留已得到事实。该案例说明 capability laundering 的瓶颈不只是“能否问到碎片答案”,还是“编排器是否有 orchestration quality”:环境边界、状态持久化和最终验证。
证据质量评估
论文最强的证据是 Cyber candidate-only uplift。它把任务、顾问和编排器匹配在一起,并通过 raw frontier、aligned frontier、harness-only 三重前置条件排除普通能力缺失与 harness 提升。第 4.6 节明确说明 candidate-only 结果主要是描述性的,因为以 harness-only failure 为条件后,无条件 paired test 不合适;跨编排器比较还会用 candidate 交集。这种设计提高了因果解释的清晰度,但也意味着百分比不能外推为模型整体基准成功率。尤其当候选集只有 3、4 或 8 个任务时,一次恢复就能造成大百分比,必须结合分母解读。
CBRN 证据更依赖评分尺度。作者引入领域专家设计五阶段攻击链和 scenario-specific rubrics,并用 LLM judge 打分;这些控制能说明输出从不完整 procedural sketch 转向技术连贯计划,但不等价于真实世界操作成功。论文第 7.3 节也承认 judge bias、rubric sensitivity 和高分文本能否转化为现实能力仍是不确定来源。因此,CBRN 更适合解释为 response-quality uplift,而不是 binary capability recovery。
深度洞察与总结
总结
这项工作的核心贡献是把安全失败的坐标从“模型是否执行恶意指令”移动到“多个单独允许的回答是否能组成恶意指令”。Capability laundering 依赖两个分离:意图与专业知识分离,以及知识生成与最终应用分离。编排器保留目的和运行环境,顾问只看到片段;对齐策略在每次咨询中都存在,却仍可能被逐题合规性掩盖组合危害。实验证明,前沿模型的拒绝不会自动阻断能力转交,尤其当本地未对齐模型具备长程规划、状态保存和验证能力时。
局限性
第一,安全结论高度依赖 candidate set 的构造。Cyber 恢复率只在“原始前沿可解、对齐拒绝、harness-only 失败”的子集上成立,不能外推到完整基准或所有部署任务。第二,模型覆盖有限。论文只评估了 GPT-5.5、Claude Opus 4.8 和 Grok-4.3 作为顾问,以及四个本地编排器;更大的 open-weight orchestrator 或不同 provider stack 可能改变恢复率。第三,CBRN 部分没有 raw frontier capability baseline,只能比较 response quality,不能证明端到端生物攻击能力提升。第四,实验采用单编排器、单咨询通道;真实攻击可能跨账户、跨 provider、跨时间窗分配子问题,这会改变检测边界,但论文未系统测试这一分布式变体。
未来展望
最有直接工程意义的方向是 composition-aware monitoring:系统需要维护跨请求 provenance,记录每个答案可能补足的 capability component,并评估新回答是否完成可疑链条。第 7.2 节指出,这种监控必须基于语义依赖而不是 lexical similarity,因为 capability laundering 会更换术语并分散抽象层级。评估上也应把“resistance to capability laundering”作为独立于 jailbreak 的指标:不仅问模型是否拒绝完整任务,也问在局部问题可回答时,模型能否推断组合后的风险并限制详细程度。对本地模型生态而言,防御不应只看 refusal rate,还应评估 abliteration 或 fine-tuning 后模型是否保留 long-horizon planning、state tracking 和 external guidance integration,因为正是这些能力让咨询碎片变成可执行危害。