
DoRA:国防领域 RAG 评估的“试金石”与领域适配新范式
Domain-oriented RAG Assessment (DoRA): Synthetic Benchmarking for RAG-based Question Answering on Defense Documents
本文推出了 DoRA (Domain-oriented RAG Assessment),一个专门针对国防(Defense)领域文档的 RAG 评估基准。该框架包含 6.5K 个由合成技术生成的、基于意图触发的问答对,并显著提升了 Llama3.1-8B 模型在特定领域的任务成功率(+26%)和忠实度。
TL;DR
在国防、国安等高危领域,RAG(检索增强生成)系统的“一本正经胡说八道”可能导致重大的决策失误。本文提出的 DoRA (Domain-oriented RAG Assessment) 填补了通用 LLM 在私有国防文档处理上的评测空白。研究发现:通过 DoRA 生成的高质量合成数据对模型进行微调(SFT),能让 8B 规模的模型在忠实度和准确性上吊打未适配的 GPT-4o。
背景定位:通用 benchmark 的“虚假繁荣”
目前的 RAG 评测(如基于 Wikipedia 的数据集)正面临三大危机:
- 数据污染 (Contamination):公开数据可能已经在 LLM 的预训练阶段被模型“背下来”了,测出的高分很可能是记忆力而非检索能力。
- 意图错位 (Intent Mismatch):现实中用户不只是问“什么是XX”,还需要总结报告、提取预算或对比政策。
- 指标失真:传统的文本重叠指标(BLEU/ROUGE)根本测不出模型是否真的根据证据说话。
核心动机:国防场景的“零容忍”
国防场景是 RAG 的压力测试场:文档高度私密、访问控制严格、且对幻觉零容忍。作者认为,评估 RAG 不能只看“答案对不对”,更要看“答案是否由授权的证据块支撑”。
方法论深度解析:DoRA 的三位一体架构
DoRA 的核心在于其合成数据生成流程,它不是简单的随机提问,而是模拟真实专家意图。
1. 意图驱动的五种样式 (Style-conditioned)
DoRA 将问题分为五类,直接对应国防工作流:
- FIND (查找):提取特定日期、坐标。
- EXPLAIN (解释):解释复杂的军事术语或政策差异。
- SUMMARIZE (总结):对长篇简报进行提炼。
- GENERATE (生成):根据上下文生成清单或行动方案。
- PROVIDE (提供):提取具体的数值、预算或采购数据。
2. 证据束选择 (Evidence Bundling)
为了确保生成的 QA 对具有“可审计性”,DoRA 采用了一种复杂的证据选择算法:
- 使用 NLI (Natural Language Inference) 预过滤掉无关段落。
- 利用 LLM 对段落组合进行打分,标准包括:完整性、互补性(非冗余)和逻辑连贯性。
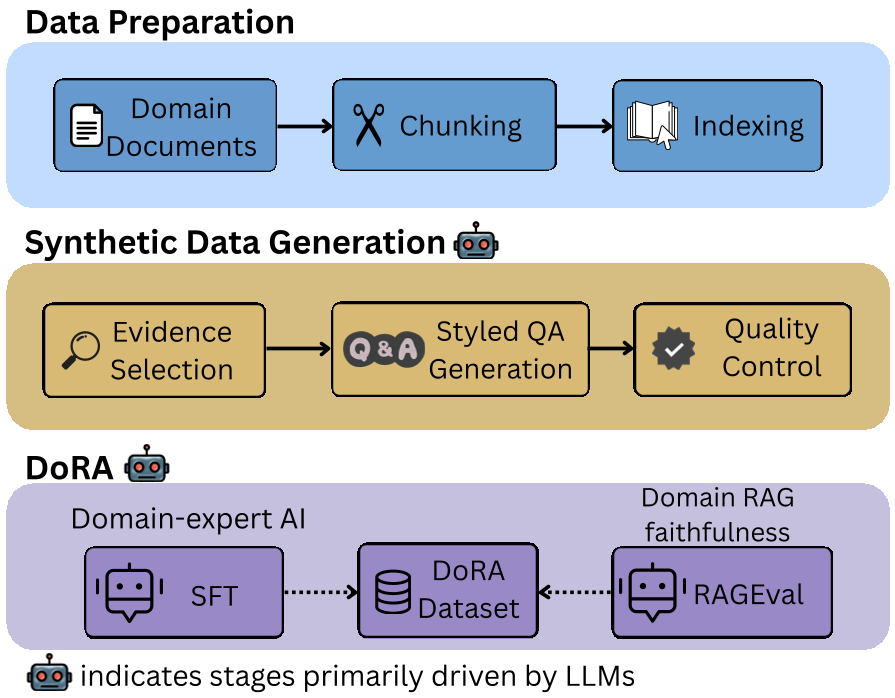 图 1:DoRA 流程图,从数据准备到基于样式的 QA 生成,再到下游领域评估与适配。
实验与战绩:小模型微调后的逆袭
研究人员将 Llama3.1-8B-Instruct 在生成的 5150 个实例上进行了 LoRA 微调(称为 DoRA SFT)。
关键发现:
- 性能聚类:在未适配的情况下,即使是 GPT-4o、Claude-3 等顶尖模型,由于受到国防文档冷门术语的影响,表现都非常接近且平庸。
- 微调带来的飞跃:DoRA SFT 模型在 Token F1 上达到了 56.53%,远超基础模型的 38.13%。
- 幻觉终结者:在 RAGEval 忠实度检测中,DoRA SFT 的幻觉率(Hallucination)从 7.04% 降至 3.50%,减半!
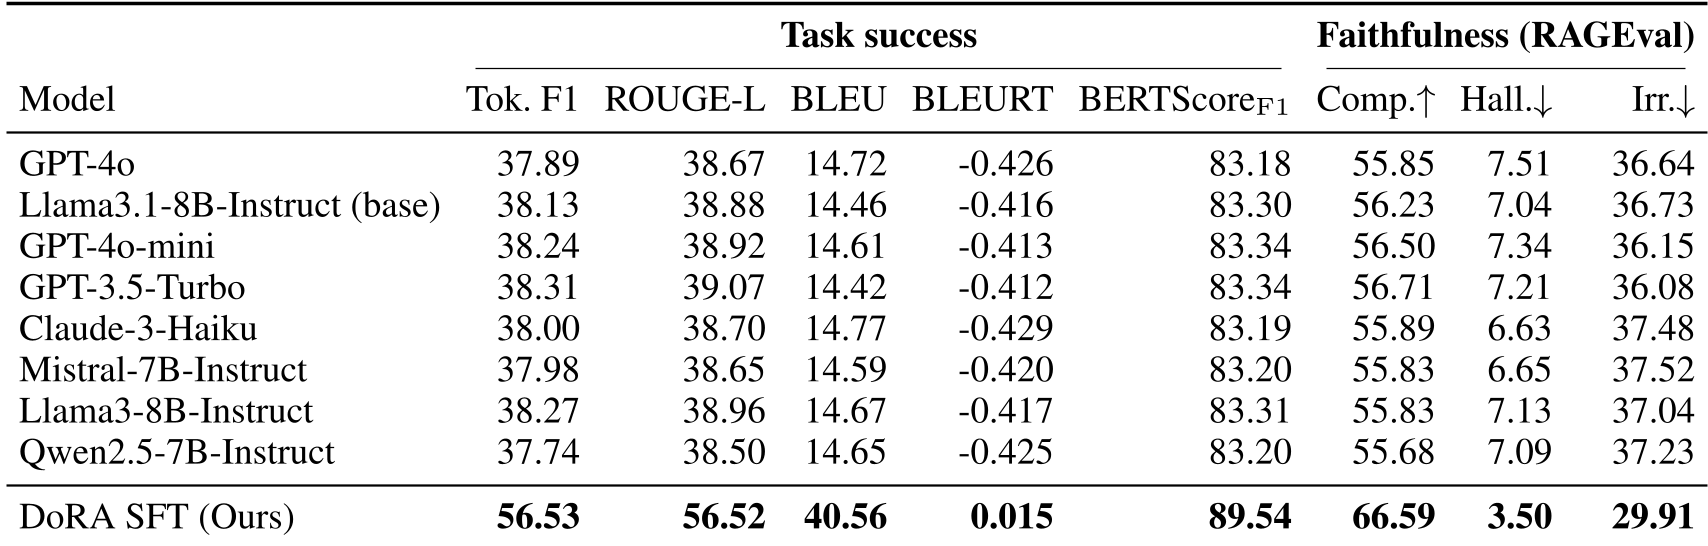 表 2:不同模型在 DoRA 上的基准测试。注意最后一行 DoRA SFT 的显著提升。
深度洞察:回归测试的工程价值
DoRA 不仅仅是一个数据集,它更像是一个自动化评估流水线。
- 检索器诊断:实验发现,在国防文档中,密集的向量检索(Dense Retrieval)虽然在 top-k 覆盖率上更稳,但传统的 BM25 在 top-1 命中率上依然有独特优势,建议采用混合检索。
- 人机协作的“天花板”:通过极少量的专家标注(52 个样本)与合成数据混合,模型表现能进一步对齐专家风格,证明了该框架的可扩展性。
总结与展望
DoRA 的出现标志着 RAG 评估从“通用模型竞赛”转向“领域特种兵训练”。对于企业级 RAG 开发者而言,这篇论文提供了一个清晰的 SOP:定义领域意图 -> 合成高质量 QA -> 自动化证据审计 -> 领域 SFT -> 持续回归测试。
局限性:目前 DoRA 主要针对文本,未来多模态(地图、图表)和多跳推理(Multi-hop)将是该基准测试的下一个巅峰。