
dots.ocr:单一 VLM 统一版面布局与 OCR,突破 126 种语言解析极限
dots.ocr: Multilingual Document Layout Parsing in a Single Vision-Language Model
本文推出了 dots.ocr,这是一个统一的多模态大模型 (VLM),可在单一前向传播中同时完成版面检测、文本识别和阅读顺序理解。该模型在 OmniDocBench 上取得了 SOTA 成就,并在涵盖 126 种语言的新基准 XDocParse 上显著领先。
TL;DR
小红书社区技术团队(hi lab)近日发布了 dots.ocr,这是一个打破常规的文档解析模型。它不再像传统 OCR 系统那样分步执行“检测-识别-排序”,而是通过一个统一的 Vision-Language Model (VLM) 架构,在一次生成过程中搞定所有环节。凭借配套的超大规模多语言数据引擎,它在包含 126 种语言的解析测试中展现了统治级的性能,甚至在多项指标上大幅超越了 GPT-4o 和 Gemini-2.5-Pro。
痛点与动机:为什么“拼凑”的系统行不通?
长期以来,文档解析领域被 Pipeline(流水线) 范式统治:先用检测模型找框,再用 OCR 模型读字,最后用逻辑模型排版。这种方式有两个致命伤:
- 错误级联 (Cascading Errors):如果第一步检测歪了,后面识别得再准也没用。
- 缺乏协同 (Missed Synergies):识别过程其实可以反过来纠正检测的偏差(例如,如果识别出字断了,检测框就应该合在一起),但 Pipeline 隔离了这种反馈。
此外,全球范围内大部分语言的标注数据极度匮乏,导致现有系统一旦脱离英中环境,解析效果便会断崖式下降。
核心方法:统一任务建模与三阶段数据引擎
1. 将解析视为自回归生成
dots.ocr 将复杂的文档解析任务简化为一个数学公式。给定图像 ,直接生成序列 : 其中 是坐标, 是类别, 是内容。模型生成的顺序直接对应人类的阅读顺序,从而原生支持了 Reading Order。
2. 模型架构
- Vision Encoder (1.2B):放弃了常见的预训练图像编码器,转而从零训练了一个支持 1100 万像素 原生高分辨率输入的 VE,专门捕捉文档的微小字符和复杂结构。
- Language Decoder (1.7B):基于 Qwen2.5-1.5B 基础模型,保留了强大的结构化输出和关系理解能力。
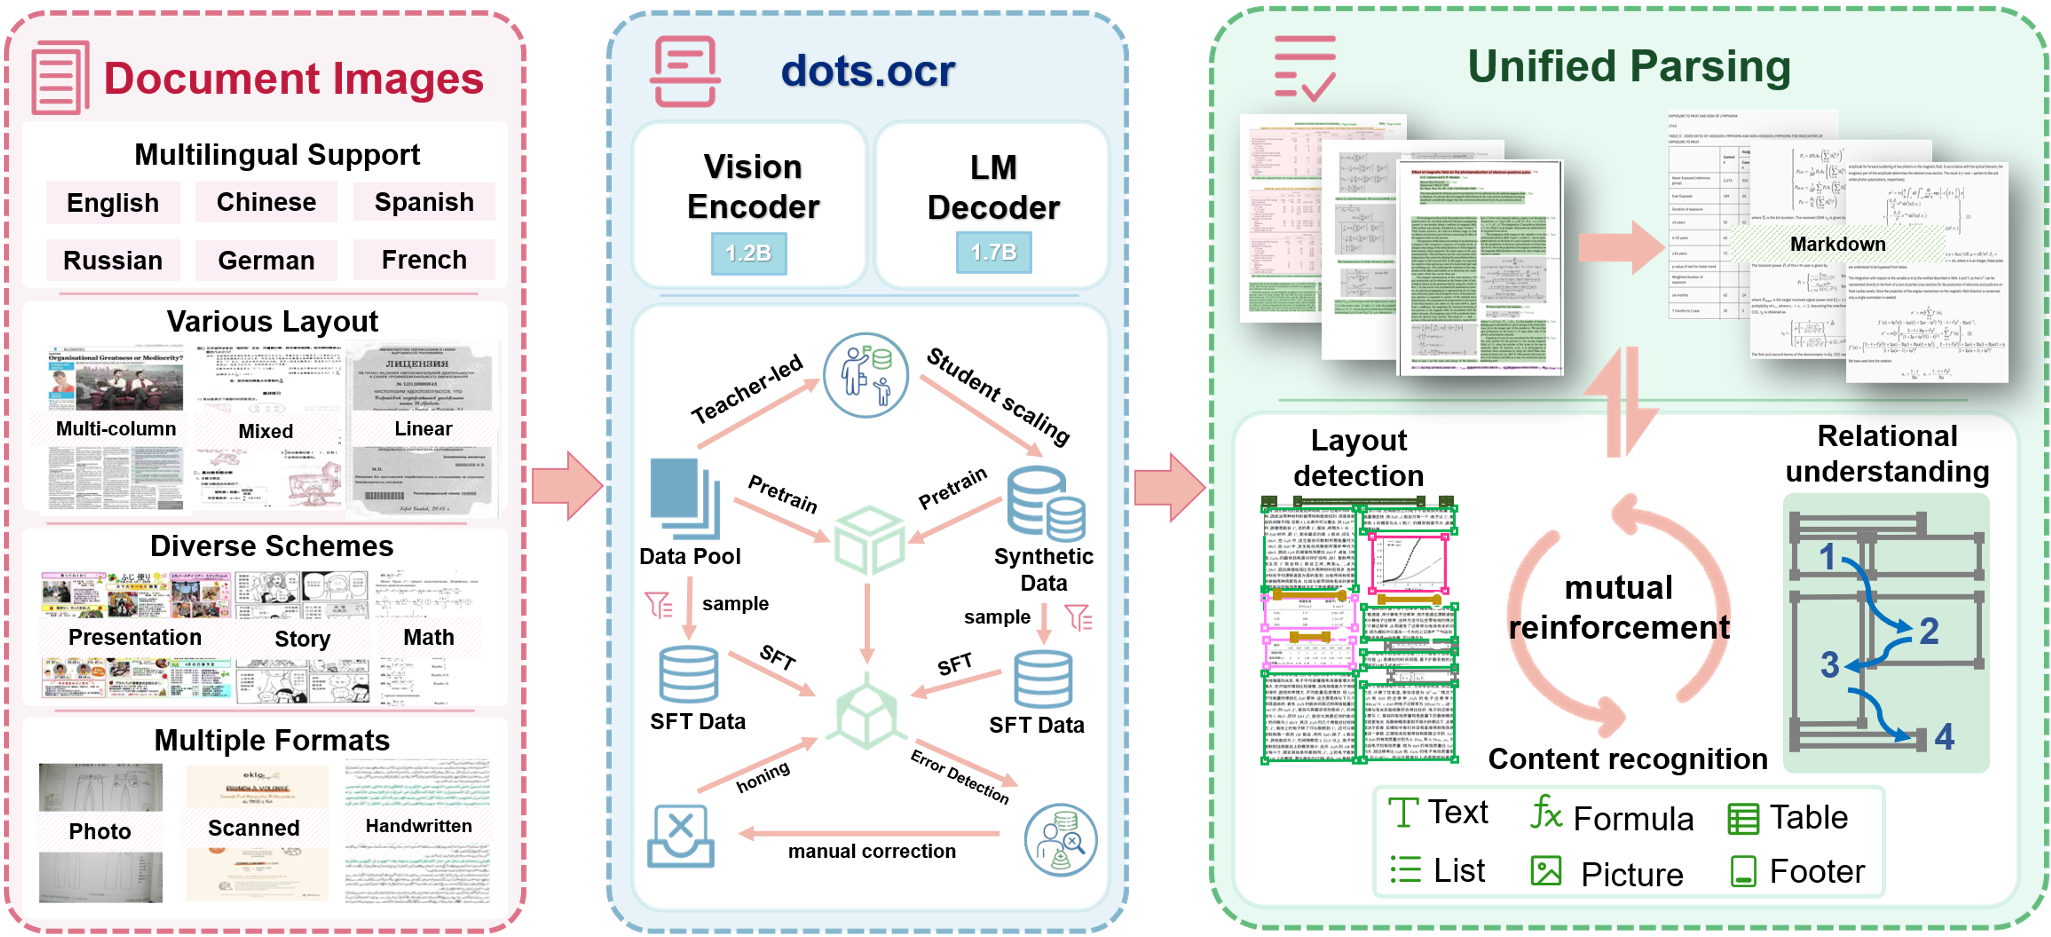
3. 数据引擎:解决“无米之炊”
这是 dots.ocr 最核心的竞争力。作者开发了一个三阶段引擎:
- 第一阶段:教师引领。利用强大的商用模型(如 Qwen2.5-VL-72B)将标记好的文档重渲染为多语言版本。
- 第二阶段:大规模合成。通过蒸馏出的学生模型,将数百万原始 PDF 自动标注为高质量练习题,涵盖 126 种语言。
- 第三阶段:人机协同纠偏 (HITL)。让模型先跑一遍,利用 Oracle 模型自动识别其“产生幻觉”或“定位不准”的案例,由人工精准修复,专项突破弱点。
实验战绩:让通用模型也望尘莫及
在针对 PDF 解析的权威榜单 OmniDocBench 上,dots.ocr 不仅击败了专门的 OCR 专家模型(如 MonkeyOCR),在中文和英文表现上也优于 GPT-4o。
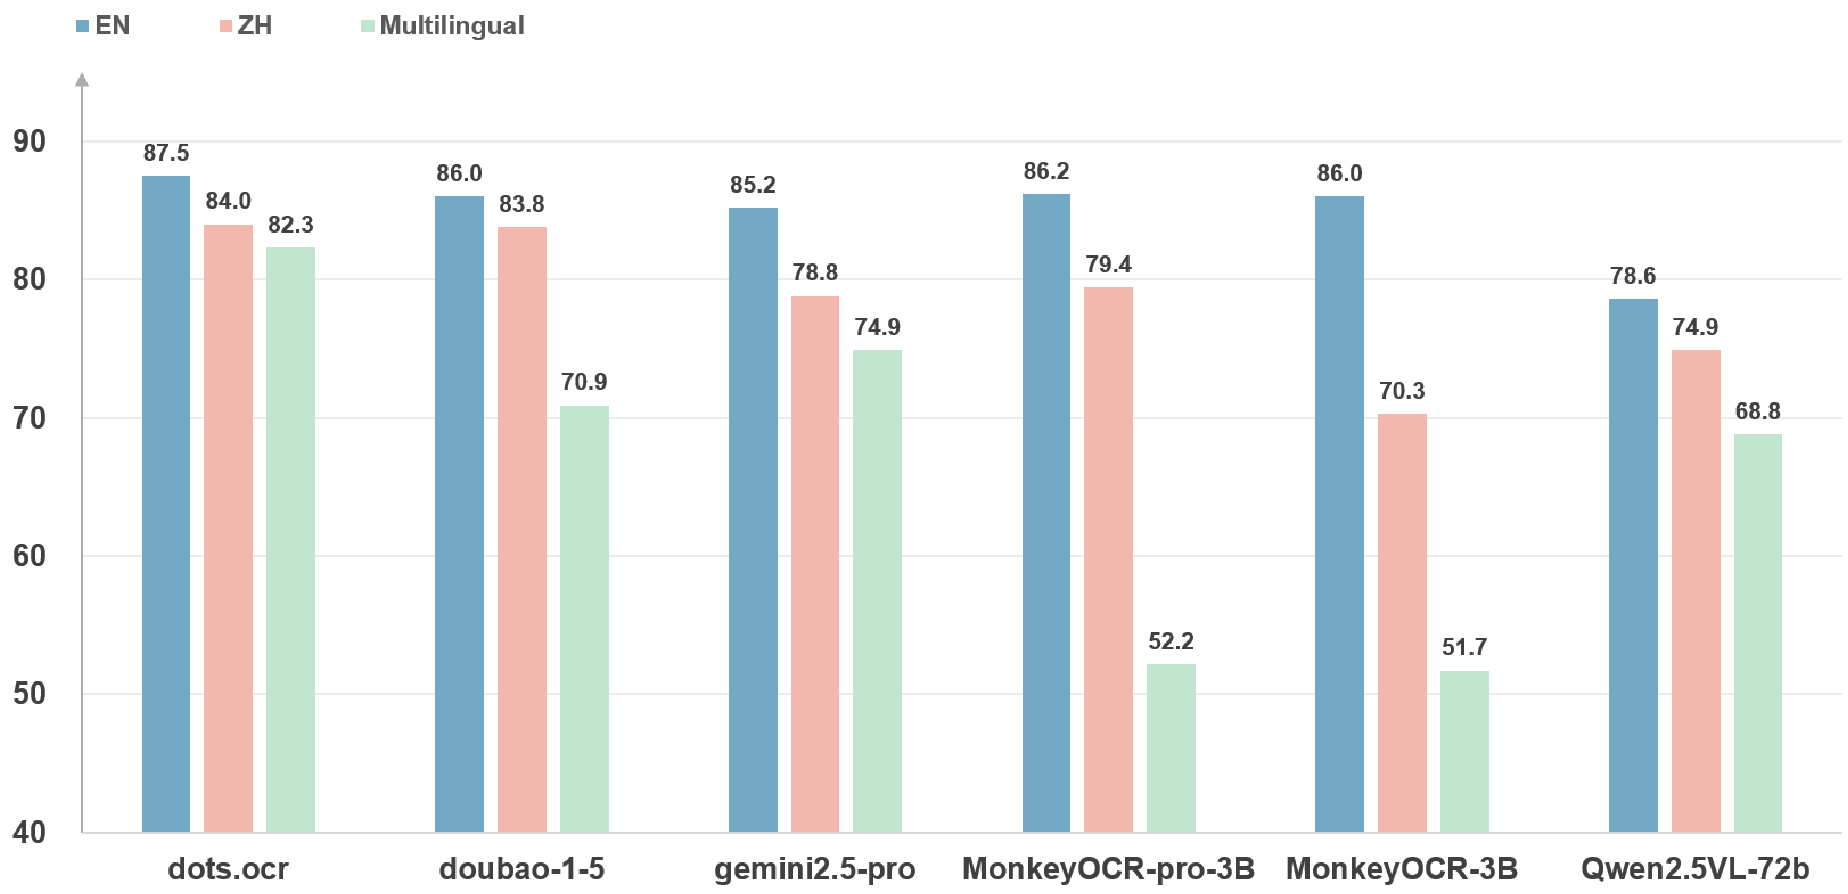
最惊人的提升出现在 XDocParse (126 语言评测)。在 Overall Edit 距离指标上,dots.ocr 的表现比 Gemini-2.5-Pro 提升了 29.5%,这证明了这种专门化的联合学习路径在应对小众语言时的巨大优势。
深度洞察:版面感知与语义理解的“共生关系”
论文的消融实验给出了一个非常有趣的结论(Inductive Bias):
- 检测是基础:如果没有检测坐标辅助,模型的阅读顺序推理能力下降了 30% 以上。
- 识别是约束:加入文本识别任务后,模型找框找得更准了。这说明语义信息(字的意思)能够反哺几何感知(框的位置)。
- 阅读顺序是桥梁:如果打乱阅读顺序进行训练,模型的整体版面理解能力会崩塌。这暗示了 VLMs 内部并不是单纯看像素,而是通过“序列化逻辑”来构建对文档空间的理解。
总结与局限
Takeaway:dots.ocr 的成功标志着文档处理从“点线面结合”转向“全空间建模”的跨越。通过将版面拓扑、文本内容和逻辑顺序三者合一,我们得到了一个更鲁棒、更具上下文感知能力的解析器。
局限性:虽然 1100 万像素已属顶级,但在处理极长、极其密集的报纸版面或工程图纸时,计算量依然是瓶颈。未来如何进一步优化自回归过程中的推理延迟,将是该技术走向实时化应用的关键。