
逆向思维提升鲁棒性:优化器降级如何补齐 LLM 遗忘的“短板”?
Downgrade to Upgrade: Optimizer Simplification Enhances Robustness in LLM Unlearning
本文提出了名为 Hybrid 的 FO-ZO 混合优化策略,通过“降级”优化器(如使用零阶 ZO 或压缩梯度)来提升大语言模型(LLM)遗忘(Unlearning)的鲁棒性。实验证明该方法在 MUSE 和 WMDP 等基准测试中,能有效抵补模型量化或重学习攻击引起的遗忘失效。
TL;DR
大语言模型(LLM)的“遗忘”效果就像在沙滩上写字,很容易被量化或微调等后续操作“抹去”。本文提出了一种出人意料的方案:主动降级优化器阶数。通过引入零阶(ZO)优化干扰,模型会被引导至一个更宽阔、抗干扰能力更强的损失盆地,从而实现即便遭遇 4-bit 量化或恶意重学习攻击,敏感知识也无法被“找回”。
痛点深挖:脆弱的“遗忘”保护
当前的 LLM 遗忘技术(如 NPO、GradDiff)看似在测试集上清除了隐私数据,但在参数空间内,这些“被忘掉”的信息往往只是被推到了附近的一个浅坑里。
- 量化崩溃:简单的 4-bit 权重压缩就能让模型重拾记忆。
- 重学习攻击:攻击者只需用极少量样本微调,模型就会“想起”原本被禁止的内容。
作者发现,这在很大程度上要归咎于现有的高精度优化器(如 Adam、Sophia)。这些优化器太“精准”了,导致模型陷入一个极度陡峭且不稳定的解空间。
核心直觉:优化器等级 (Grade) 与鲁棒性的负相关
论文提出了一个核心观察:优化器的信息维度越高,遗忘越脆弱。
- 二阶 (SO):如 Sophia,遗忘最快,但量化后记忆恢复也最快。
- 一阶 (FO):如 Adam,表现折中。
- 降级一阶:如 1-bit Adam 或 signSGD,鲁棒性反而提升。
- 零阶 (ZO):由于其梯度估计本质上在做“随机平滑”,表现出最强的抗干扰性。
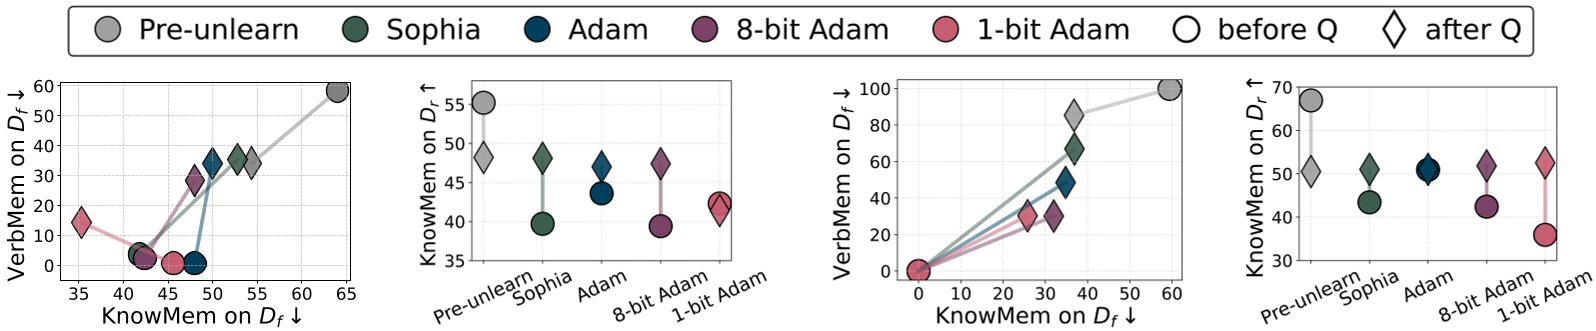 不同等级优化器(二阶到压缩一阶)在量化后的表现对比,可以看到 1-bit Adam 展现了更好的韧性。
解决方案:Hybrid FO-ZO 混合优化
直接使用零阶优化器会导致训练极慢且精度不足(Utility 损失大)。作者因此设计了 Hybrid 策略:
- 博弈论视角:将其视为“ लीडर-फॉलोअर”(Leader-Follower)博弈。ZO 优化器作为“领导者”,负责寻找具备鲁棒性的搜索空间;FO 优化器作为“追随者”,在 ZO 选择的方向上进行高精度微调。
- 交替更新:在训练过程中交替进行 FO 和 ZO 步骤,最终以 ZO 步骤收尾,确保模型停留在一个“硬性盆地”中。
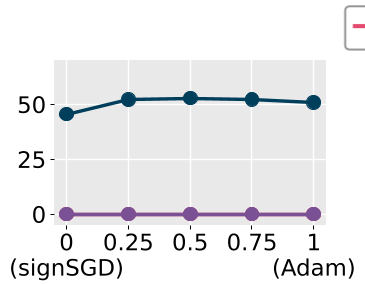 线性模式连接性(LMC)分析证明,ZO 优化的解位于一个与常规 Adam 完全不同的优化盆地(Basin)。
实验与战绩
在多个基准测试(MUSE, WMDP, TOFU)中,Hybrid 优化器均展现了统治力:
- 量化韧性:在 LLaMA2-7B 上,使用 Hybrid 优化器后,即使经过 GPTQ 4-bit 量化,遗忘指标(VerbMem)依然保持在极低水平(接近零),而 Adam 则会出现明显的记忆反弹。
- 重学习防御:面对 100 步的重学习攻击,Hybrid 方法的知识召回率比目前的 SOTA 鲁棒遗忘方法 SAM 还要低。
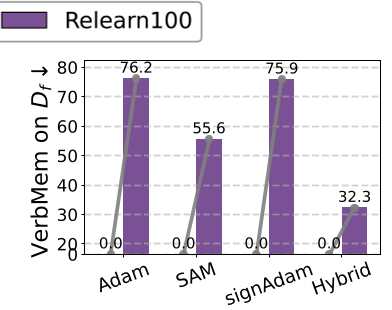 图示展示了在 MUSE 任务中,Hybrid 方案在对抗重学习攻击时显著优于 SAM 和 Adam。
深度洞察与总结
传统的优化理念是追求“更高、更快、更强”,但在安全领域,“模糊、信噪比低”的优化过程反而可能是一种保护机制。
启发总结:
- 鲁棒性源于多样性:ZO 引入的随机性迫使模型寻找参数空间中更平滑的局部最优。
- 效率与防御的平衡:Hybrid 框架通过交替策略,巧妙规避了 ZO 收敛慢的缺陷。
- 未来方向:这种“降级”思想是否可以推广到安全对齐(Alignment)的其他环节?例如让 RLHF 更加难以被越狱?这值得学术界进一步探索。
局限性:虽然 Hybrid 不增加额外运行时间,但在超大规模模型上的扩展性仍需更多显存优化支持。