
DR Tulu:8B 模型如何通过 RLER 机制在深度调研任务中“以小博大”?
DR Tulu: Reinforcement Learning with Evolving Rubrics for Deep Research
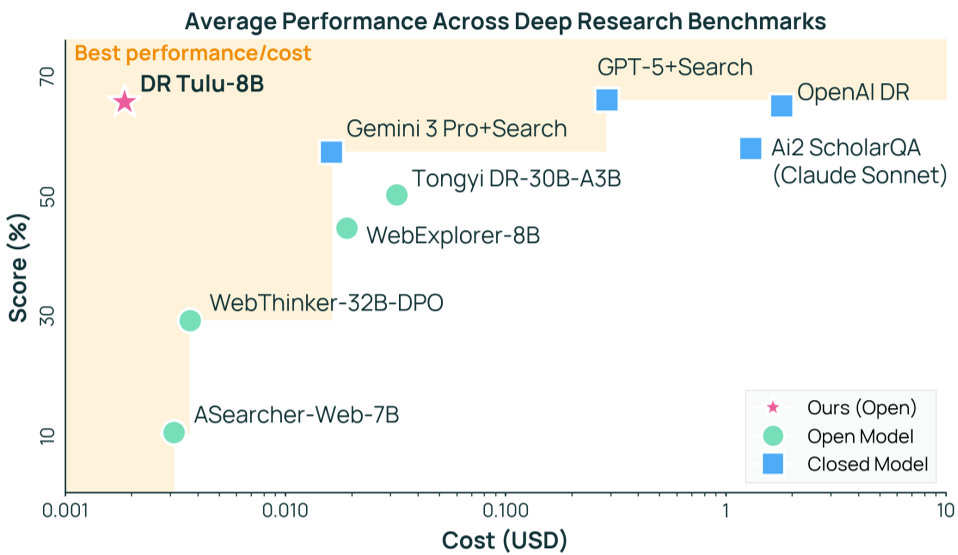
本文推出了 DR Tulu-8B,这是首个专为长文本深度调研(Deep Research)任务训练的全开源模型。该模型基于 Qwen3-8B,提出了动态演化细则强化学习(RLER)方法,并在多个 Benchmark 上超越了包括 OpenAI Deep Research 在内的闭源 SOTA 系统,且推理成本降低了 1000 倍。
TL;DR
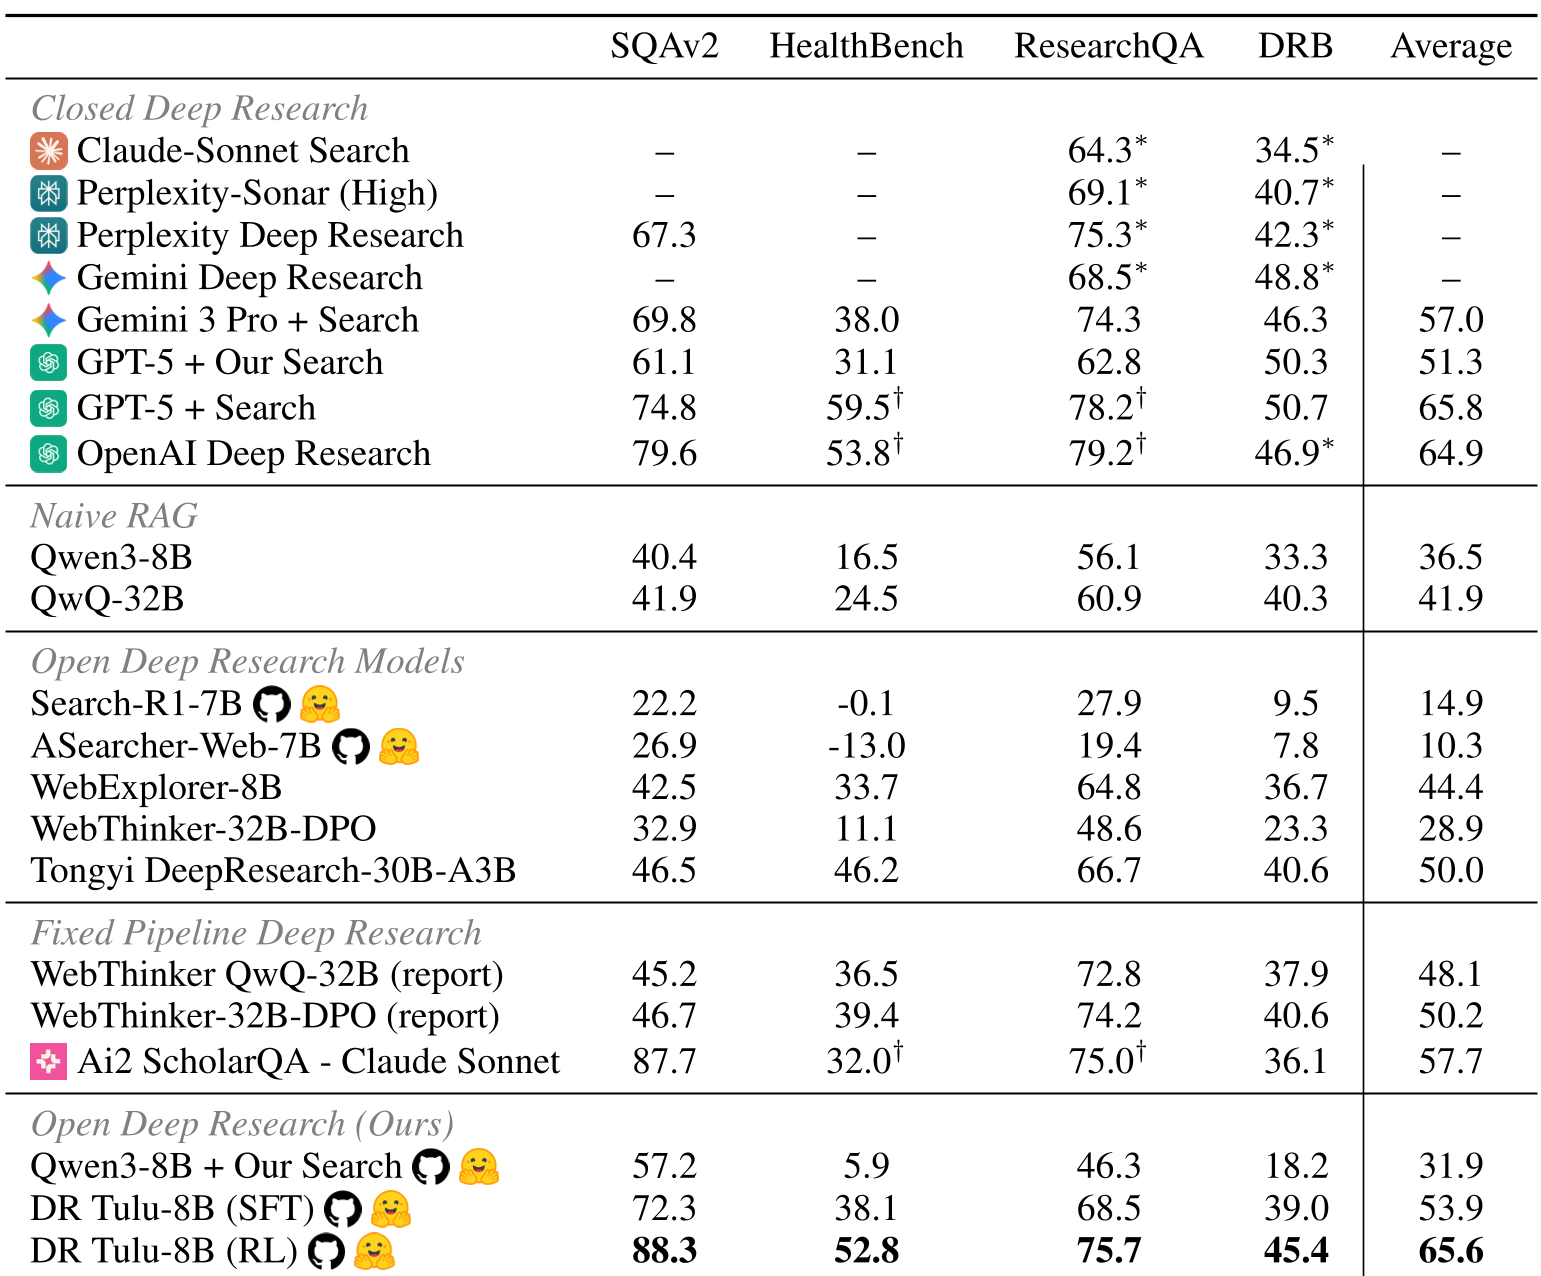
传统的深度调研(Deep Research)模型要么依赖数千亿参数的闭源黑盒,要么在长文本调研中表现乏力。DR Tulu-8B 打破了这一僵局。通过引入动态演化细则强化学习(RLER),这个仅有 80 亿参数的开源模型不仅在四个主流调研榜单中超越了众多的 30B+ 模型,甚至在性能上与 OpenAI 的深度调研系统旗鼓相当,而成本却极低。
1. 痛点深挖:静态奖励的“见木不见林”
当前的深度调研 Agent 面临两个核心瓶颈:
- 验证鸿沟:短文本任务(如数学或代码)可以通过编译器或标准答案轻松验证。但对于“综述 RAG 领域的最新进展”这种开放式任务,没有标准答案,静态的评分标准往往由于缺乏实时知识而变得模糊。
- 知识滞后:由于模型的参数知识有限,如果它在调研过程中搜到了其知识库之外的新证据,传统的 Reward Model 可能无法识别其价值,甚至会偏袒那些看似专业实则陈旧的回答。
2. RLER 机制:让评分标准与模型共同进化
作者提出了 RLER (Reinforcement Learning with Evolving Rubrics)。其核心逻辑在于:验证者的水平必须能够随着被验证者的进步而提升。
核心架构:
- 特权信息引入:在训练阶段,利用模型生成的多个 Search Trace 和 Response,结合外部实时搜索结果,作为“特权信息”提供给 Rubric 生成器。
- 动态缓冲区管理:系统会持续生成“正面细则”(捕获模型新探索的高质量知识)和“负面细则”(针对发现的作弊行为)。通过方差分析对这些细则进行排名和剪枝,保留最具区分度的 K 个准则。
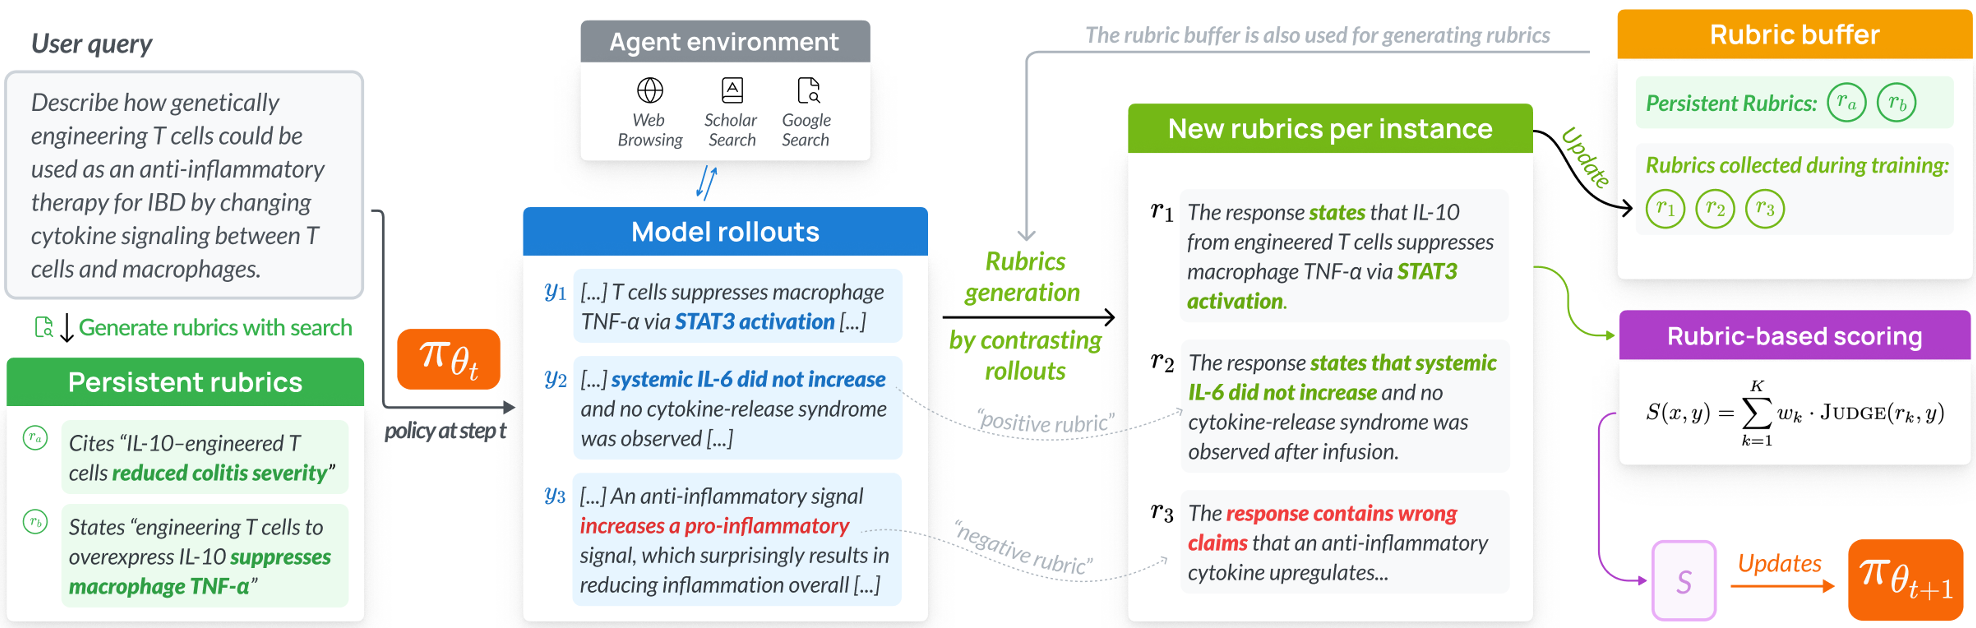
这种“共同进化”的直觉在于:随着模型的变强,简单的准则已无法区分伯仲。RLER 通过动态生成的、 grounded 在搜索结果上的细则,为模型提供了极细粒度的 Feedback。
3. 实验战绩:全方位的跨越
DR Tulu-8B 的表现是惊人的。在衡量科学文献合成能力的 SQAv2 榜单上,它的表现如下:
- 平均分 65.6:领先最强开源 baseline (Tongyi DR-30B) 15 个百分点以上。
- 成本优势:每条查询的推理成本仅为 1.80,实现了约 1000 倍的降幅。
特色能力:Snippet 级精准引用
不同于许多只给 URL 的模型,DR Tulu 能精准标注到 Snippet 级别的引用。在针对“致病基因变异研究”的 GeneticDiseasesQA 特色测试中,它展现了极高的循证医学素养,这得益于其训练中独特的 Citation Reward 设计。
4. 深度洞察:为什么 8B 能赢?
- 自适应工具调用:DR Tulu 不是死板地执行搜索流水线。它能根据领域自动选择工具。通过消融实验可以发现,它在解决科学问题时 90% 的时间会调用 Paper Search,而在通用领域则转向网页搜索。
- SFT 的“冷启动”:通过多阶段训练,先在高质量、通过拒绝采样筛选出的轨迹上进行 SFT,为后续的 RL 阶段提供了良好的行动基准(Policy Prior)。
- 引用奖励的纠偏:RLER 解决了模型为了高分而盲目堆叠引用或断章取义的问题。
5. 局限性与展望
尽管 DR Tulu 在多个维度都达到了 SOTA,但作者也指出:训练时的奖励提升并不总是线性等同于评测端的性能提升(Train-Test Mismatch)。未来,如何让 Rubric 能够更好地对齐人类专家的深层偏好,以及如何将这种架构扩展到处理多模态证据(如医学图像、分子结构),将是深度调研领域的关键战场。
总结:DR Tulu-8B 的开源不仅提供了一个高性能的模型,更提供了一套完整的、基于 dr-agent-lib 的深度调研训练基建。它向我们证明,高效的训练策略(RLER)比单纯堆砌参数规模更能触达 AI 认知的深度。