
Dual-View Training:极性反向法——让检索模型真正“听懂”复杂指令
Dual-View Training for Instruction-Following Information Retrieval
本文提出了 Dual-View (DV) 训练策略,专门用于提升信息检索 (IR) 系统的指令遵循能力。该方法通过 LLM 自动生成“极性反向”的合成指令,使原本的相关文档与负样本在逻辑上互换身份,从而在 305M 规模的 Encoder 上实现了 FollowIR 评测基准 45% 的性能提升。
TL;DR
传统的检索模型往往是“关键词复读机”,虽然语义匹配做得好,但经常无视用户的具体约束(如“排除特定年份”、“限定专业背景”)。本文提出了 Dual-View (DV) 训练策略,通过 LLM 生成“极性反向”的指令,让同一个文档对在不同指令下交替互换“正负极”。这种方法显著增强了模型对指令细节的敏感度,在 FollowIR 基准上将 305M 小模型的表现提升了 45%,甚至绝杀了许多参数量数倍于它的 SOTA 模型。
痛点深挖:语义相关性 ≠ 指令相关性
在当前的学术界,Dense Retriever 的语义匹配能力已经达到巅峰,但它们都有一个共同的弱点:Instruction-Agnostic(指令迟钝)。
想象这样一个场景:
- Query: "如何通过锻炼减肥?"
- 指令 A: "侧重高强度间歇训练 (HIIT),排除瑜伽内容。"
- 指令 B: "侧重柔顺性训练和瑜伽,排除剧烈运动。"
现有的模型往往只看到“减肥”和“锻炼”,然后把所有相关的文档一股脑抛出来,无法区分该文档到底符合指令 A 还是指令 B。前人的工作虽然通过向训练集加入“指令负样本”有所改观,但这些负样本就像是死板的教条,模型只是记住了“这个不对”,并没有理解“为什么在这个指令下它不对,而在另一个指令下它对”。
核心算法:Dual-View (DV) 极性反向策略
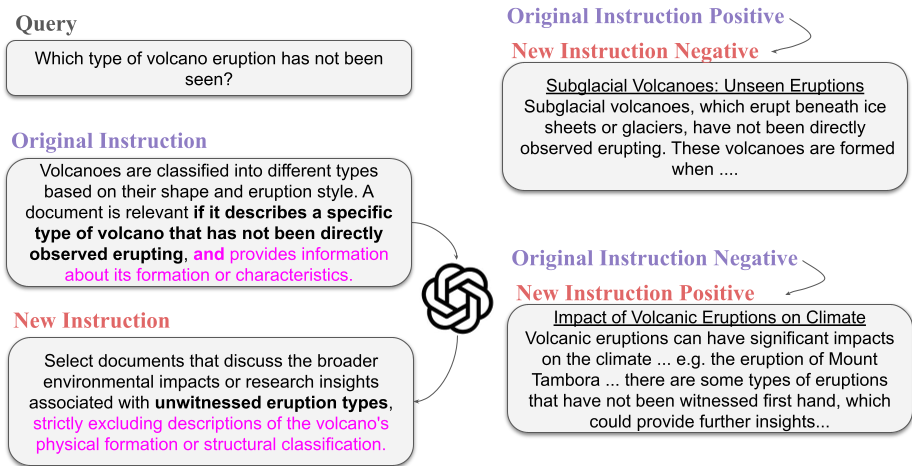
作者的直觉(Insight)非常深刻:一个违反当前指令的“指令负样本”,本质上是另一个潜在指令下的“完美正样本”。
1. 架构逻辑
模型不再只是简单地学习 (Query + Instruction, Positive_Doc),而是成对地学习:
- View 1 (Original): 指令 下, 是宝, 是草。
- View 2 (Reversed): 系统通过 LLM 生成一个互补指令 ,使得 变成宝, 变成草。
这种“双视图”在同一个训练 Batch 中出现,给模型施加了极大的约束:模型必须通过识别指令中的微小差异(如范围、地理、时间、格式等)来调整 Embedding 向量,否则无法同时满足两个方向完全相反的对比目标。
2. LLM 合成咒语
为了生成高质量的 ,作者使用 Qwen3-Next-80B 配合精心设计的 Prompt。生成的指令必须满足:1) 逻辑自洽;2) 能够精准剔除原先的正样本;3) 包含硬性的、客观的限制(如“仅限代码实现”、“排除主要首都”等)。
实验战果:小模型实现大幅跨越
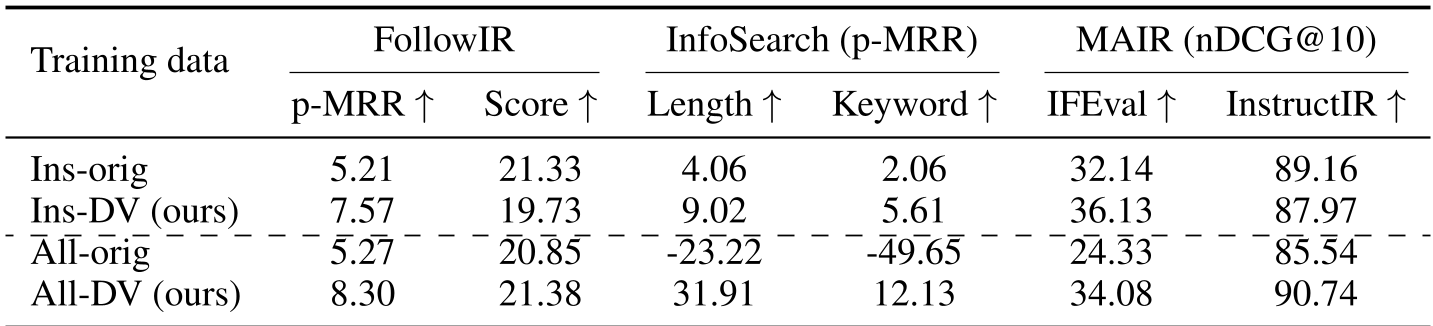
作者使用了 gte-multilingual-base (305M) 和 bge-m3-retromae 作为 Backbone 进行验证。
- 性能暴涨:在 FollowIR p-MRR 上,即便不增加数据量,仅通过 DV 合成替换一半原始数据,性能就提升了 45%。
- 超越大规模模型:305M 参数的模型在指令遵循能力上超过了 600M 甚至更大的 EmbeddingGemma-300M 或 Qwen3-Embedding 系列。
- 解决“训练灾难”:实验发现,如果简单地混合普通检索数据(非指令数据),模型的指令遵循能力会发生崩塌(Catastrophe)。而 Dual-View 训练由于在每一对数据中都锚定了指令信号,有效地抵抗了这种信号稀释。
深度洞察:指令敏感性的“脆性”
这篇论文最深刻的观点在于对 梯度干扰 的讨论。作者认为,指令敏感性(Instruction Sensitivity)不是一种随着模型规模增大就自然涌现的能力,而是一种“脆弱”的属性。
在混合训练中,非指令数据提供的梯度会奖励那些只看 Query-Document 关联的参数,这种巨大的噪声会掩盖掉细微的指令信号。Dual-View 的价值在于它提供了一种“高纯度”的监督,强迫梯度始终朝着“指令感知”的方向更新。
总结与局限
Takeaway:
- 构建指令检索模型,信号的纯度优于数据的规模。
- 极性反向是一种极其高效的数据增强思想,能让模型在 Latent Space 中对指令边界进行更精细的切分。
局限性: 该方法依赖于 LLM 生成互补指令的质量。对于某些极度垂直或语义范围极窄的查询,LLM 可能难以找到自然的、反向的指令视角。此外,该工作目前集中在 Encoder-based 架构,未来在 Decoder-only 架构上的表现值得期待。
本文由资深学术技术主编重构。