
DVPO:精细化价值分布建模,突破 LLM 后训练的噪声瓶颈
DVPO: Distributional Value Modeling-based Policy Optimization for LLM Post-Training
本文提出了 DVPO(Distributional Value Modeling with Risk-aware Policy Optimization),一种专为 LLM 后训练设计的鲁棒强化学习框架。该方法通过引入分布回归值模型(Distributional Value Modeling)和非对称风险约束,显著提升了模型在带有噪声的监督信号(如奖励模型误差)下的性能,在多轮对话、数学推理和科学 QA 任务中全面超越了 PPO 和 GRPO。
TL;DR
在 LLM 的后训练(Post-training)阶段,由于奖励模型(RM)并非完美,训练信号中总是充斥着“噪声”。复旦大学研究团队提出的 DVPO 通过将传统的标量价值函数升级为 分布式价值模型,配合独特的非对称风险控制(收缩下尾、扩张上尾),在不牺牲模型泛化能力的前提下,极大地增强了对奖励噪声的免疫力,在对话、数学、科学三大领域均取得 SOTA 表现。
1. 痛点:被噪声“带偏”的训练
在 RLHF 过程中,我们依赖奖励模型或规则来给回复打分。然而,现实是残酷的:
- PPO/GRPO 的局限:这些方法主要关注期望(Mean),在遇到错误的极端高分或低分(噪声)时,容易产生极大的方差,导致策略收敛到错误的分布。
- Robust Bellman 的极左/保守:虽然有些方法尝试做最坏情况优化(Worst-case Optimization),但这种“悲观主义”会导致模型由于怕犯错而变得过于保守,严重限制了在未见过(OOD)场景下的泛化。
核心直觉(Insight):单纯看均值是不够的,我们需要看到奖励的全景分布。
2. 核心架构:DVPO 的分布式魔法
DVPO 不再只输出一个分数值,而是输出一个分位数分布(Quantile Distribution)。
2.1 分数不再是孤点,而是分布
DVPO 采用多头分位数集成(Multi-headed Quantile Ensemble)来拟合价值。这种设计让 Critic 能够捕捉到价值的不确定性、方差乃至多峰性。
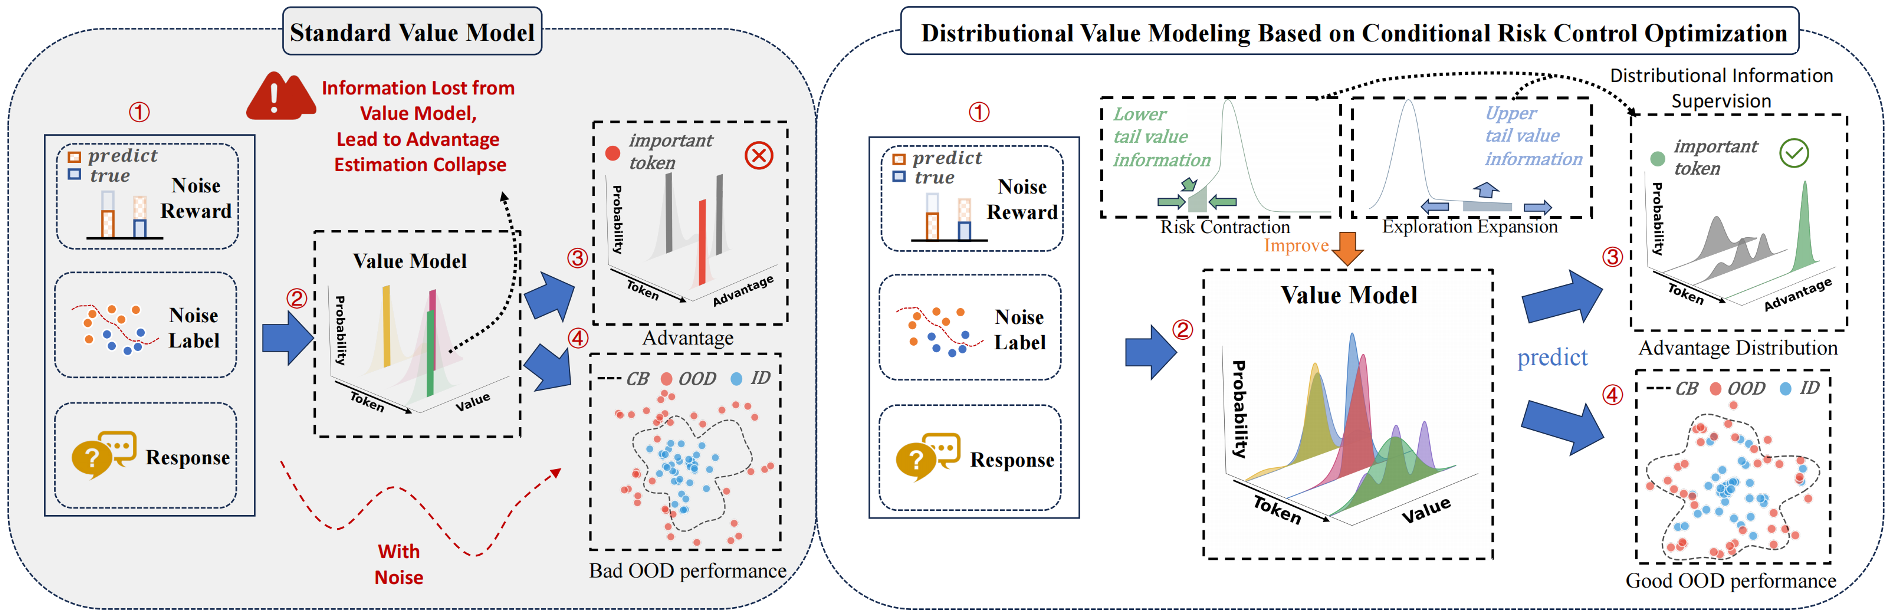 图 1:标准价值模型 vs DVPO。标准模型易受偏见影响,而 DVPO 通过下尾风险收缩和上尾探索扩张来保持平衡。
2.2 非对称风险约束:稳中求进
这是本文最精妙的数学推导。作者基于条件风险理论,对分布的“尾巴”做了不同的手术:
- 下尾收缩():如果低分区域的方差太大,说明噪声过多,强行将其收缩。这对应了“防范最坏情况”。
- 上尾扩张():允许高分区域保持一定的方差。这对应了“保持探索欲望”,确保模型在看到高价值潜力时不会被强行压抑,从而保证了 OOD 泛化性能。
3. 实验验证:不仅稳,而且准
3.1 跨领域全面超越
在数学推理(MATH500)和科学 QA(GPQA)等任务中,DVPO 显示出了压倒性的稳定性。
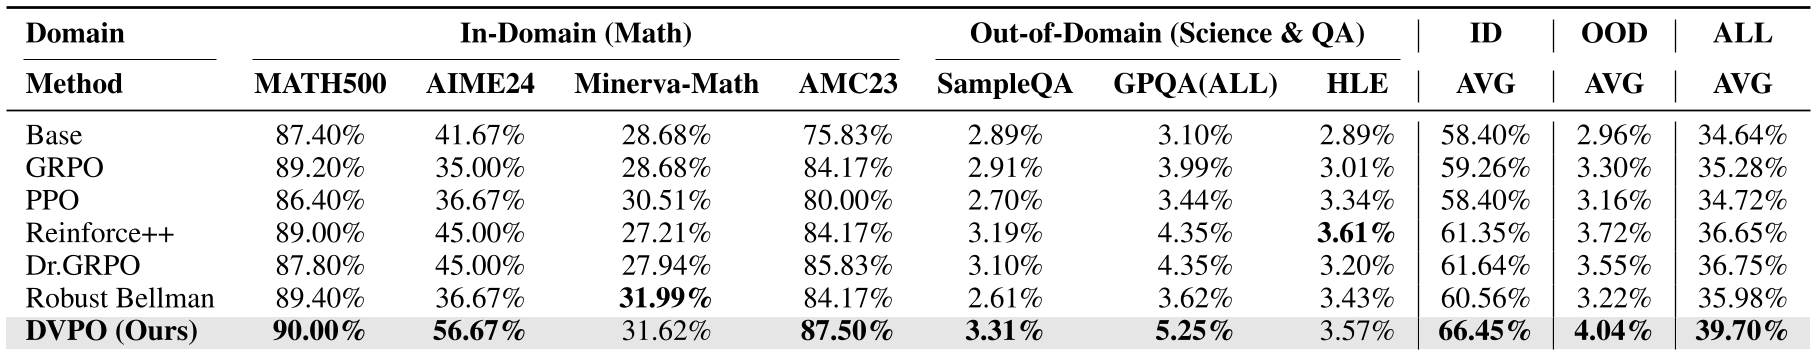 图 2:跨领域性能对比。DVPO (Ours) 在 In-Domain 和 Out-of-Domain (OOD) 表现均稳居第一。
3.2 显微镜下的优势估计
DVPO 的另一个神奇之处在于它能提供**细粒度(Token-level)**的精准指导。 在处理关于核物理的问题时,DVPO 能够精准地识别出“nucleus”和“quarks”这种核心词汇的优势(Advantage),而传统的 PPO 分布则显得模糊不清。
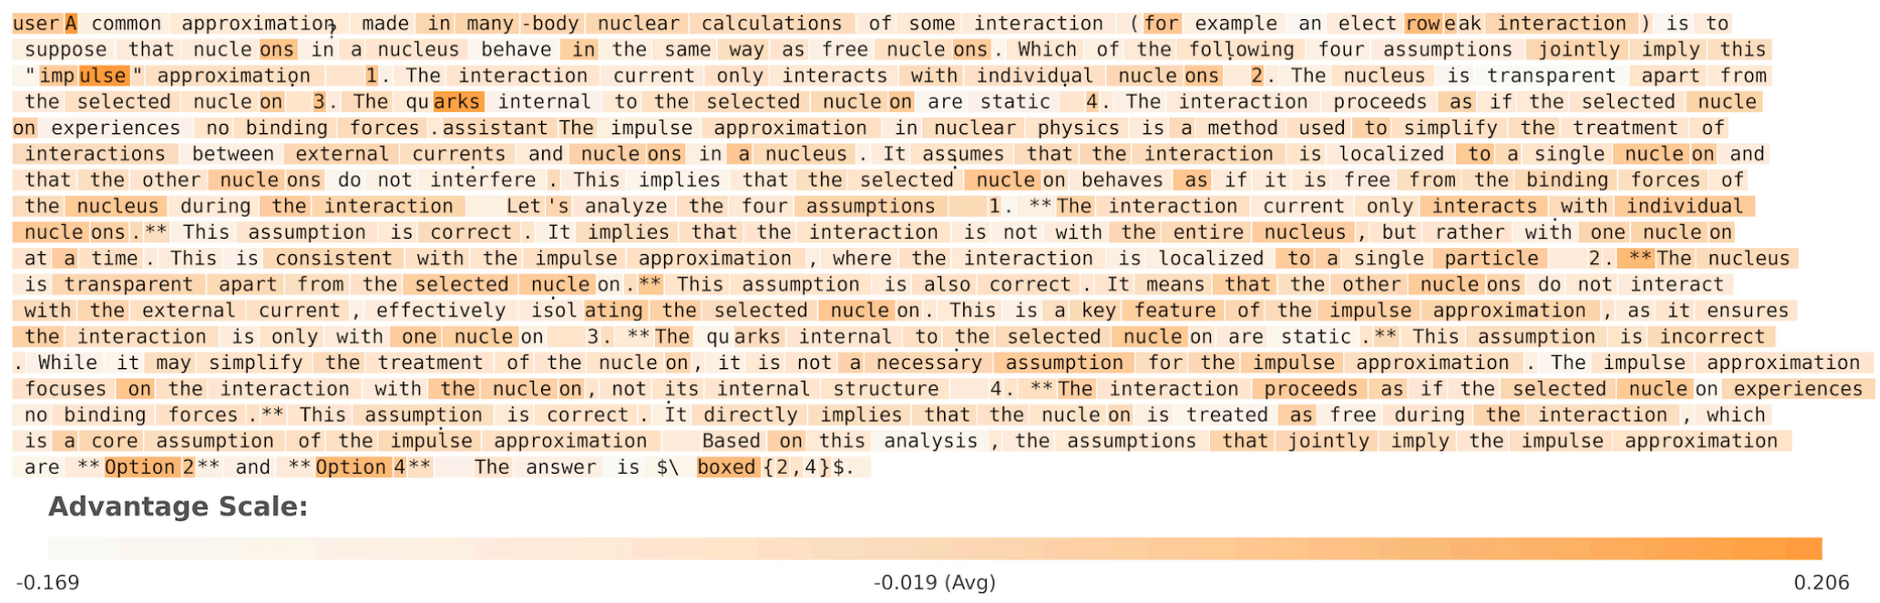 图 3:优势估计可视化。DVPO 能精准捕获关键语义词的权值。
4. 深度洞察:为什么这很重要?
DVPO 的成功实际上是在数学上实现了一个**“鲁棒”与“泛化”的动态平衡**。
- 消融实验证明:如果只做下尾收缩,模型会变得像 Robust Bellman 一样保守,训练虽然平稳但效果不佳。
- 分位数密度的选择:作者发现,将分布划分为 200 个区间(Intervals)是最佳的,太少(如 50)信息丢失严重,太多(如 500)则会导致模型过度拟合局部的噪声碎屑。
总结
DVPO 为 LLM 面对不完美奖励时的对齐提供了一套全新的工具箱。它告诉我们,与其努力去消除 RM 的噪声,不如让模型获得“理解噪声分布”的能力。通过非对称的风险控制,LLM 可以在充满不确定性的现实环境中,依然保持坚韧的性能输出。
局限性:分布式建模会带来额外的计算开销(分位数头),且风险阈值等超参数在不同领域可能需要单独微调。未来的研究可能会进一步探索如何自适应地调整这些分布约束。