
DAGCD:解锁注意力信号,单次解码破解 LLM 上下文幻觉
Dynamic Attention-Guided Context Decoding for Mitigating Context Faithfulness Hallucinations in Large Language Models
本文提出了动态注意力引导上下文解码 (DAGCD),这是一种用于减轻大语言模型 (LLM) 上下文忠实度幻觉的轻量级框架。该方法通过结合注意力分布信号与 token 级不确定性,动态调整解码分布,在不增加额外计算次数的前提下显著提升了模型在 RAG 任务中的表现。
TL;DR
大语言模型在检索增强生成 (RAG) 场景中常会出现“睁眼说瞎话”的情况——即使检索内容包含正确答案,模型也会因内部不确定性而生成偏离上下文的信息。平安科技与成电的研究者提出了 Dynamic Attention-Guided Context Decoding (DAGCD),通过挖掘模型内部注意力头的“利用信号”,在单次解码过程中动态放大上下文相关的 Token 权重。该方法在 Mistral 和 LLaMA 家族上均实现了显著的忠实度提升,且基本不增加推理延迟。
痛点深挖:模型是真的“没看到”答案吗?
传统的幻觉研究多关注模型事实性错误,但在 RAG 场景下,上下文忠实度幻觉 (Context Faithfulness Hallucinations) 才是痛点。
作者通过深入分析发现两个关键洞察:
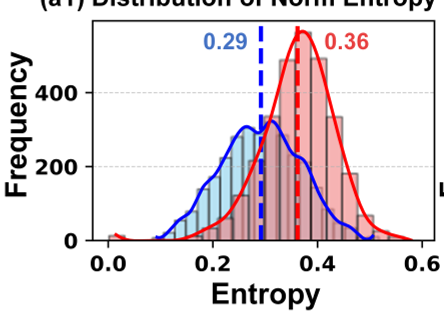
- 不确定性陷阱:错误的回答通常伴随着更高的 Token 级归一化熵 (NE)。
- “近在咫尺”的答案:在模型回答错误的案例中,多达 66% 的情况下正确答案其实就在生成概率的前 10 名。
这表明模型并非没有捕捉到信息,而是在最后的排序决策中,正确的上下文信息被噪声或内部预训练偏见掩盖了。
方法论详解:从注意力中“提取”忠实度
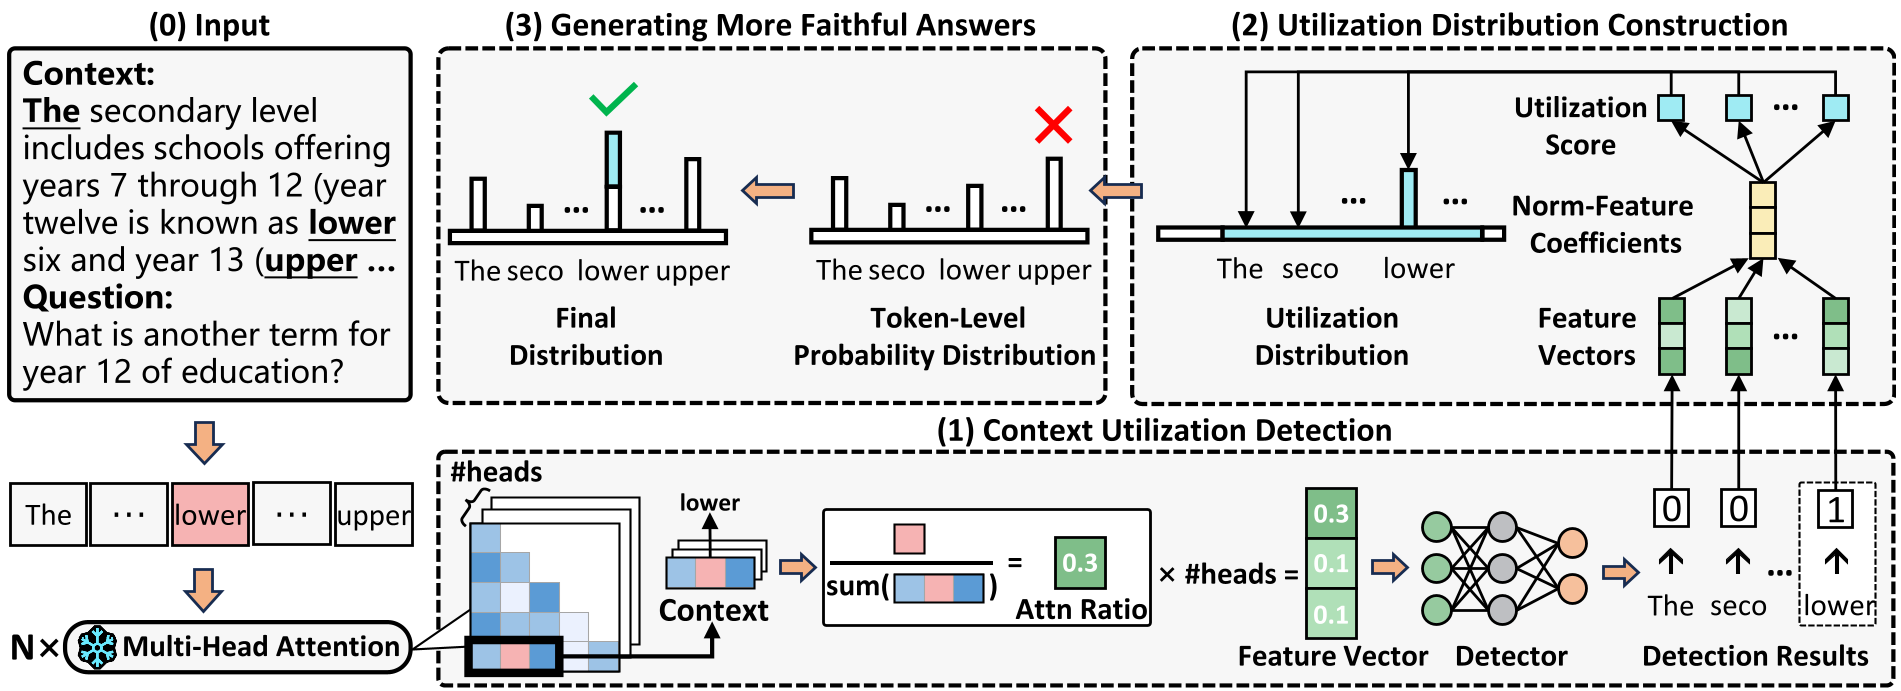
作者提出了一个假设:Transformer 的注意力机制本身就编码了上下文利用的信号。 为了验证这一点,他们甚至训了一个极其轻量级的 Logistic Regression 分类器。
1. 核心特征:注意力比例 (Attention Ratio)
由于“注意力沉没 (Attention Sink)”效应,原始注意力权重往往存在噪声。DAGCD 引入了 Attention Ratio,计算特定 token 接收到的注意力相对于整个上下文总注意力的比例。
2. 动态解码流程
DAGCD 的流程分为三步:
- 探测 (Detection):通过选定的 Top-K 关键注意力头实时判断当前步是否在利用上下文。
- 构建利用分布 (Distribution Construction):根据注意力贡献度计算上下文 Token 的得分。
- 加权调整 (Adjustment):使用公式 修正原始概率分布。这里 是基于不确定性的缩放因子,实现“越迷茫时,越参考上下文”。
实验战绩:全线飘红的性能提升
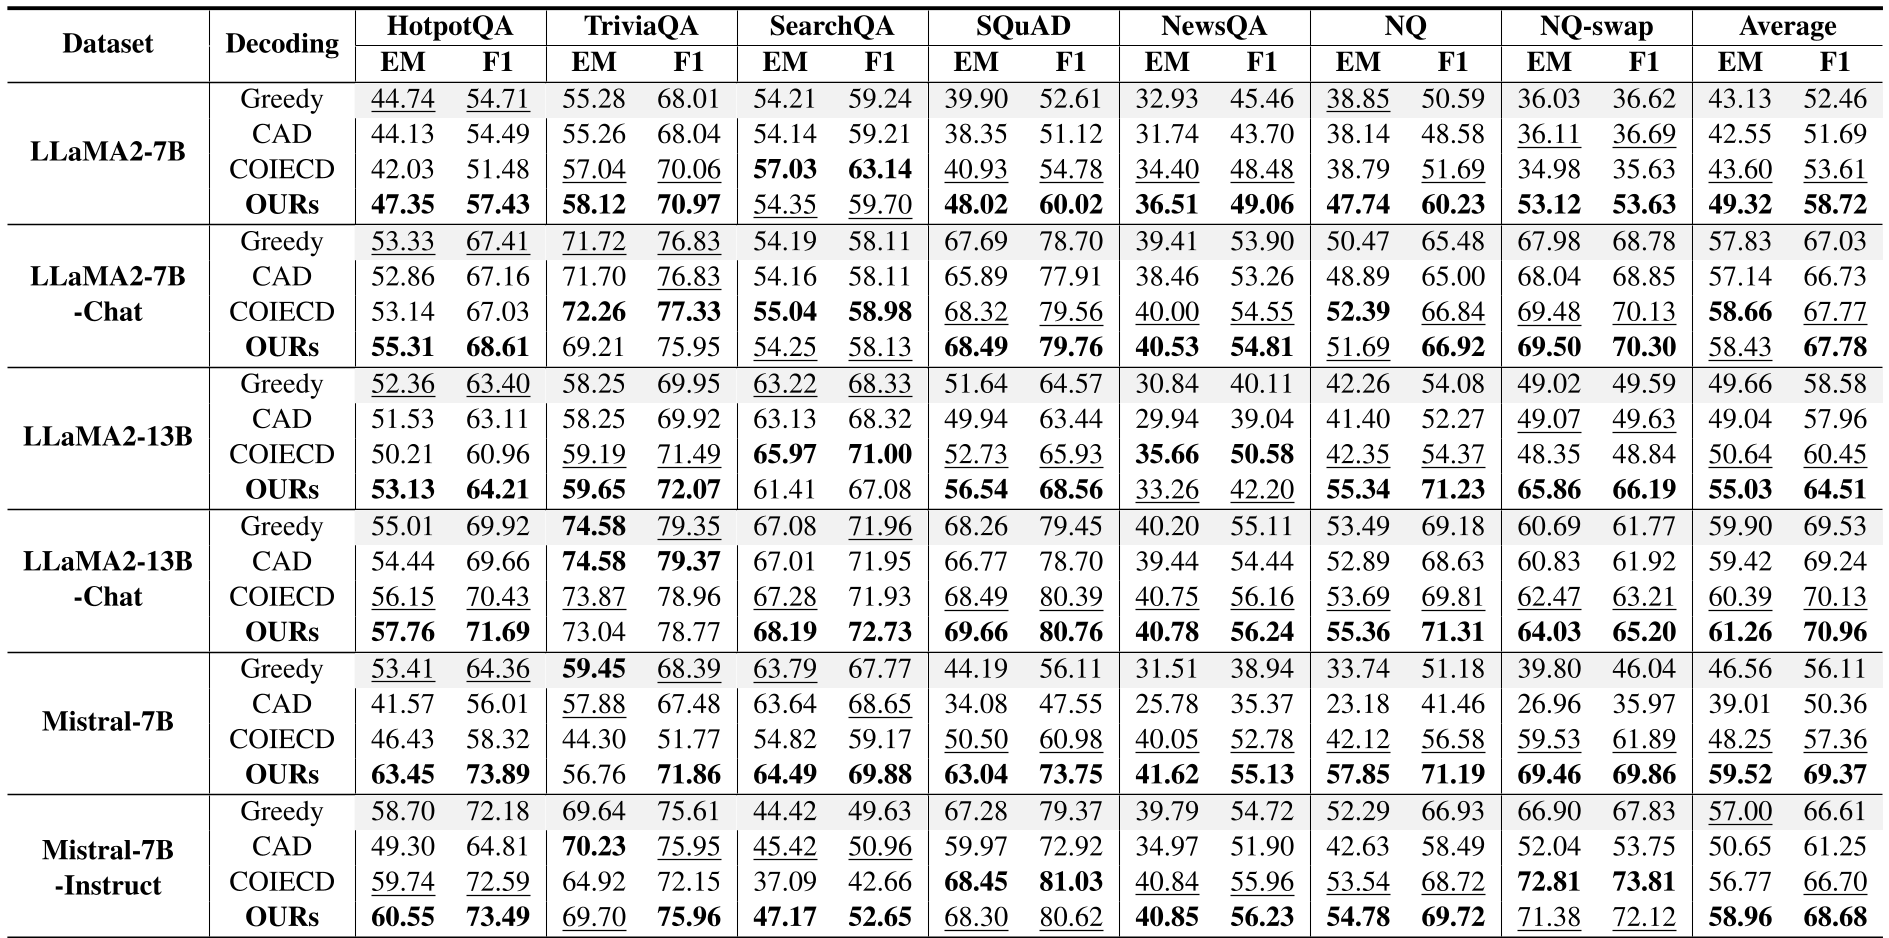
在 HotpotQA、TriviaQA 等 7 个 QA 数据集上的实验显示,DAGCD 几乎在所有基准测试中都优于 CAD 和 COIECD 等现有方法。
- 架构通用性:在 LLaMA2-7B/13B 和 Mistral-7B 上表现稳健。
- 极致增强:在 Mistral-7B 上,相比 Greedy Decoding,在 NQ 数据集上的 EM 显著提升。
- 对抗鲁棒性:在 NQ-Swap(实体被恶意替换的对抗集)中,DAGCD 的表现远超基线,证明了其识别真正上下文的能力。
深度洞察:为什么选择注意力?
相比于 CAD 需要两次推理(带上下文和不带上下文)对比概率,DAGCD 的优势在于原生性。它不需要修改模型权重,也不需要额外的解码 Pass,而是直接利用推理时的中间产物。
作者在消融实验中发现,仅用 100 个样本 训练出的 LR 分类器就能在线上获得 0.99 的 AUC。这意味着“模型是否在使用上下文”这一逻辑在 LLM 的内部表示中是非常线性且易于捕捉的。
总结与局限性
DAGCD 为 RAG 系统的可靠性提供了一个高效的底层方案。
- 优点:轻量、无需重新训练、可解释性强(可以追溯到哪个注意力头在起作用)。
- 挑战:缩放因子 仍需根据不同模型手工调节,且在极长文本或高噪声对话环境下的分类器稳健性仍有待进一步验证。
这项工作启示我们,缓解幻觉的关键或许不在于增加更多的外部约束,而在于更好地倾听模型内部已经发出的“信号”。