
YODA:按需扩散——突破超分辨率模型的效率与画质瓶颈
Dynamic Attention-Guided Diffusion for Image Super-Resolution
本文提出了 YODA (You Only Diffuse Areas),一种针对图像超分辨率(SR)的动态注意力引导扩散模型。该方法通过 DINO 提取低分辨率图像的注意力图,并在反向扩散过程中采用随时间步骤动态扩展的掩码(Mask),使模型重点修复细节丰富的显著区域,在 face SR 和 general SR 任务中均达到 SOTA 性能。
TL;DR
本文提出了一种名为 YODA (You Only Diffuse Areas) 的即插即用框架,它挑战了扩散模型“平等对待所有像素”的传统做法。通过 DINO 注意力引导,YODA 实现了时间相关的动态掩码扩散,不仅显著提升了人脸及通用场景超分辨率的感知质量(SOTA),还奇迹般地解决了模型在小 Batch Size 训练时的颜色偏移(Color Shift)难题。
背景定位
目前扩散模型(Diffusion Models)已成为图像超分辨率(SR)的领跑者。然而,作者敏锐地发现:我们真的需要在每一个时间步更新整张图片吗? 答案是否定的。对于背景平整、纹理简单的区域,过度扩散反而会引入伪影;而对于眼睛、发丝等细节区域,则需要高强度的迭代重构。
痛点深挖:为何“一视同仁”不可取?
- 计算浪费与伪影:由于 SR 任务本身是病态问题,在简单区域(如单色背景)强行进行高频幻觉生成,极易产生非自然的纹理扭曲。
- 颜色偏移(Color Shift):许多高性能扩散模型(如 SR3)对 Batch Size 极其敏感。在硬件资源受限(如单卡)时,减小 Batch Size 会导致生成的图像色调与原图产生剧烈偏差。
核心内容:YODA 的三大支柱
1. 识别核心区域 (Identifying Key Regions)
作者利用自监督学习模型 DINO 的 Self-attention Maps 作为“重要性指南”。由于 DINO 能够很好地捕捉物体边界和场景布局,这些 Map 天然地指向了人类视觉更关注的细节区域。
2. 时间相关的动态掩蔽 (Time-Dependent Masking)
这是 YODA 的灵魂。作者设计了一个随扩散步长 变化的函数 :
- 初期( 较大时):只在注意力极高的核心区域进行扩散。
- 后期():掩码逐渐扩大,直至覆盖全图。 这意味着:细节丰富的区域接受了 100% 的迭代次数,而背景区域只接受了一定比例(由下限 决定)的精炼。
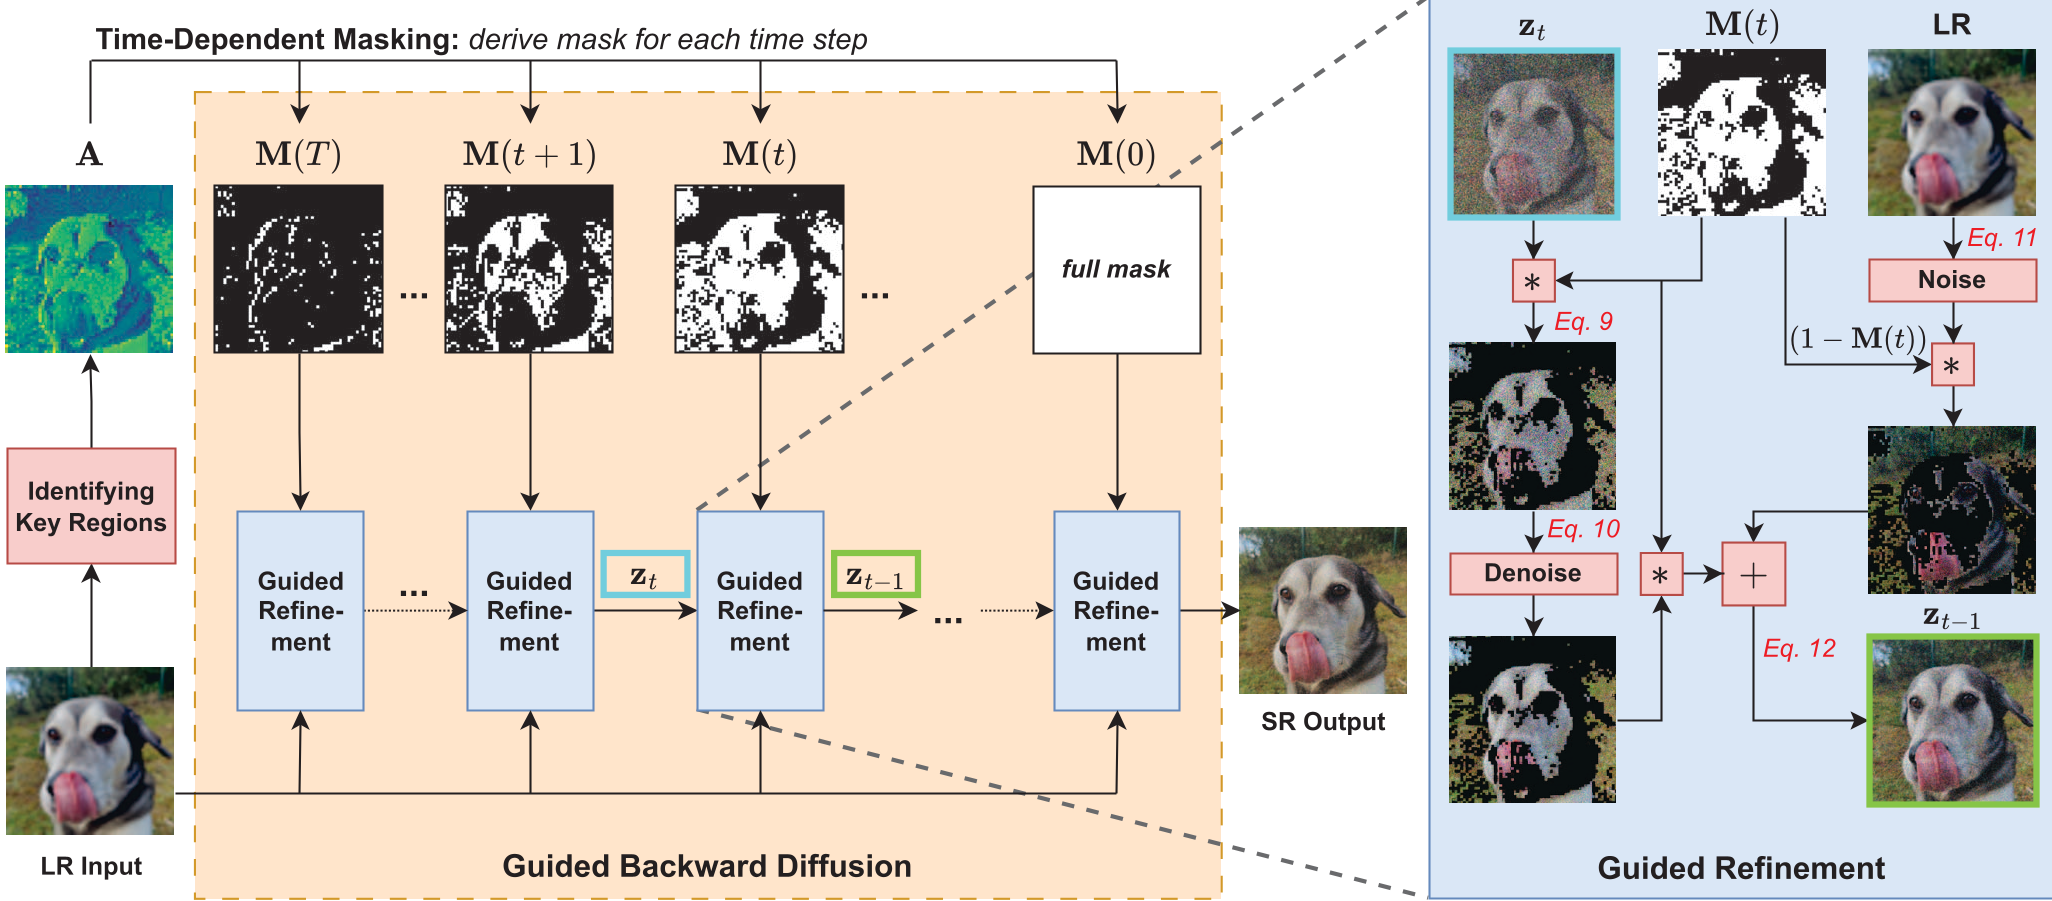
3. 引导反向扩散 (Guided Backward Diffusion)
在每一步迭代中,YODA 将当前生成的 SR 部分与保留噪声水平的 LR 部分进行融合。公式表达为: 这种设计确保了图像在不同精炼程度的区域之间能够平滑衔接。
实验与结果:不仅是画质,更是稳定性
SOTA 对比
在 CelebA-HQ 脸部超分辨率实验中,YODA 展现了压倒性的优势。特别是在 8x 缩放下,接入 YODA 的 SR3 模型不仅指标大幅超越原版,更在色彩还原度上实现了质变。
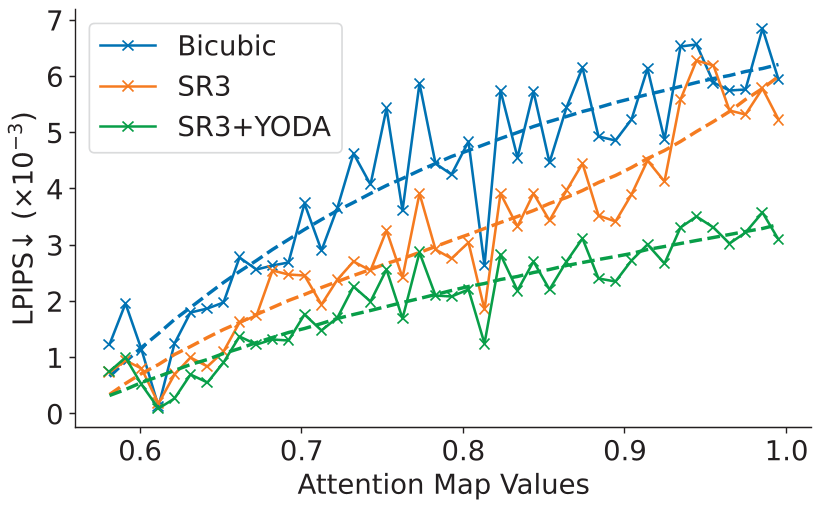 上图清晰显示:原版 SR3(图 4c/g)出现了严重的色彩偏黄,而 SR3+YODA(图 4d/h)完美还原了肤色,且保留了极致的毛孔与发丝纹理。
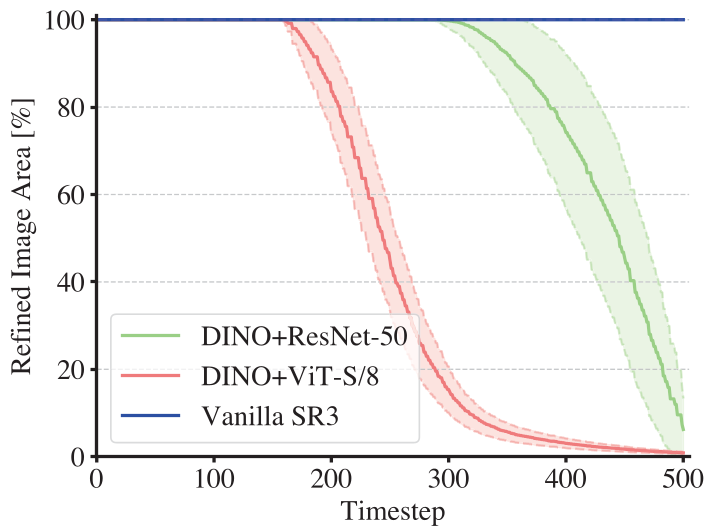
自适应像素更新
实验证明,不同的特征提取器(Backbone)对 YODA 的表现有显著影响。使用 ResNet-50 的 DINO 模型比 ViT 具有更好的“进度条”管理能力,能更快地从核心区域过渡到全图。
深度洞察与总结
为什么 YODA 这么有效?
- 引入了先验归纳偏置:通过锁定 LR 图像中的简单区域,大大缩小了扩散模型的搜索空间。
- 训练稳定性增强:通过掩码机制,模型在训练时不必在每一个步长都“分心”去学习如何处理背景,这对于小 Batch Size 极其友好,因为它减少了梯度更新时的噪声。
局限性: 该方法目前高度依赖 DINO 的显著性估计准确性。如果 DINO 漏掉了某些关键区域,这些区域可能得不到充分的精炼。此外,DINO 的输入分辨率限制也可能是处理超特大图时的瓶颈。
展望未来: YODA 为扩散模型的“局部化处理”打开了大门。未来的研究可以探索更轻量级的显著性检测器,甚至让模型在训练过程中自发地学习“哪里需要更多关注”,从而实现真正的资源分配自动化。