
动态近优:在线线性规划的价格学习新范式
A dynamic near-optimal algorithm for online linear programming
本文提出了一种用于解决在线线性规划 (Online LP) 问题的动态近优算法。该方法在随机到达顺序假设下,通过几何级数的时间间隔动态更新双偶价格(Dual Prices)作为决策阈值,实现了 1-O(ε) 的竞争比(Competitive Ratio)。
TL;DR
本文由 Shipra Agrawal、Zizhuo Wang 及叶荫宇(Yinyu Ye)共同完成,针对在线线性规划 (Online Linear Programming) 这一经典难题提出了一种基于动态对偶价格学习的算法。该算法无需预知数据分布,仅需随机到达假设,即可达到 1-O(ε) 的近优竞争比,并首次在多维场景下给出了维度影响的下界。
核心速览
在线线性规划(Online LP)是资源分配、在线匹配(如 Adwords)的核心数学模型。与其依赖复杂的随机优化或鲁棒优化,本文提出了一个极简的直觉:将对偶价格视为“由于占用资源而损失的边际机会成本”。只要我们能通过历史数据快速学习到准确的价格阈值,就能做出准最优的在线决策。
痛点深挖:为何“一次学习”不够好?
在之前的研究(如 Devanur & Hayes, 2009)中,通常采用“一次性学习”策略:先观测前 εn 个数据,算出一个价格向量 ,然后一直用到最后。 这种做法存在两个致命缺陷:
- 资源浪费:早期由于样本量少,为了保险必须预留大量缓冲区,导致收益受损。
- 精度受限:随着时间推移,早期的样本无法捕捉全量数据的特征,价格偏差会由于决策累积而放大。
方法论详解:动态学习与几何步进
本文提出的 Dynamic Learning Algorithm (DLA) 改变了游戏规则。其核心流程如下:
1. 动态阈值更新
算法在时间 时刻触发更新。每次更新都会根据已有的全部历史数据重新求解一个子 LP 问题,获得最新的对偶价格 。
2. 带松弛的决策准则
为了防止过度消耗资源导致后期无资源可用,算法在子问题中引入了动态松弛因子 。 决策逻辑极为清晰:
- 如果当前请求的价值 (即出价高于资源的机会成本),且资源充足,则接受。
- 否则,拒绝。
(建议插入原文 Algorithm DLA 的伪代码步骤图)
实验与结果:打破性能瓶颈
通过严密的数学证明,作者展示了该算法在随机排列模型(Random Permutation Model)下的优越性。
关键战绩:
- 竞争比提升:在资源容量 较大时,性能极其接近离线最优解(OPT)。
- 约束满足稳定性:相比于前人需要 ,本文仅需 ,这在实际资源有限的场景下具有巨大的落地价值。
- 理论下界补充:作者通过一个精妙的构造(见下表),证明了在 m 维约束下, 的性能损耗是不可避免的。这为该领域的理论上限钉下了最后一颗钉子。
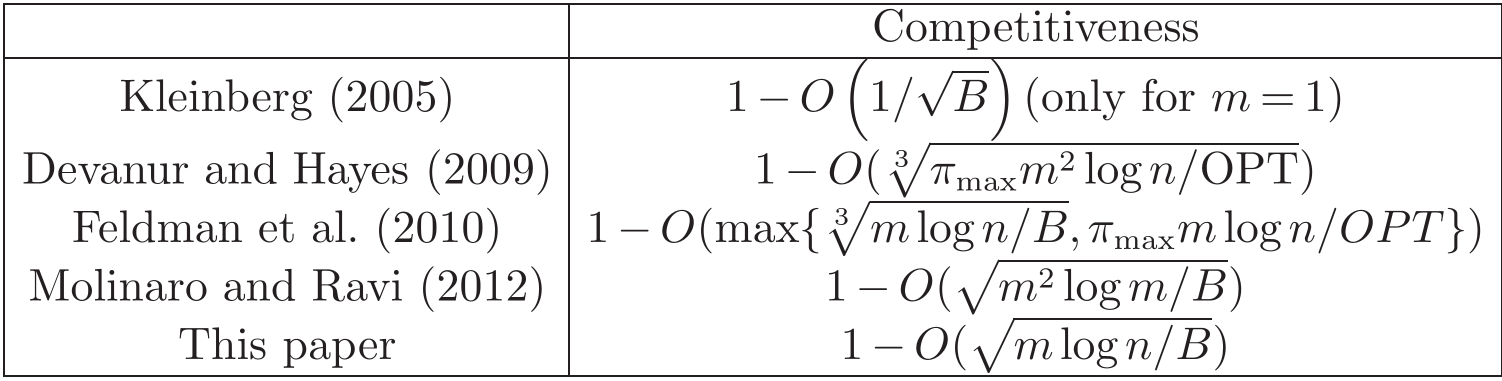 表1:不同在线算法竞争比性能对比,本文在 B 的依赖项上达到了 SOTA
深度洞察:为什么这很重要?
这篇文章最深刻的洞见在于:它揭示了“信息揭示速度”与“决策风险控制”之间的平衡点。通过几何级数(倍增)更新价格,算法既保证了学习的频率足以捕捉全局特征,又避免了频繁更新带来的计算开销和局部噪声干扰。
对于工业界,这提供了一个非常实用的操作建议:在处理如双11大促的库存分配或搜索竞价排名时,无需一开始就定死策略,每当处理量翻倍时重新校准一次价格价格,就能达到近乎完美的资源利用率。
局限性与展望
尽管算法表现优异,但它仍依赖于“总样本数 已知”或“可估计”的假设。在无限流(Infinite Stream)或 波动剧烈的场景下,如何自适应地调整步长仍是一个待攻克的课题。此外,如何将此框架扩展到非线性目标函数,也是未来值得探索的方向。
结论:本文是 Online LP 领域的里程碑式工作,不仅在算法性能上达到了理论极限,更通过对偶学习的视角为流式数据处理提供了一套优雅的解决方案。