
[EAGLE-3] 突破投机采样 Scaling Law:训练时测试与多层特征融合带来的 6.5x 加速
EAGLE-3: Scaling up Inference Acceleration of Large Language Models via Training-Time Test
本文推出了 EAGLE-3,这是一种针对大语言模型(LLM)的无损推理加速方案。通过引入“训练时测试(Training-time Test)”机制和多层特征融合,EAGLE-3 克服了前作在数据缩放上的瓶颈,在多种任务上实现了高达 6.5 倍的加速,且在 SGLang 等生产级框架中展现出卓越的吞吐量。
1. 核心速览 (Executive Summary)
TL;DR: EAGLE-3 是一次对投机采样(Speculative Sampling)架构的底层重构。它通过取消特征预测约束、引入训练时测试(Training-time Test)模拟和多层特征融合,解决了推理加速模型“随数据量增加而收益停滞”的难题。该方法在保证无损生成的同时,将 LLM 推理速度提升了 3.0x - 6.5x,在生产级框架 SGLang 中展现了极强的工业落地潜力。
背景定位:这是投机采样领域的一项里程碑工作。它不仅刷新了多项 SOTA 纪录,更重要的是,它首次揭示了推理加速器也存在 Scaling Law——只要架构设计合理,增加训练数据能持续换取更高的加速比。
2. 痛点与动机 (Problem & Motivation)
尽管主流的投机采样方法(如 EAGLE 系列)已经比传统的 Vanilla Speculative Sampling 快很多,但研究者通过实验发现了一个令人沮丧的现象:给草稿模型(Draft Model)喂更多的数据,加速效果却不再提升(如下图所示)。
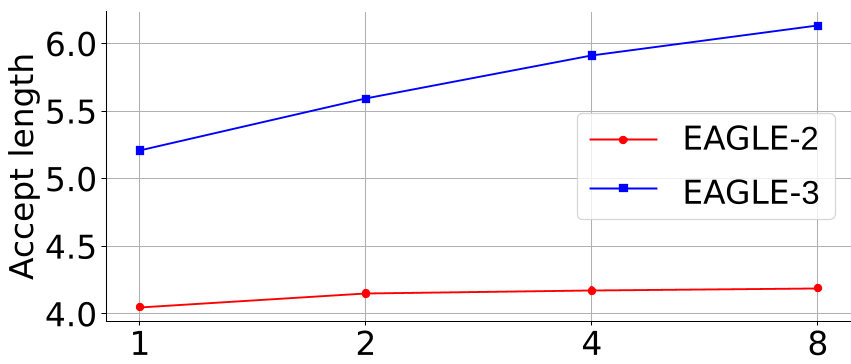 图 1:在数据量增加时,EAGLE-3 的加速比持续上升,而前作趋于平缓。
为什么前人工作会遇到瓶颈?
- 过度约束的特征预测:EAGLE 要求草箱模型去预测目标模型顶层的隐藏状态(Feature),这被证明是一个“过重”的任务,限制了模型将注意力集中在准确预测 Token 上。
- 顶层特征的局限性:只用最后一层特征进行多步预测时,误差会迅速累积。
- 训练与测试脱节:训练时使用的是真值(Ground Truth),而推理时使用的是草稿模型自身的预测值,这种 Distribution Shift 导致长序列预测崩溃。
3. 方法论详解 (Methodology)
EAGLE-3 通过以下三个维度的创新解决了上述挑战:
A. 训练时测试 (Training-time Test)
为了让草稿模型具备抗漂移能力,EAGLE-3 在训练阶段就模拟了推理过程:它将第一步生成的预测输出(而不是真值)重新反馈到模型作为第二步的输入。为了实现这一点,作者设计了特殊的 Attention Causal Masks,允许模型在单个训练步骤中并行地模拟多步自回归过程。
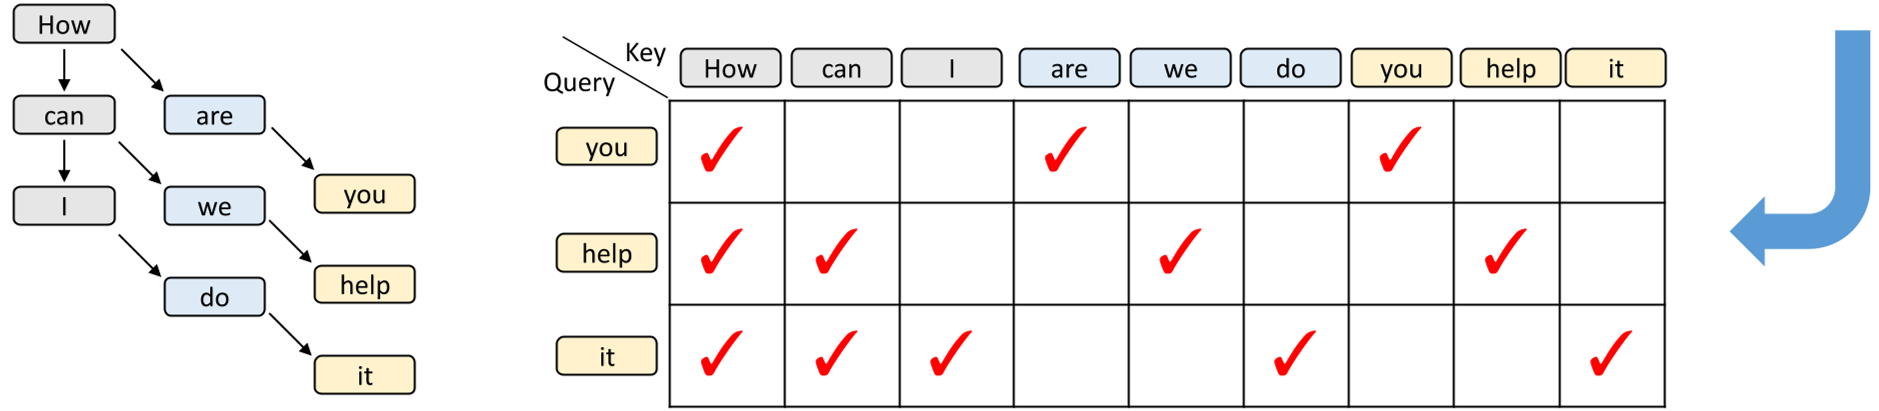 图 2:训练时模拟多步预测的注意力机制设计。
B. 多层特征融合 (Multi-layer Feature Fusion)
EAGLE-3 不再只看目标模型的“最后一层”,而是将低层、中层和高层的特征向量进行拼接,并通过一个全连接层(FC)融合成一个包含丰富语义信息的引导向量。这为草稿模型提供了更完整的上下文视图。
C. 移除特征目标 (Removing Feature Constraint)
EAGLE-3 彻底放弃了让模型去拟合特征值的 Loss,转而专注于 Cross-entropy 损失。这释放了模型的参数容量,使其能更直接地学习“下一个 Token 是什么”。
4. 实验与结果 (Experiments & Results)
在 LLaMA-3.1 8B, 70B 以及 DeepSeek-R1-Distill 等多个模型上的测试结果表明,EAGLE-3 全面超越了现有基线。
关键战绩:
- 加速比:在对话任务(MT-Bench)上达到 5.58x,在代码生成(HumanEval)上由于结构化强,更是达到了惊人的 6.47x。
- 接受率 (Acceptance Rate):即使在预测深度增加时,EAGLE-3 的接受率依然保持稳定,而 EAGLE 随着预测步数增加性能骤降。
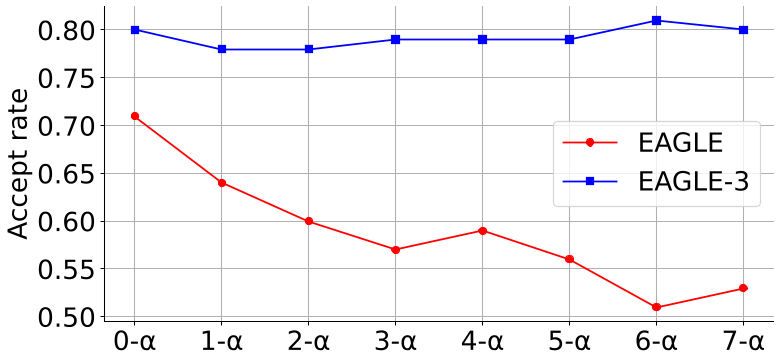 表 1:在 SGLang 框架下的吞吐量表现,EAGLE-3 在大 batch 场景下优势依然明显。
5. 深度洞察与总结 (Conclusion)
为什么 EAGLE-3 能打破“投机采样不适用于大 Batch”的魔咒?
传统的投机采样在 Batch Size 增大时,IO 瓶颈逐渐转化为计算瓶颈。而 EAGLE-3 由于极高的 Token 接受率(Average Acceptance Length 显著增加),显著减少了目标模型的调用次数,从而在生产级环境(SGLang, vLLM)中依然能比原生推理快 40% 左右。
局限性与展望
虽然 EAGLE-3 表现优异,但它仍需要针对不同的目标模型训练一个轻量级的 Transformer Layer(草稿头)。未来的研究方向可能在于如何进一步降低这个“训练成本”,或者使草箱模型具备通用的跨模型迁移能力。
Takeaway:如果你正在寻找一种生产环境下、能显著降低 LLM 响应延迟且不损失质量的方案,EAGLE-3 及其在 SGLang 中的集成无疑是目前的黄金标准。