
TxGemma:由 Google DeepMind 打造的药物研发“全才”模型,从属性预测到 Agent 推理的范式跃迁
Efficient and Agentic LLMs for Therapeutics
本文推出了 TxGemma,一套基于 Gemma-2 构建的高效通才大语言模型(2B、9B 和 27B),专门用于药物研发。该系统不仅能预测 66 种治疗特性(SOTA 级别),还通过 TxGemma-Chat 实现了可解释的交互式推理,并由 Agentic-Tx 智能体系统在化学与生物推理基准测试中打破了 o3-mini 和 o1 的记录。
TL;DR
药物研发(Therapeutics)正迎来它的“GPT 时刻”。Google DeepMind 发布的 TxGemma 系列模型,通过对 Gemma-2 进行大规模生物医学指令微调,打破了以往“一个任务一个模型”的碎片化僵局。它不仅在 66 项预测任务中挑战了专家模型的地位,更引入了 Agentic-Tx 系统,在复杂化学逻辑推理上超越了 OpenAI 的 o1 和 o3-mini 模型。
背景定位:这是治疗性 AI 从“单一黑盒预测器”向“具备理由支撑、能操作工具的通用智能体”转型的标志性工作。
1. 痛点:为什么药物研发需要“通才”?
传统的药物发现(Drug Discovery)像是在大海捞针。科学家需要分别预测分子的毒性(Toxicity)、药代动力学(ADMET)、靶点结合力等,每一个环节都依赖高度定制化的专家模型(如 GNN 或特定指纹模型)。
这种“烟囱式”开发模式存在三个致命缺陷:
- 信息孤岛:小分子的化学结构、蛋白质的氨基酸序列、临床试验的文本描述,这三者难以在一个架构下融合。
- 不可解释性:专家模型会告诉你“预测结果为不通过”,但无法告诉你基于分子极性或疏水性的具体原因。
- 知识滞后:静态模型无法实时查阅最新的 PubMed 文献。
2. Methodology:如何炼就“药学大脑”?
2.1 统一表示层
TxGemma 的核心在于将万物皆归于“指令(Instruction)”。无论是 SMILES 字符串表示的小分子,还是氨基酸序列,全部被映射进 LLM 的词表空间。
2.2 架构解析
TxGemma 提供了 2B、9B 和 27B 三种规格。其训练方案分为两路:
- Predict 版本:在 700 万条药学指令上全量微调,追求极致的预测精度。
- Chat 版本:采用 30% 药学数据 + 70% 通用指令数据混合策略,通过损失少量预测精度,换取了强大的科研对话和逻辑解释能力。
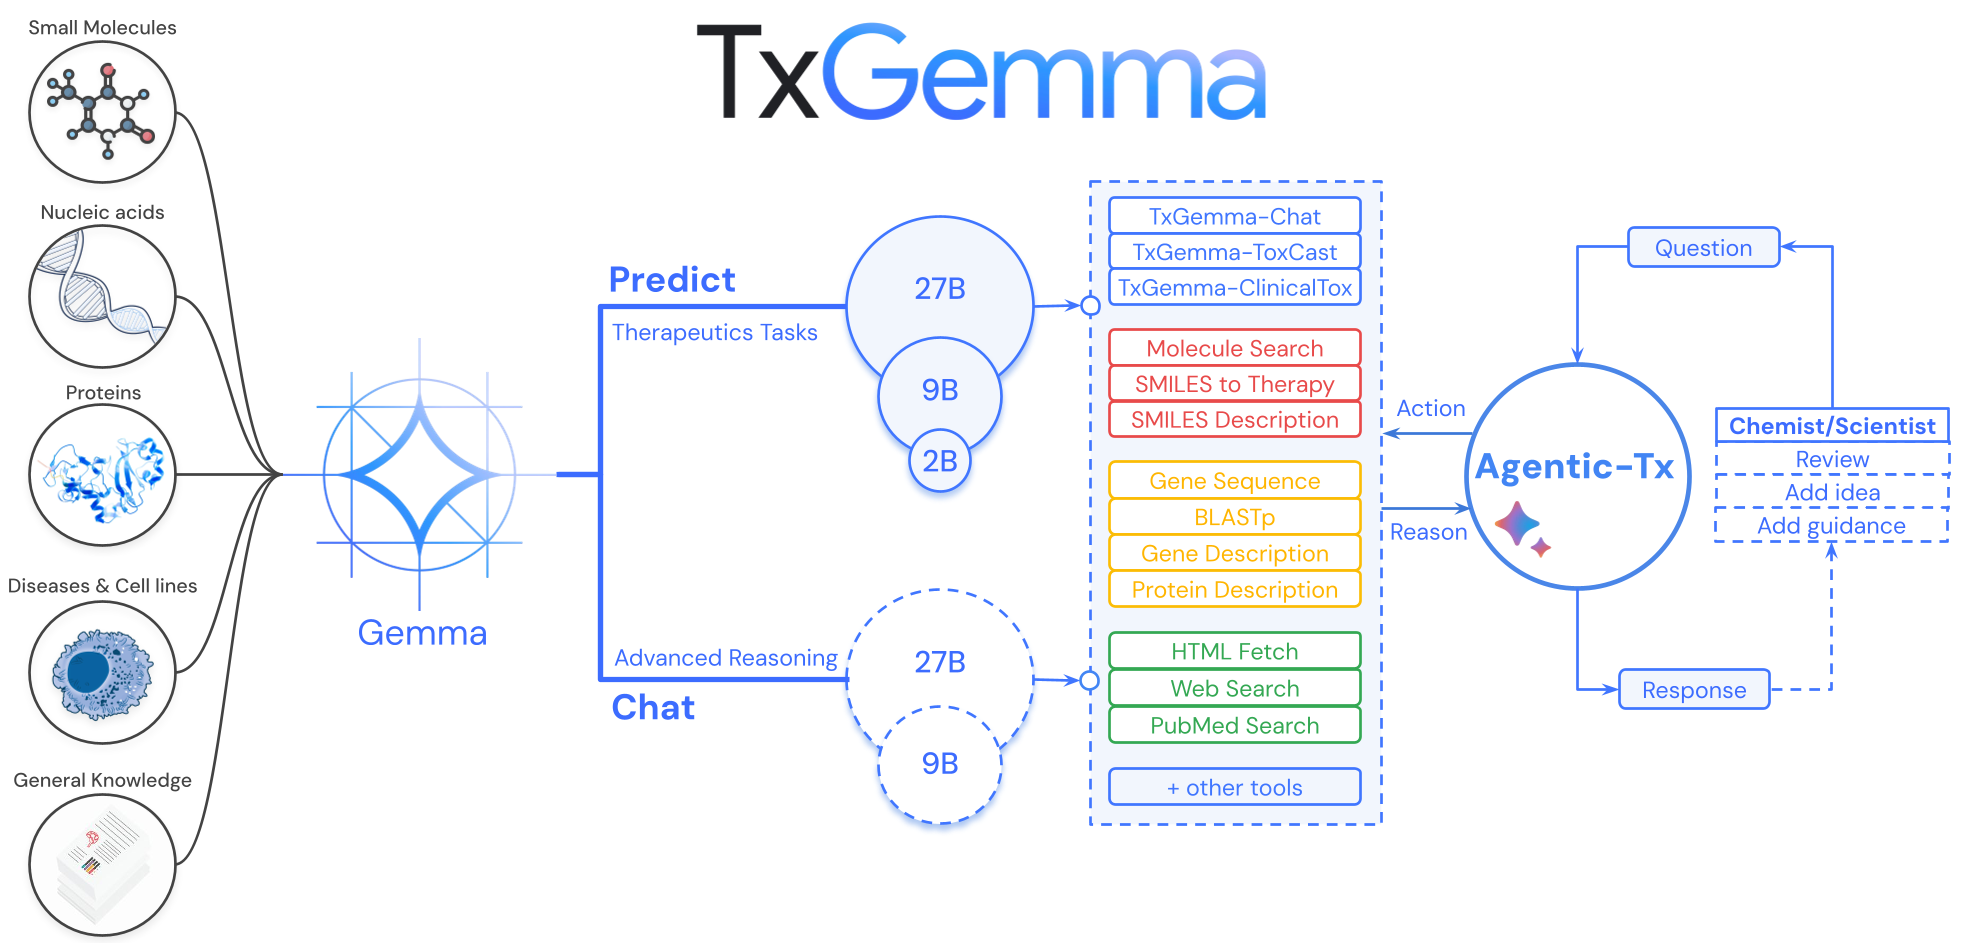 图 1:TxGemma 家族构成。Predict 型追求性能,Chat 型负责推理,Agentic-Tx 负责调度。
3. 实验战绩:硬刚专家模型与推理大模型
3.1 预测性能:通才战胜专家
在 TDC 全球基准测试中,27B 的 TxGemma 在绝大多数 ADMET 任务、药物-靶点相互作用(DTI)任务中都甚至超过了专门为此设计的 GNN 模型。
- 数据效率:TxGemma 在微调临床试验不良事件预测时,仅需 Base 模型 10% 的数据量即可达到相同效果。
3.2 冷推理挑战:Agentic-Tx 的崛起
通过引入 ReAct 框架,Agentic-Tx(基于 Gemini 2.5 驱动)可以调用 TxGemma-Predict 作为工具,同时翻阅 Wikipedia 和 PubMed。 在最严苛的“人类最后一场考试(HLE)”和 ChemBench 测试中,Agentic-Tx 的表现令人震惊:
- 化生推理 (HLE):相对 o3-mini (High) 提升了 52.3%。
- 化学偏好 (ChemBench-Preference):相对 o1 提升了 17.7%。
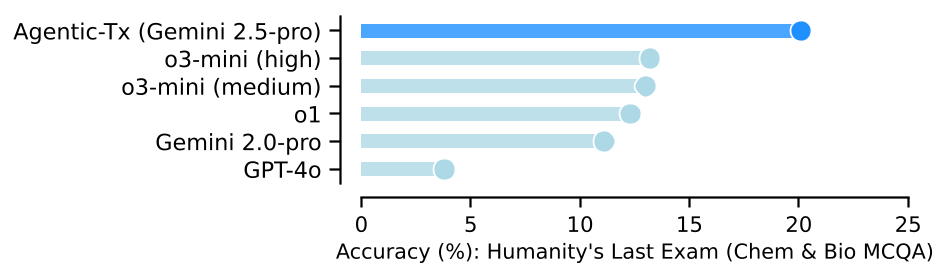 图 2:Agentic-Tx 在顶级推理基准测试中的性能表现,显著领先于通用前沿模型。
4. 深度洞察:从“是什么”到“为什么”
TxGemma 最迷人的特质在于它的机械论推理(Mechanistic Reasoning)。当你问它某个分子是否能通过血脑屏障(BBB)时,它不再只给一个标签,而是会解释:“基于该分子的分子量和 SMILES 链中的疏水基团,它更易于透过细胞膜……”
这种能力通过图 6 得到了完美体现:
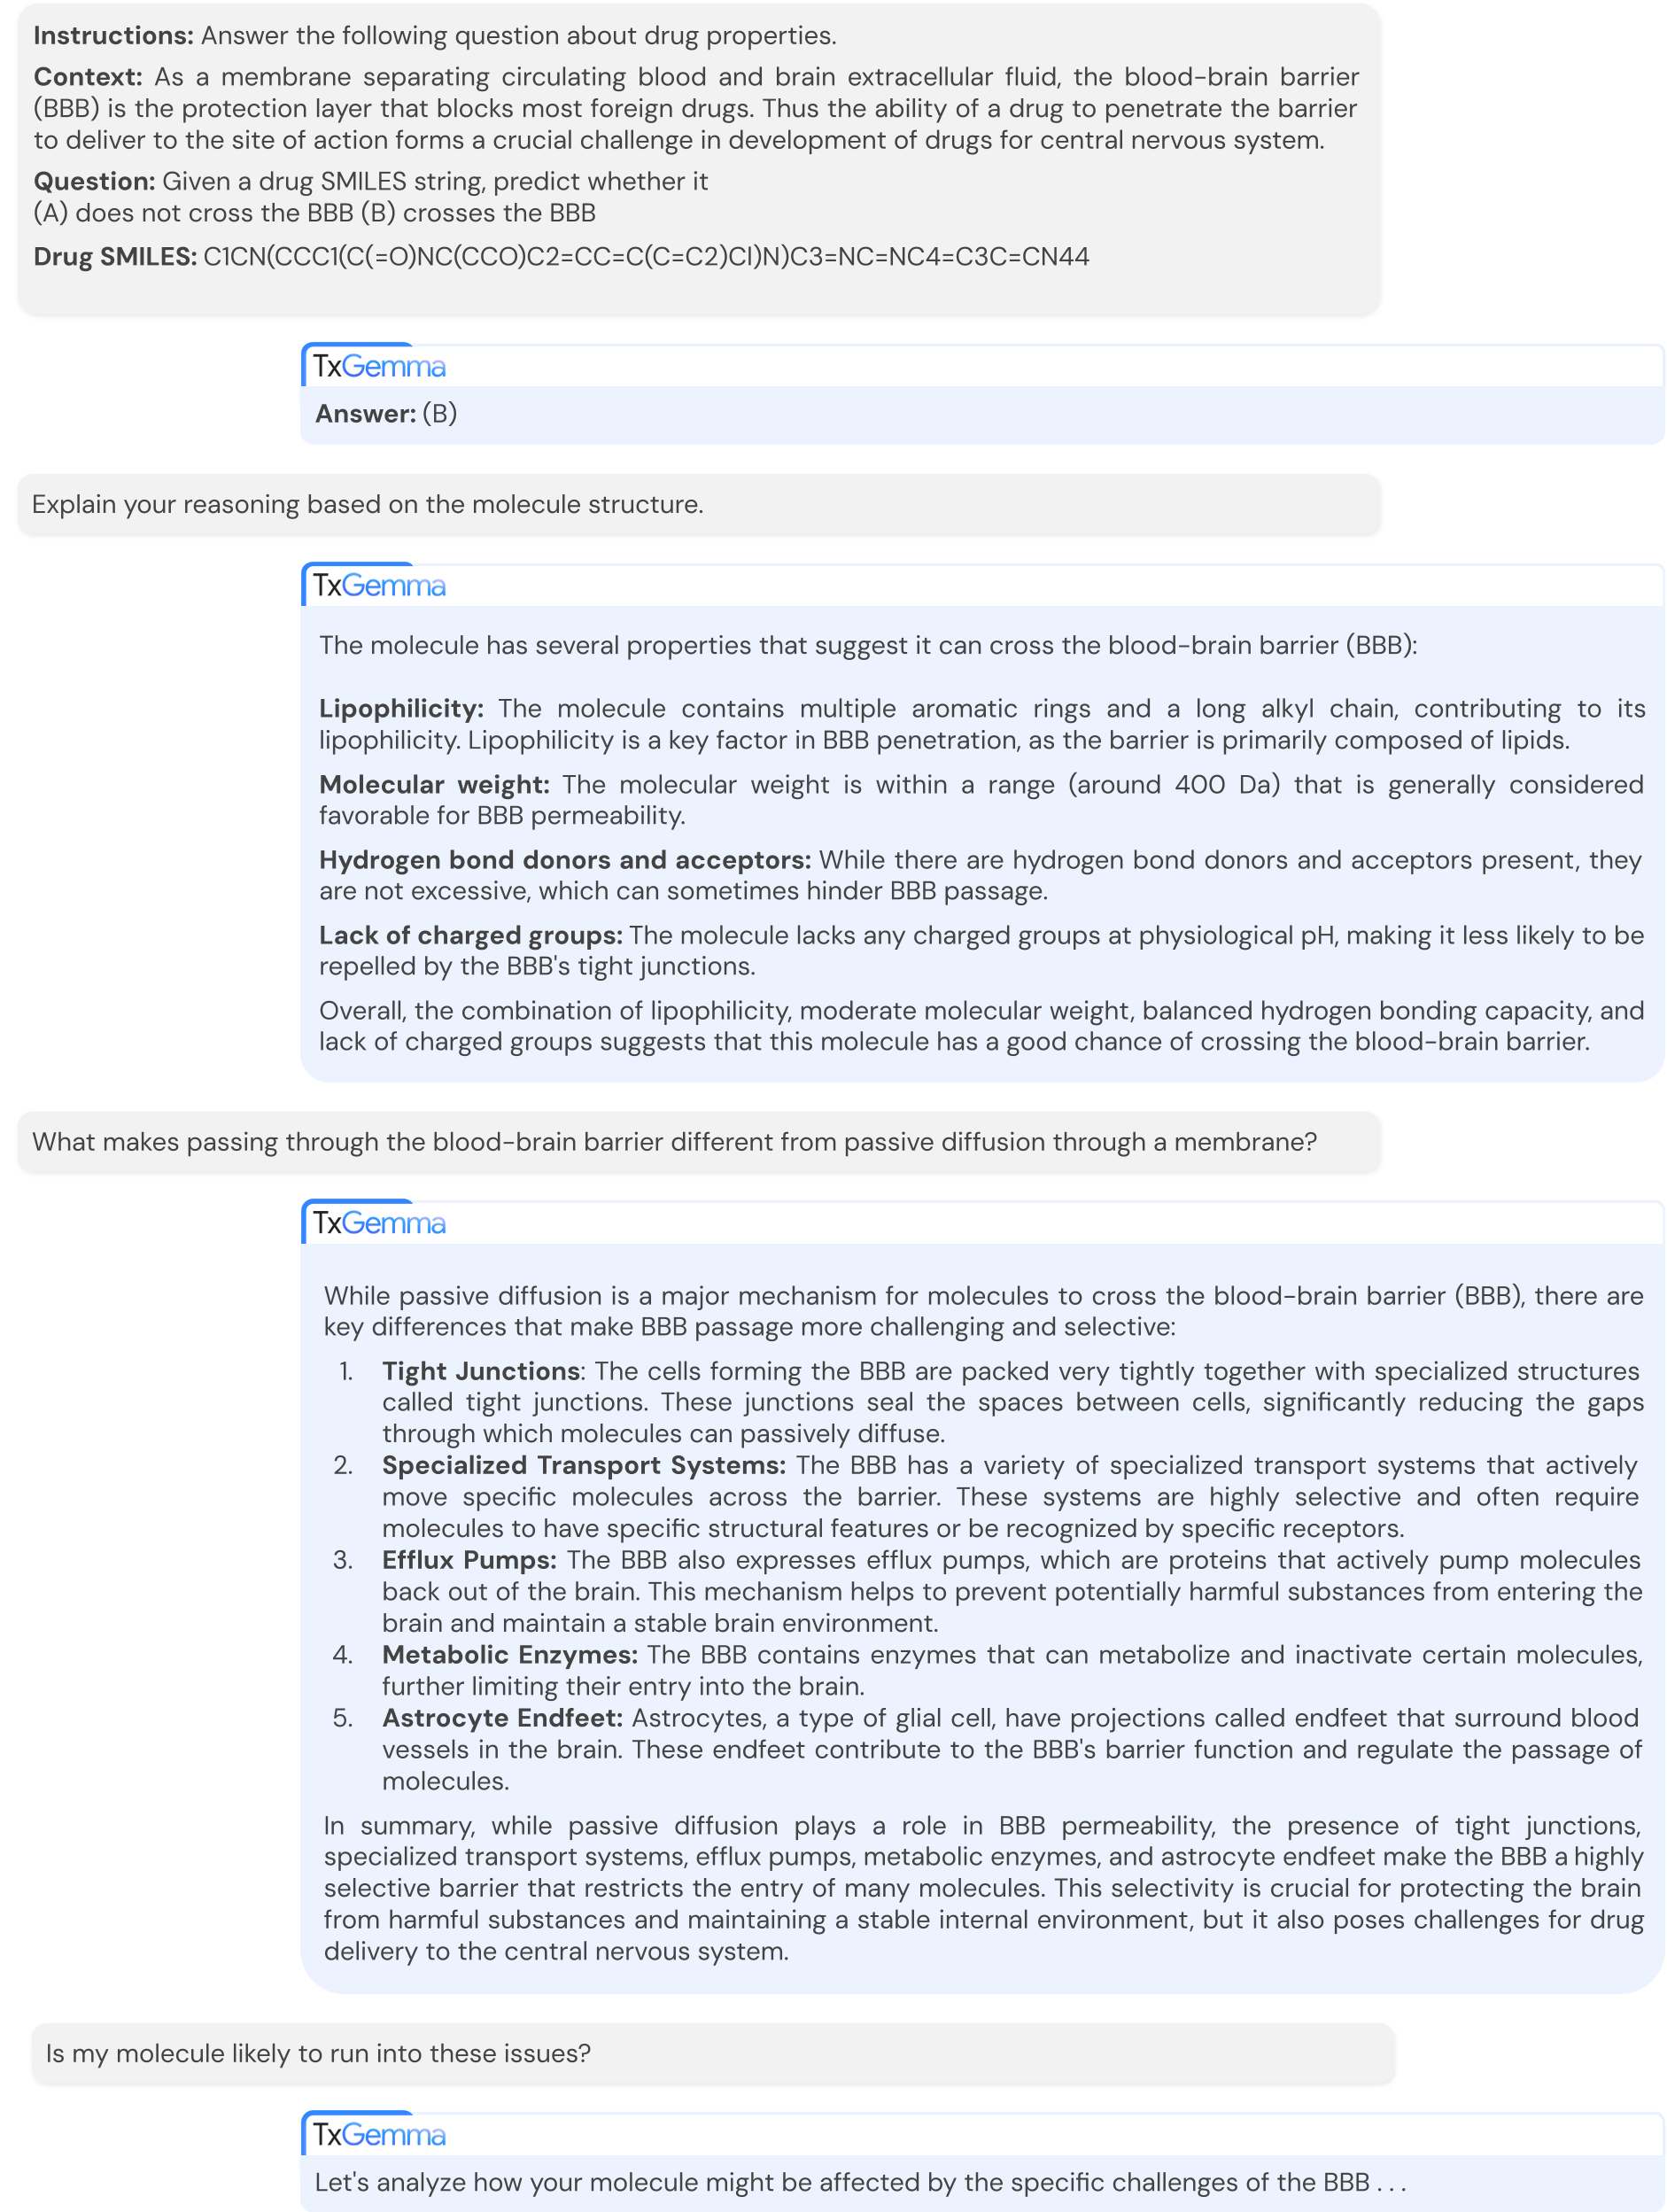 图 3:TxGemma-Chat 揭示了预测背后的化学直觉,缩短了人类科学家验证结果所需的时间。
5. 总结与未来展望
核心贡献(Takeaway):
- 权衡的胜利:证明了 27B 规模的模型通过高质量垂直领域微调,能在专业领域击败千亿参数的巨型通用模型。
- Agent 范式:药学 AI 已不再仅仅是跑个分,而是能自主查文献、调用工具、做总结的数字助手。
- 开放赋能:Google 开源了这些模型,允许药企在私有、受监管的数据集上进一步微调。
局限性: 虽然干实验(In-silico)结果辉煌,但尚未经过大规模湿实验(Wet-lab)的实时交叉验证。未来的研究应聚焦于如何将 Agentic-Tx 的推理步骤直接转化为自动化合成实验室的机械臂指令。
资深主编点评:TxGemma 并非是在 Gemma 基础上做简单的加法,它体现了 Google 对“科研 Agent”的深刻理解——即高性能预测(Predict)与高水平交互推理(Chat)的有机耦合。在医药领域,这种能讲道理的 AI 比只会给结果的 AI 要珍贵得多。