
Heima:让 MLLM 拥有“闭目思考”的能力,推理效率提升 15 倍
Efficient Reasoning with Hidden Thinking
本文提出了 Heima(Hidden Llama),一种针对多模态大语言模型(MLLM)的思维链(CoT)压缩框架。该方法通过将冗长的文本推理过程压缩为极简的隐层思维标记(Thinking Tokens),在保持 SOTA 推理能力的同时,显著提升了推理效率。
TL;DR
在多模态理解中,让模型“说出”推理过程(CoT)虽然能提高准确率,但太慢且太贵。本文提出的 Heima 框架通过将冗长的文字推理压缩为极少数的 Thinking Tokens,实现了在几乎不损失性能的前提下,将推理标记量减少了 90% 以上。
背景定位:从“喋喋不休”到“默念于心”
在大模型领域,OpenAI o1 开启了“慢思考”时代。然而,随之而来的问题是:推理链条越长,推理成本和响应延迟就越高。Heima 的出现正是为了解决这个矛盾。它在领域坐标系中属于 Latent Space Reasoning (隐空间推理) 的先驱工作,首次在多模态大规模模型(MLLM)上验证了 CoT 压缩的可行性。
痛点深挖:冗余的文字与昂贵的 Token
传统的 CoT 存在两个主要局限:
- 计算冗余:对于模型内部逻辑而言,很多自然语言连接词是“废话”。
- 多模态鸿沟:将视觉信息强行转化为文字推理,再转化为答案,中间存在信息损失和效率瓶颈。
作者的 Insight 非常深刻:既然推理本质上是向量空间的变换,那么是否可以用一个向量(Hidden State)代表一整段推理文字?
方法论详解:渐进式蒸馏与隐空间重构
1. 渐进式蒸馏 (Progressive Distillation)
作者没有尝试一次性让模型学会“缩骨功”,而是采用了阶梯式教学。
- 步骤:先蒸馏第一阶段推理,保持后面阶段为文本;待模型适应后,再蒸馏下一阶段。
- 架构:模型不再输出 "Because energy is conserved...",而是输出一个特殊的符号
<Thinking>。
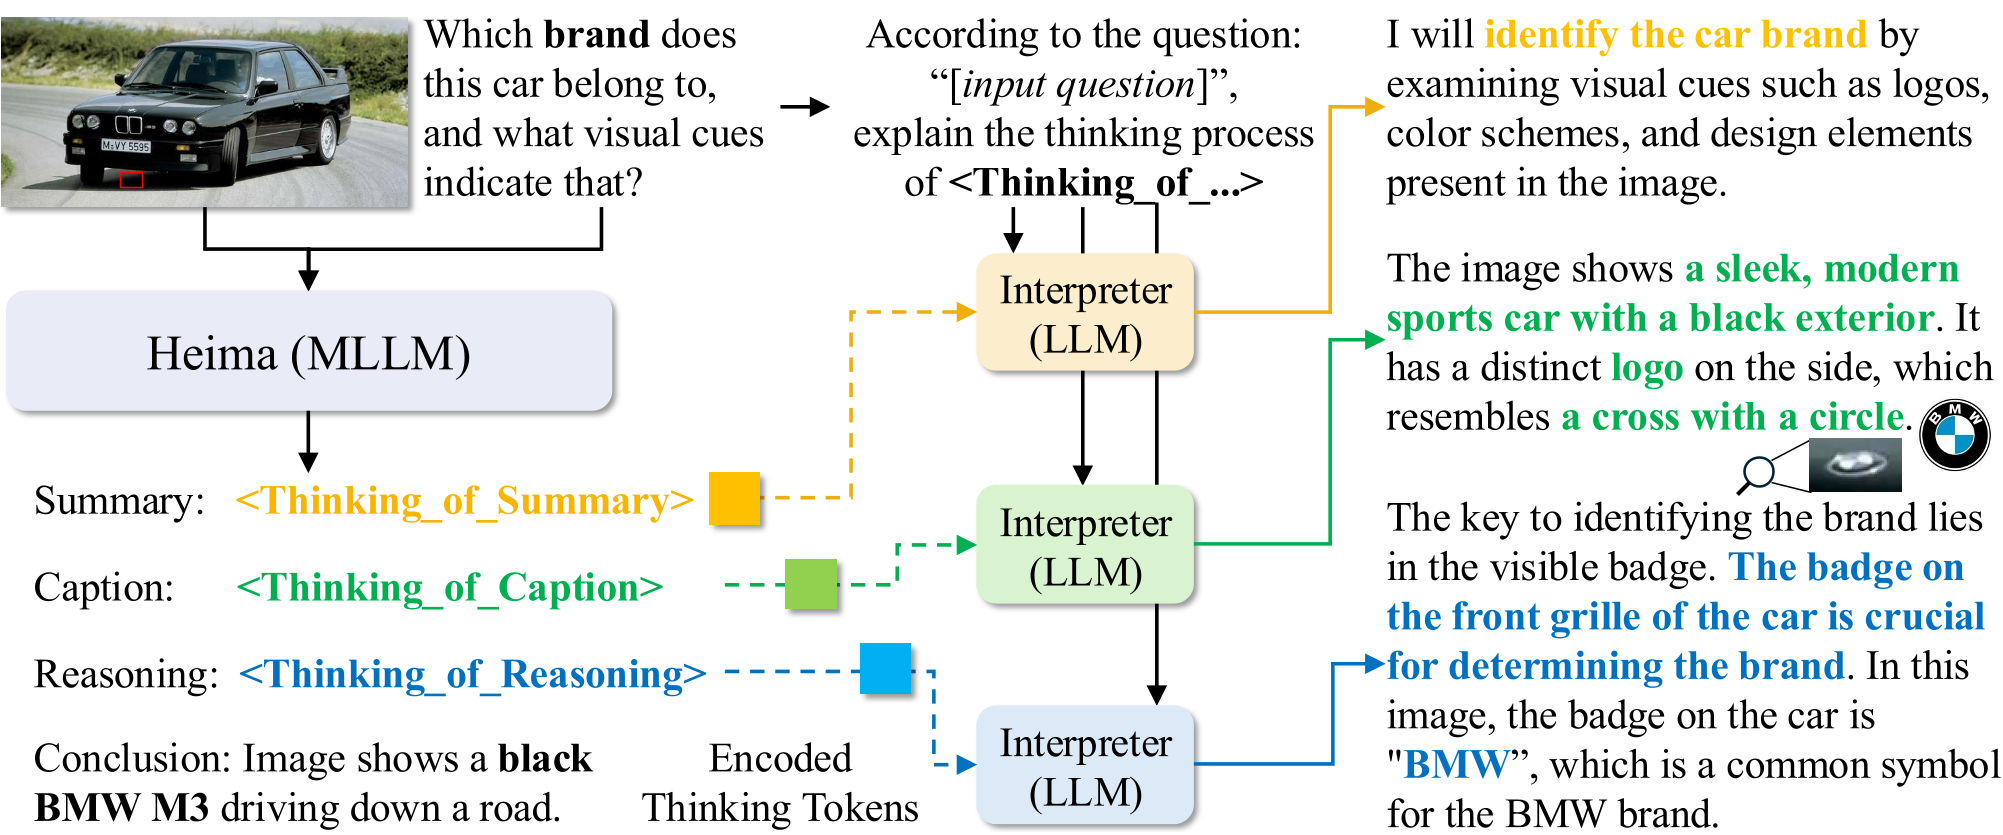 图 1:Heima 框架总览。模型生成 Thinking Tokens 后,可由 Interpreter 还原为可读文本。
2. 信息论支撑:信息真的没丢吗?
作者通过数学证明(Theorem 3.1):只要压缩后的标记与目标答案 Y 之间保留了 非平庸互信息 (Non-trivial Mutual Information),推理能力就不会消失。这就是为什么几个 Token 就能支撑起复杂的数学运算。
实验结果:以一敌百的效率
在多个 Benchmarks(MMStar, MMBench, MathVista)上,Heima 表现惊人:
- 标记效率:在某些预测任务中,生成的 Token 数量从 180+ 骤降至 13 个左右,缩减了约 15 倍。
- 零样本准确率:在 MMBench 上甚至比原始 LLaVA-CoT 还要高(72.8 vs 70.7),这说明隐空间推理可能减少了文本生成带来的幻觉。
 表 1:Heima 与基线模型的性能对比,注意 (# Token) 列的巨大降幅。
深度洞察:既然看不见,如何解释?
为了解决黑盒问题,作者设计了 Adaptive Interpreter。即使推理过程在模型内部是“隐身”的,解释器也能将其翻译回人类可读的文字。有趣的是,即便不给解释器看原始图片,它也能根据 Thinking Tokens 描述出“一辆现代黑色的跑车”。这有力地证明了 Thinking Tokens 已经完美捕捉了视觉核心特征。
局限性与展望
尽管 Heima 在效率上取得了飞跃,但在极端复杂的数学极智推理(如 MathVista)上仍有小幅性能回落(43.6 vs 50.9)。这提示我们,完全的隐空间推理在极致逻辑严密性上仍有提升空间。
总结:Heima 为我们揭示了一个未来——未来的大模型可能不再需要输出冗长的思考过程,而是直接在隐空间内完成万千思绪的流转,只给人类最终的精准答案。