
涌现还是聚拢?MA-LLM 多智能体协同的信息论深度解析
Emergent Coordination in Multi-Agent Language Models
本文提出了一种基于信息论(Partial Information Decomposition, PID)的量化框架,用于探测多智能体大语言模型(MA-LLM)系统中的动态涌现(Emergent Coordination)。研究通过 group binary search 任务验证,证明了通过 Prompt 设计(如 Persona 和 Theory of Mind 引导)能将智能体集合从简单的“聚合体”转向具有高阶协同结构的“集体”。
TL;DR
多智能体大语言模型(MA-LLM)真的产生了“1+1>2”的协同吗?本论文通过严谨的信息论框架证明:MA-LLM 确实具备动态涌现(Dynamic Emergence)的容量。研究发现,简单的指令只能让智能体产生物理上的随机对齐,而通过引入“人格化(Persona)”和“心智理论(ToM)”的 Prompt,可以诱导系统从“气态(Gaseous)”的混乱状态转向具有深层吸引子(Deep Basin of Attraction)的稳定集体行为。
痛点深挖:谁在真正贡献“协同”?
在当前的多智能体研究中,我们经常看到多个智能体协作解决软件开发或医疗问题的案例。但学术界一直存在一个质疑:这种性能提升是真的产生了跨个体的分工协同(Synergy),还是仅仅因为模型迭代次数变多、搜索空间变大的统计红利?
作者指出,现有的评估指标(如 Win-rate)是“结果导向”的黑盒,无法解释内部结构耦合。真正的涌现应该是:系统的未来状态包含的信息,无法由任何单一子集的当前状态所解释。
方法论详解:探测“不可还原”的协同信息
作者采用了**偏信息分解(Partial Information Decomposition, PID)**这一前沿信息论工具。其物理直觉在于: 将系统总信息分解为:
- 冗余(Redundancy):多个智能体共有的信息(如对目标的共同认知)。
- 独有(Unique):单一智能体掌握的特定偏好。
- 协同(Synergy):只有将多个智能体放在一起看才能解读出的高阶结构。
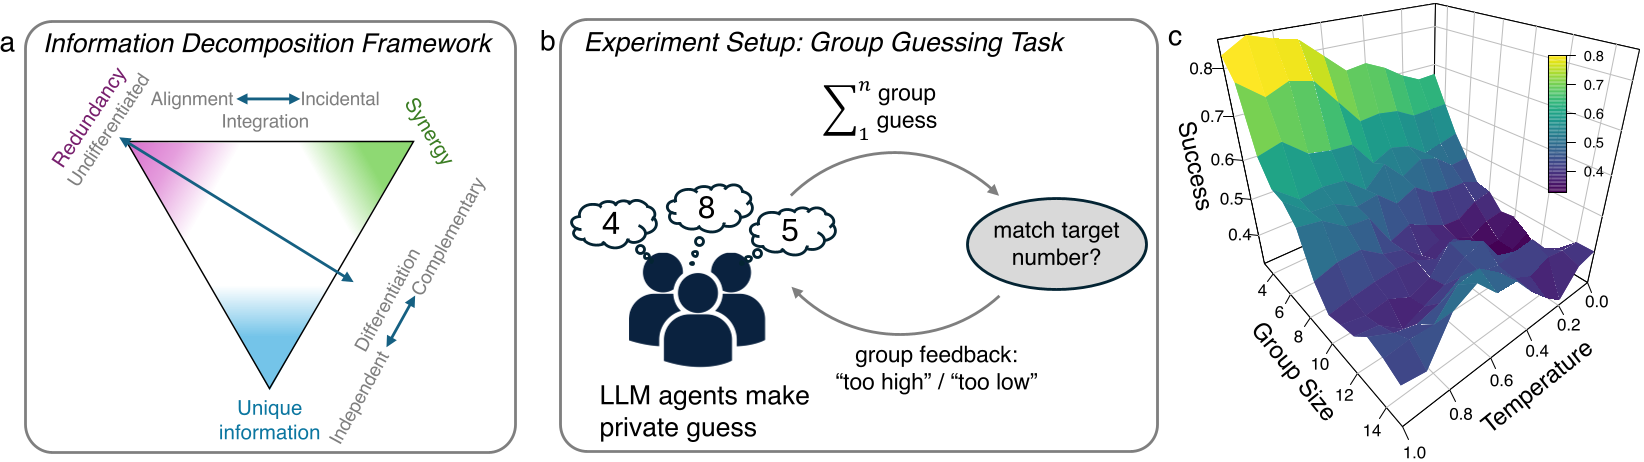
为了验证协同的真实性,作者设计了两个关键的“伪造实验”:
- 行置换(Row-shuffle):打破智能体身份,验证是否依赖特定角色。
- 列置换(Column-shuffle):打破时间对齐,验证是否依赖动态响应。
实验与结果:从混乱到深层吸引子
实验采用了“群组二分搜索(Group Binary Search)”任务。在这个任务中,如果所有智能体都采用相同的策略,系统会陷入震荡;只有产生角色分化(部分人猜高,部分人补位),才能成功。
1. 指令的魔力
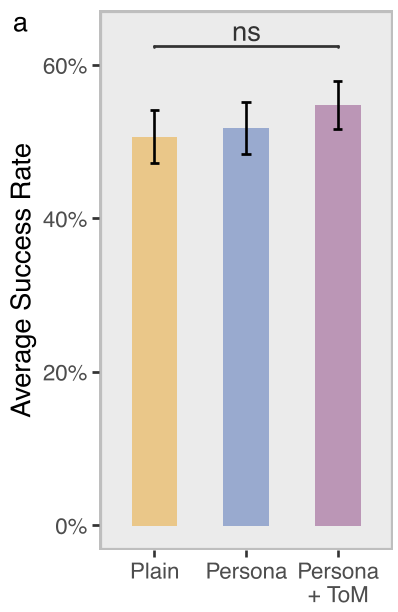
研究对比了三种模式,发现:
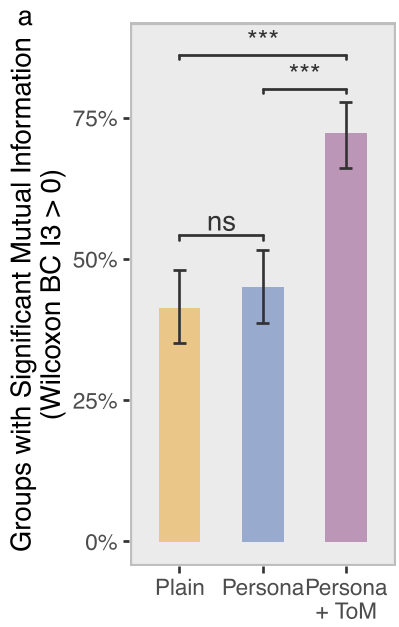
- Plain (基础模式):智能体表现得像杂乱的原子,虽然有微弱的涌现容量,但无法形成稳定的宏观状态。
- Persona (人格化):引入稳定的身份标签(如“你是经验丰富的工程师”),智能体开始展现出显著的行为分化。
- ToM (心智理论引导):当要求模型“思考其他人在做什么”时,系统发生了相变。**总稳定性(Total Stability)**激增,集体行为被推入了一个极其稳定的“深层吸引子”池。
2. 推理模型的“协同陷阱”
有趣的是,在 Qwen3 等具备极强推理能力的模型中,作者发现了**“协调模糊麻痹”(Paralysis under Coordination Ambiguity)**。当群组反馈与个体逻辑冲突时,推理模型会陷入无限的思维链(CoT)循环,试图完美建模他人,最终导致死锁。
深度洞察与总结
- 协同与冗余的动态平衡:高性能系统并非只有协同。回归分析显示,只有当“目标对齐(冗余)”与“分工互补(协同)”同时存在时,系统性能才有质的飞跃。
- 身份的重要性:研究发现特定 Persona 内容并不重要(谁是工程师谁是工人无所谓),重要的是“分配了身份”这一事实本身,它成为了 LLM 在高维反馈空间中锚定行为倾向的坐标系。
局限性:该研究目前仅基于简单的数值游戏。在更复杂的开放语义任务(如代码协作)中,如何定义宏观状态(Macro-signal)并进行 PID 分解,依然是极具挑战的课题。
未来展望:这项工作为构建“可控的集体智能”奠定了理论基础。它告诉我们,通过精准的 Prompt 参数调节,我们真的可以引导 AI 集体从“乌合之众”进化为“高效团队”。