
EMOE:拒绝“一刀切”融合,让每个模态专家各司其职
EMOE: Modality-Specific Enhanced Dynamic Emotion Experts
本文提出了 EMOE(Modality-Specific Enhanced Dynamic Emotion Experts),一种针对多模态情感识别(MER)的新型框架。该方法通过 Mixture of Modality Experts 实现样本级的动态权重分配,并结合 Unimodal Distillation 技术,在 CMU-MOSI 和 CMU-MOSEI 等主流数据集上刷新了 SOTA 性能。
TL;DR
在多模态情感识别(MER)中,文本、视觉和音频的重要性并非固定。本文提出的 EMOE 框架通过动态的“专家路由”机制,为每一个输入样本量身定制模态权重,并巧妙利用单模态蒸馏技术挽救了被融合过程掩盖的特异性特征。实验证明,该方法在情感识别与意图识别任务中均显著优于现有的 SOTA 方法。
背景:被忽视的“个体差异”与“单模态天赋”
在处理一段视频情感时,有时个体的表情泄露了天机,有时则是语调或文本语义更具辨识度。然而,主流的融合方法(如简单的拼接或 Tensor Fusion)往往对所有样本采用统一的融合逻辑。这种“一刀切”的做法导致了两个严重后果:
- 模态平衡困境:模型容易过度依赖某种强势模态(如文本),而忽略了在特定样本中更有价值的辅助模态。
- 模态特异性消失:在追求跨模态共性特征时,单模态独特的预测本领(Specialization)往往在融合层被洗掉了。
核心方法演练:动态路由与知识回流
1. 模态专家混合 (MoME)
EMOE 将每个模态(语、视、音)视为一个独立的 Expert。其核心由一个 Router 网络 驱动,它根据输入特征实时计算权重分布 。
- 专家平衡机制:为了防止模型在训练早期陷入对某一模态的“路径依赖”,作者引入了 Router Entropy Loss。这迫使 Router 保持一定的探索性,确保所有模态都能得到充分的一致性训练。
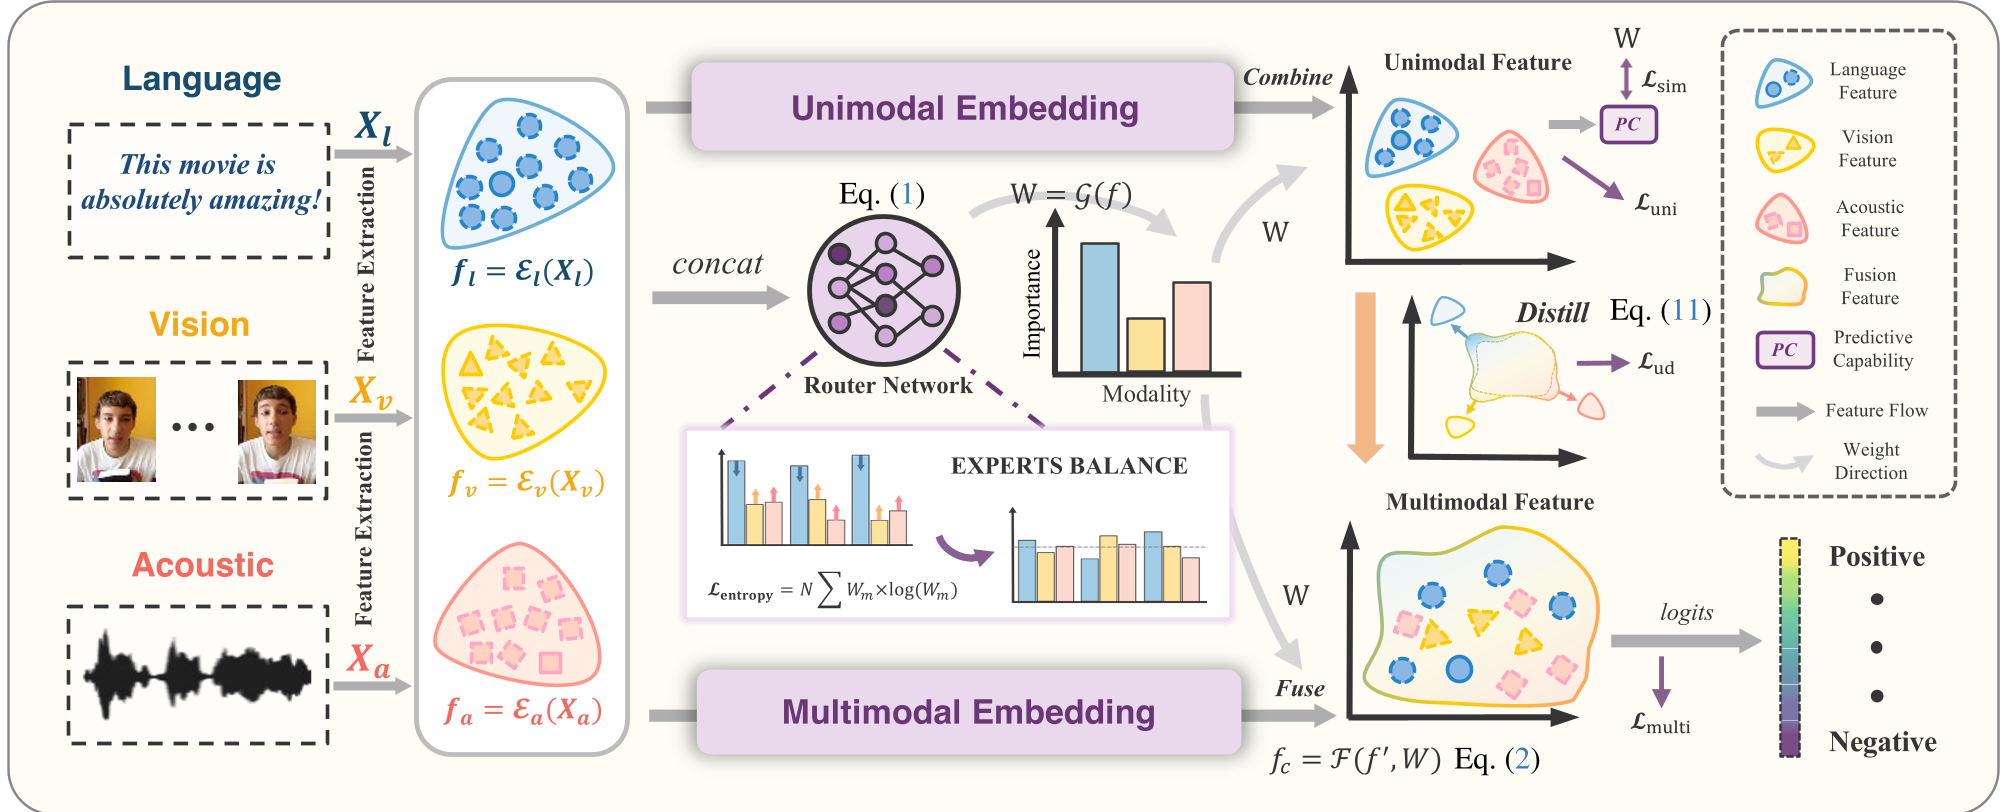 图 1:EMOE 整体架构,展示了从路由权重分配到特征融合的全过程。
2. 带 Router 选择的单模态蒸馏 (UD)
这是本文的另一大看点。为了不让单模态的预测能力在融合中流失,作者设置了专门的单模态分类头,并执行单向知识蒸馏:让融合后的“综合特征”去学习“加权后的单模态特征”。
- 核心直觉:通过让单模态作为老师来指导多模态特征,模型在保留宏观视野的同时,能捕捉到微观的模态细节。
实验战果:刷榜 MER 与 MIR
EMOE 在 CMU-MOSI 和 CMU-MOSEI 等基准数据集上进行了严谨测试。结果显示,在最具挑战性的 ACC-7(七分类准确率)上,提升尤为显著。
 表 1:在 CMU-MOSI 数据集上的表现,EMOE 在多项指标上超越了之前的 DMD 和 Self-MM。
此外,通过 t-SNE 可视化(见图 5),我们可以清晰地看到,EMOE 生成的特征空间分布具有极强的连续性和区分度,完美契合情感强度的回归任务需求。
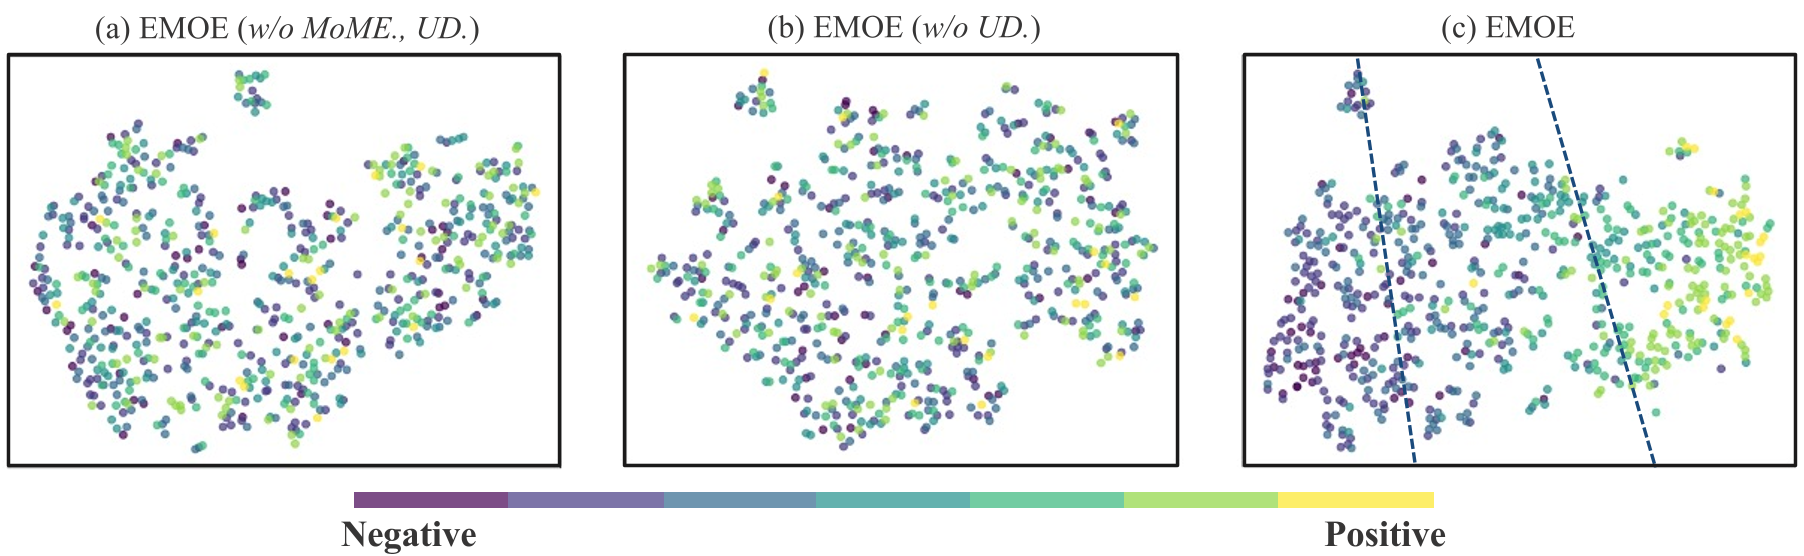 图 2:t-SNE 降维显示,引入 MoME 和 UD 后,特征分布更加紧凑且符合情感梯度。
深度洞察
EMOE 的成功在于其对 Inductive Bias 的精准捕捉:即多模态任务本质上是异构且动态的。它通过 Router 解决了“谁更重要”的问题,通过 UD 解决了“固有本领不能丢”的问题。
局限性分析:尽管动态路由提升了性能,但在超大规模实时推理场景下,Router 本身带来的计算开销以及对温度参数 的敏感性仍是实际应用时需要精细调优的环节。
总结
EMOE 并非通过堆砌模型复杂度来取胜,而是通过深入剖析多模态学习中的退化行为,用简洁的动态加权与蒸馏机制找回了消失的模态特异性。这为未来构建更具鲁棒性的 Affective Computing 系统提供了极具价值的参考。