
DMET:将大模型生成视为语义流形上的“几何华尔兹”
Empirical Investigation of Latent Representational Dynamics in Large Language Models: A Manifold Evolution Perspective
本文提出了动力学流形演化理论 (DMET),将大语言模型的生成过程建模为在低维语义流形上受控演化的动力系统。通过引入状态连续性 (C)、吸引子聚类质量 (Q) 和拓扑持久性 (P) 三组几何指标,该方法成功预测了文本质量,并实现了自适应解码控制。
TL;DR
大语言模型(LLM)在生成每一个 token 时,其内部隐藏状态究竟是如何剧烈波动的?本文提出的 动力学流形演化理论 (DMET) 认为:生成过程并非随机的概率采样,而是一个受控的动力系统在低维语义流形上的有序运动。通过监控轨迹的“平滑度”和“吸引子结构”,我们不仅能预测文本好坏,还能实时调节解码参数,让困惑度(Perplexity)骤降 70%。
1. 痛点:静态诊断无法解决动态漂移
当前的解释性技术(如特征归因或探针)大多像是在给模型做“CT 扫描”,提供的是静态切片。然而,幻觉(Hallucination)和逻辑崩溃通常不是由某一个孤立的词决定的,而是表示空间随时间逐渐“跑偏”的累积效应。
作者认为:如果能把 LLM 生成看作是一条在语义空间中滑行的轨迹,我们就能定义什么是“健康的滑行”,什么是“失控的翻车”。
2. 核心直觉:Transformer 其实是一组 ODE
作者提出了一个优雅的类比:Transformer 的残差连接结构本质上是 显式欧拉离散化 (Explicit Euler discretization)。
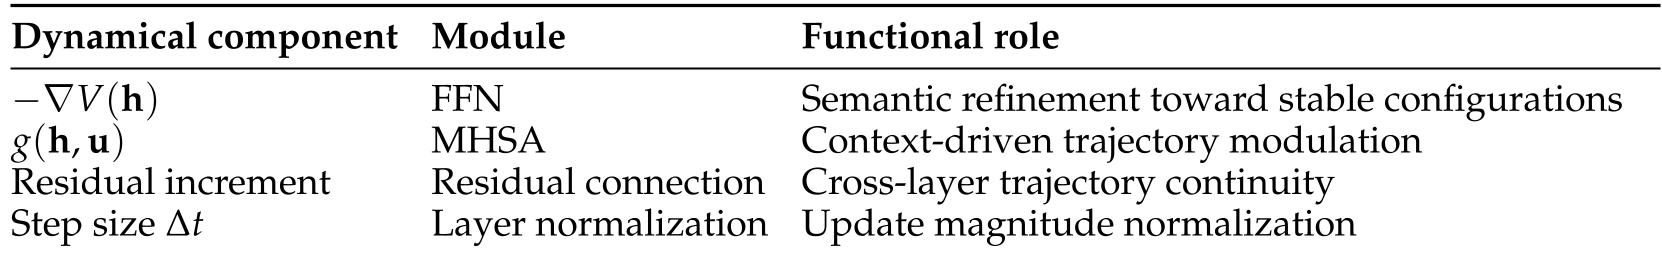
在 DMET 框架下:
- FFN 层 相当于在优化“语义位能”,将状态推向稳定的语义吸引子(Attractors)。
- Attention 层 则是外加的“控制力”,根据上下文调整轨迹方向。
- 残差更新 确保了轨迹的连续性(Continuity)。
3. 三大几何指标:如何量化“动态美”?
为了验证这一动力学假说,作者定义了三个在最终层隐藏状态上计算的代理指标:
- 状态连续性 (State Continuity, C):衡量相邻 Step 隐藏状态的欧氏距离。距离越小,生成越稳健。
- 吸引子聚类质量 (Attractor Clustering Quality, Q):利用 PCA 降维后进行聚类,看隐藏状态是否倾向于落入某些特定的“语义盆地”。
- 拓扑持久性 (Topological Persistence, P):利用拓扑数据分析(TDA)捕捉轨迹中的环状结构,这通常对应文本的主题回归和长程连贯。
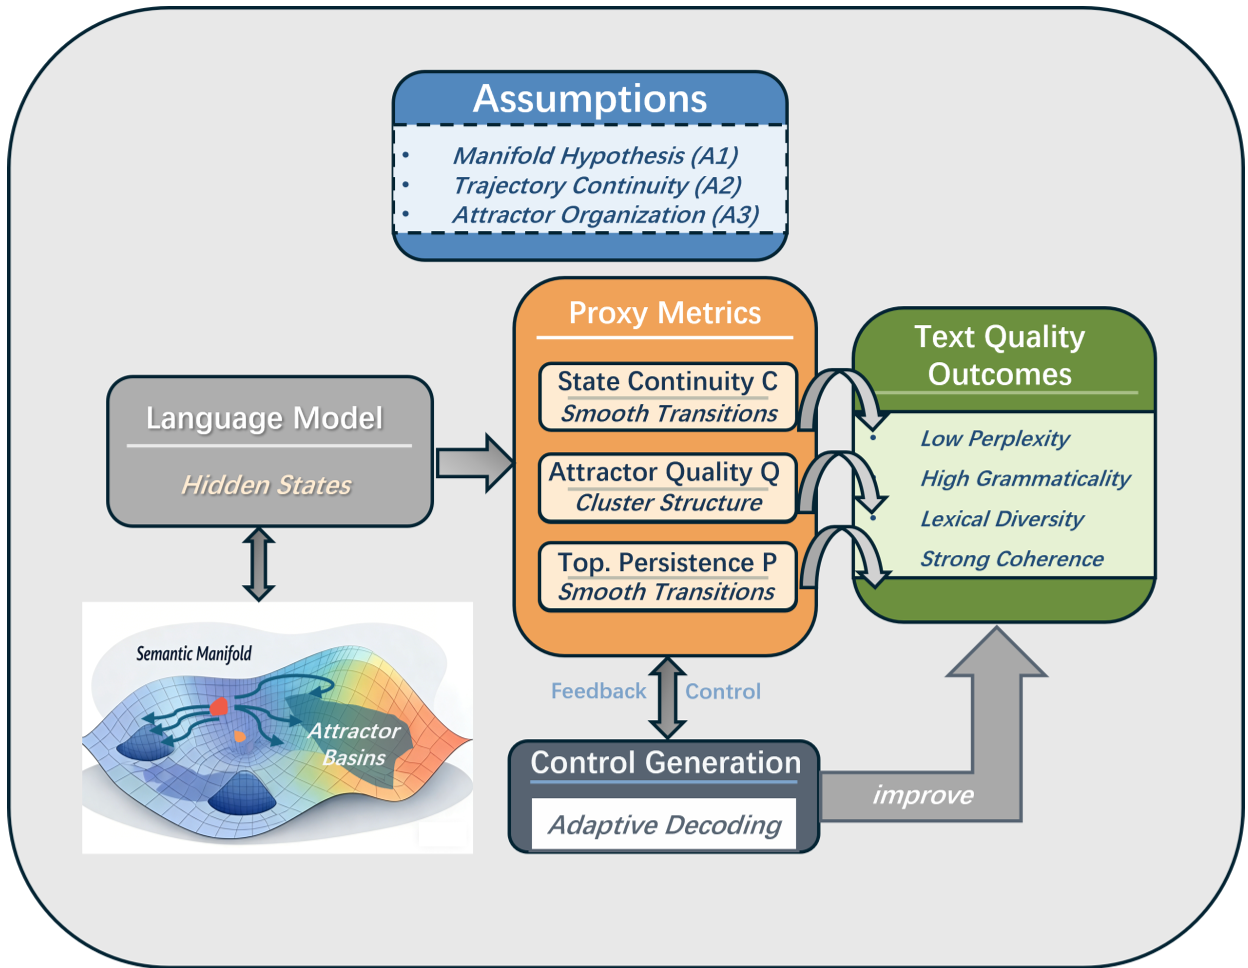
4. 实验验证:指标确实是质量的“晴雨表”
通过对 Llama-3, Qwen2.5, DeepSeek-R1 等多款模型进行 1080 次实验运行,研究发现:
- C 值飙升 通常预示着模型进入了语法崩溃区。
- Q 值越高,文本的语义连贯性(Coherence)越强,说明模型维持在了清晰的语义区间。
- P 值 则与长文本的主题一致性高度正相关。
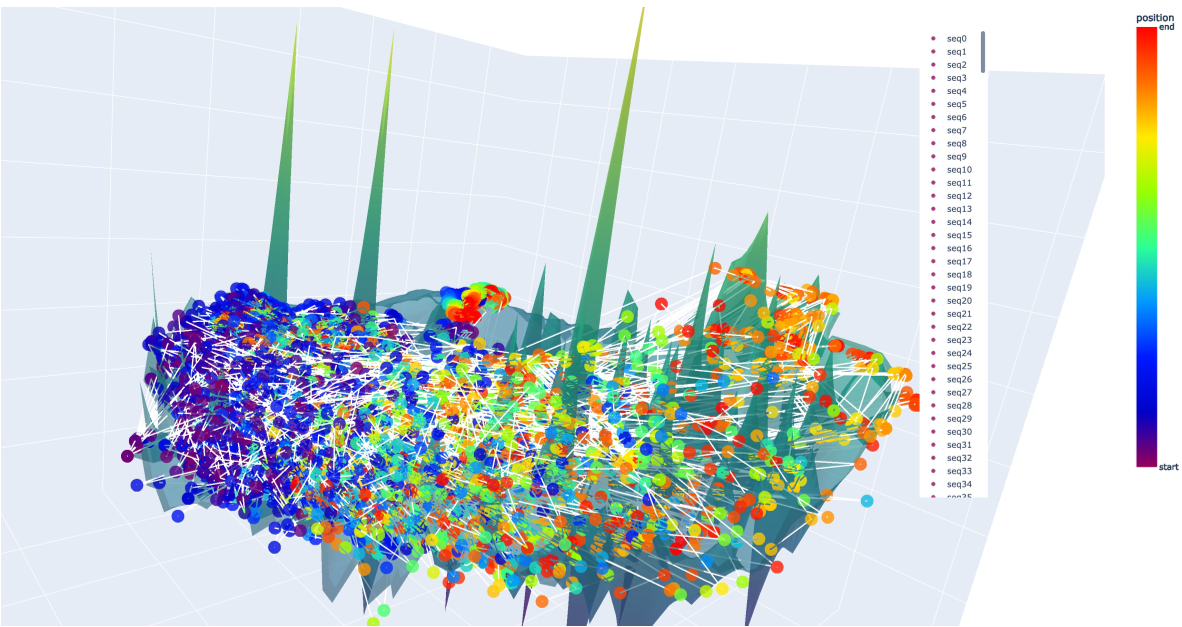 上图展示了 400 条生成序列在 PCA 空间中的集合分布,呈现出清晰的扇形流形表面,验证了流形假设(A1)。
5. 从分析到控制:自适应解码
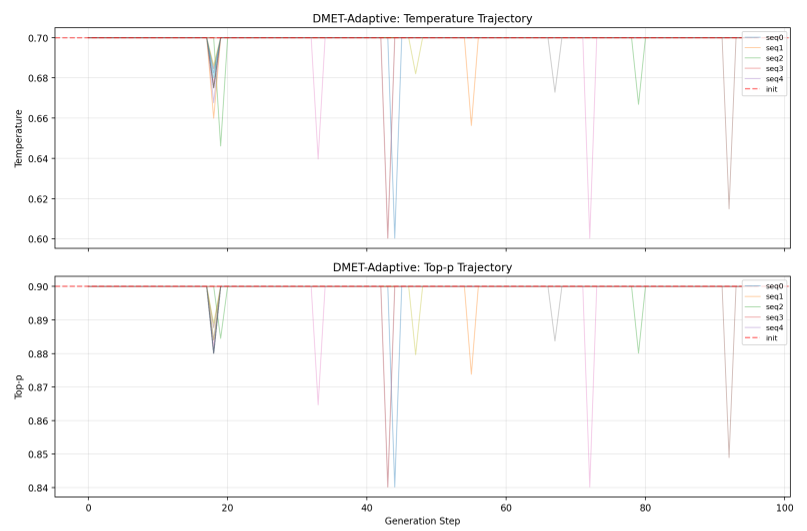
这是本篇论文最具实战价值的部分。作者开发了一个自适应解码控制器:它在生成过程中实时监控波动率 。一旦检测到轨迹发生异常跳变(即 超过阈值),控制器会自动降低 Temperature(采样温度),通过增加“阻尼”来强行平稳轨迹。
战绩:自适应解码将困惑度从基线的 48.5 降至 14.6。这证明了:理解动力学,就能直接控制生成质量。
总结与展望
DMET 将 LLM 推理从“黑盒概率抽样”提升到了“几何动力学模拟”的高度。虽然目前该框架在直接参数化语义位能 方面仍面临挑战,但它为解决长文本幻觉、提升复杂逻辑推理的稳定性提供了一条全新的几何路径。
未来的研究方向可能在于如何将这种动力学约束直接引入预训练阶段,从而在模型内部诱导产生更稳健的“语义吸引子”。