
LLM-Diagnosis:大模型微调开启工业复杂系统故障诊断的新范式
Empirical study on fine-tuning pre-trained large language models for fault diagnosis of complex systems
本文提出了 LLM-diagnosis 框架,通过对 LLaMa-2 和 GPT-3.5 等预训练大语言模型(LLMs)进行微调,实现复杂工业系统(如高铁制动系统、化学工厂)的故障诊断任务,其表现比肩甚至超越了多种 SOTA 传统的机器学习和深度学习基线模型。
TL;DR
本文首次将预训练大语言模型(LLMs)引入复杂系统的故障诊断(Fault Diagnosis)领域。通过将传统的传感器数值表格转化为自然语言 Prompt,并结合 LoRA 技术进行微调,LLaMa-2 和 GPT-3.5 展现出了超越传统全连接神经网络(ANN)和 XGBoost 的诊断精度,尤其在处理数据缺失和少样本学习场景下表现出了极强的鲁棒性。
核心定位
该研究是 PHM(预测与健康管理)领域的先锋之作,它打破了“语言模型只能处理文本”的固有认知,证明了 LLM 内部蕴含的通用逻辑能力可以被成功迁移至非语言的工业时序任务中。
痛点深挖:为什么传统模型不够用了?
- 语义特征丢失:传统模型如 SVM 或 CNN 只处理数值 ,却不知道 代表“电压”而 代表“操作模式”。
- 数据质量挑战:工业现场常因传感器故障导致数据缺失。传统方法通常需要复杂的补全(Imputation)操作,否则预测准确率会断崖式下跌。
- 知识融合难:如何将专家的诊断建议(文字版)与传感器数据同步喂给模型?传统架构对此束手无策。
核心方法:LLM-Diagnosis 框架解析
该框架的核心步骤分为两步:
- Prompt 数据集转换:将表格列名(Feature Name)与数值(Value)拼接。例如:将“电压:220V”转换为“The voltage is 220V, what is the system state?”。
- LoRA 参数高效微调:为了避免全参数更新的高昂成本和“灾难性遗忘”,作者采用了 LoRA 技术,在冻结预训练权重的同时,引入低秩分解矩阵 和 进行更新。
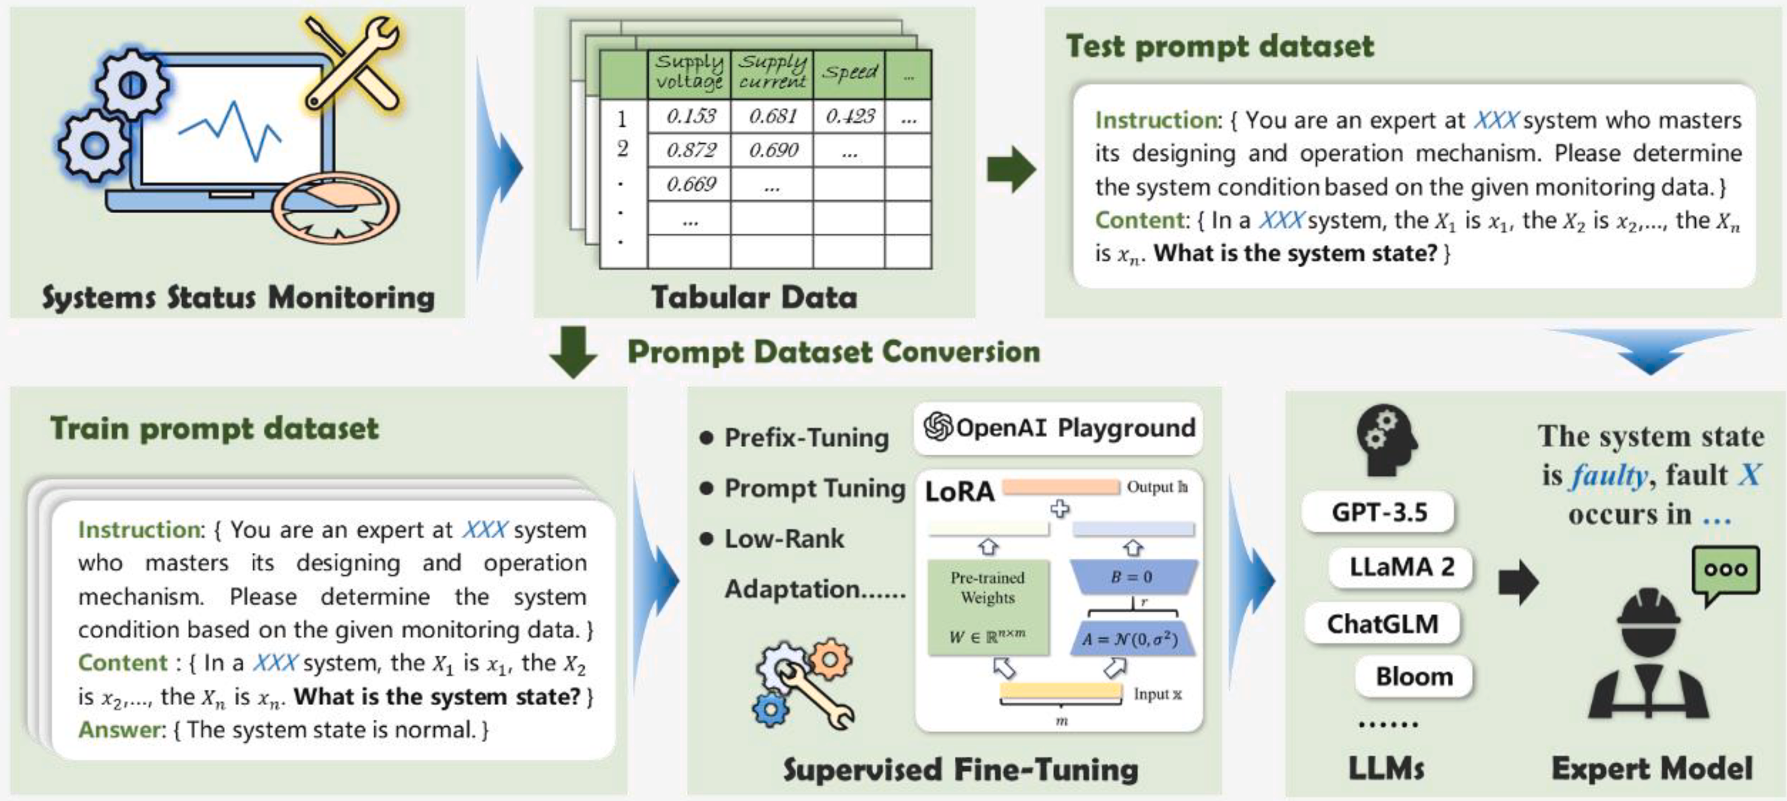 图 1:从传感器表格到 LLM 微调的全流程示意图
关键洞察:LLM 表现究竟如何?
1. 战胜 SOTA 基线
在高铁(HST)制动系统中,LLaMa-2 7B 模型在 Accuracy、F1-score 等多项指标上均达到 0.95 以上,优于传统的 CNN-SA(注意力卷积)和单维 CNN-XGBoost 混合方法。
2. 抗缺失值的“神级”鲁棒性
这是本研究最令人惊喜的发现。当训练数据包含 40% 的未知缺失值(标记为 "unknown")时,传统模型基本失效,而微调后的 LLM 依然维持在 0.85 左右的准确率。 物理直觉:LLM 凭借其强大的语义联想能力,即使某些特征缺失,也能通过其他相关特征的“语义上下文”推理出系统状态。
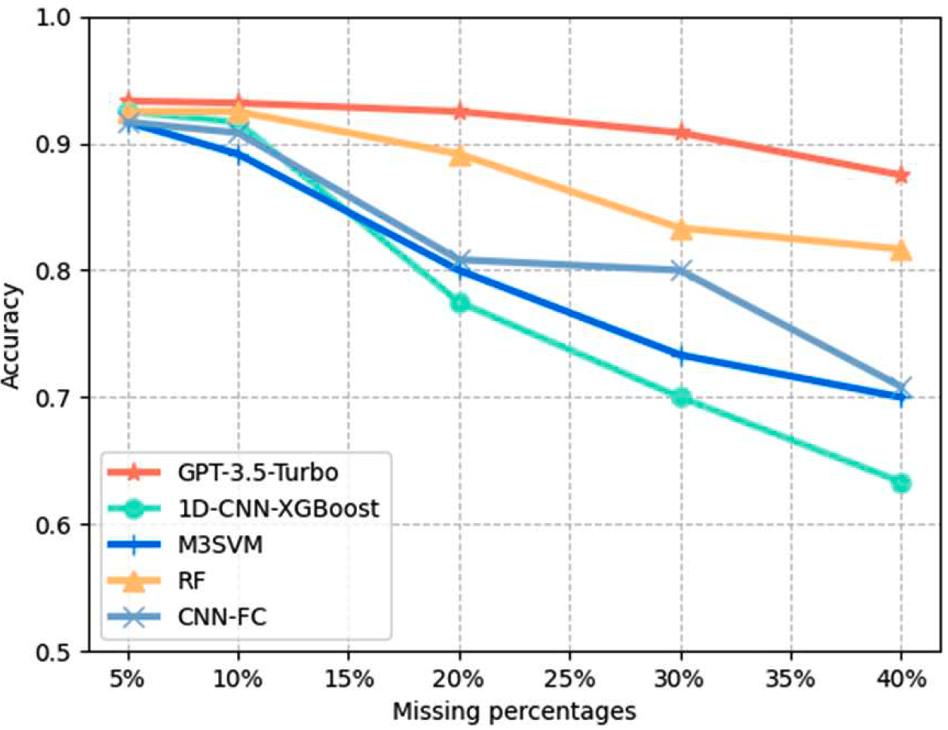 图 2:不同数据缺失比例下模型预测准确率的衰减对比
3. 可解释性:距离“真专家”还有多远?
尽管诊断准确率极高,但研究也客观指出:LLM 在逻辑推理方面存在困难。当要求模型解释“为什么判断有故障”时,LLM 容易出现“幻觉”(Hallucination),编造错误的物理阈值或逻辑。这说明 LLM 虽然捕捉到了特征间的统计关联,但并未真正理解物理系统背后的因果律。
深度思考与结论
- 语义红利:研究显示,如果删除特征名称(改为 x1, x2),LLM 的性能会暴跌。这证明了 LLM 确实在利用预训练中获得的物理常识辅助诊断。
- 少样本利器:仅需 50-200 个样本,LLM 即可展现出极强的迁移学习能力,这对于极端故障样本稀缺的工业环境极其有价值。
未来展望: 未来的工业诊断系统将是多模态的。正如作者所言,融合维修日志、视频监控和实时传感器的 LLM 系统,将彻底改变工业运维的规则。
Takeaway:大模型微调不仅是在做加法,更是在做“语义升维”。对于复杂系统的 PHM 任务,LLM 已经展现出了作为下一代通用诊断引擎的雏形。