
GTPO:突破多轮推理瓶颈,让大模型在工具使用中学会“深思熟虑”
Empowering Multi-Turn Tool-Integrated Reasoning with Group Turn Policy Optimization
本文提出了 GTPO (Group Turn Policy Optimization),一种专门针对多轮工具集成推理 (TIR) 任务设计的强化学习算法。通过引入回合级奖励分配、折扣回报优势估计和自监督奖励塑形,GTPO 在 Qwen2.5-7B 等模型上显著超越了 DeepSeek 提出的 GRPO 算法。
TL;DR
在强化学习(RL)赋能大模型的浪潮中,DeepSeek 的 GRPO 算法凭借省去 Critic 网络的简洁性成为了主流。然而,在涉及工具集成推理 (Tool-Integrated Reasoning, TIR) 的多轮复杂场景下,GRPO 粗放的轨迹级奖励导致了严重的信号稀疏问题。来自 UIUC、AWS 和 NVIDIA 的研究者提出了 GTPO (Group Turn Policy Optimization),通过将奖励粒度精确到“回合 (Turn)”、引入时空折扣因子以及自监督代码相似度奖励,在多个基准测试中显著超越了 GRPO,为 Agent 类型的推理任务树立了新标杆。
背景:为什么 GRPO 在多轮 TIR 任务中“哑火”?
在典型的多轮 TIR 任务中,模型需要经历“推理 -> 生成代码 -> 执行 -> 根据结果修正”的循环。现有的主流 RL 方法(如 GRPO)存在两个核心痛点:
- 信贷分配迷雾 (Credit Assignment Problem):GRPO 将整个推理过程视为一个简单的“赌博机”问题,无论中间经历了多少轮修正,最后只看最终答案给一个分。这导致模型无法感知哪一轮的工具调用是关键转折点。
- 稀疏奖励的折磨:在复杂数学题面前,模型生成的大多数轨迹都是错的。简单的二元奖励(0 或 1)让模型在错误中无法学习到那些“虽然最后错了,但中间代码写得很棒”的闪光点。
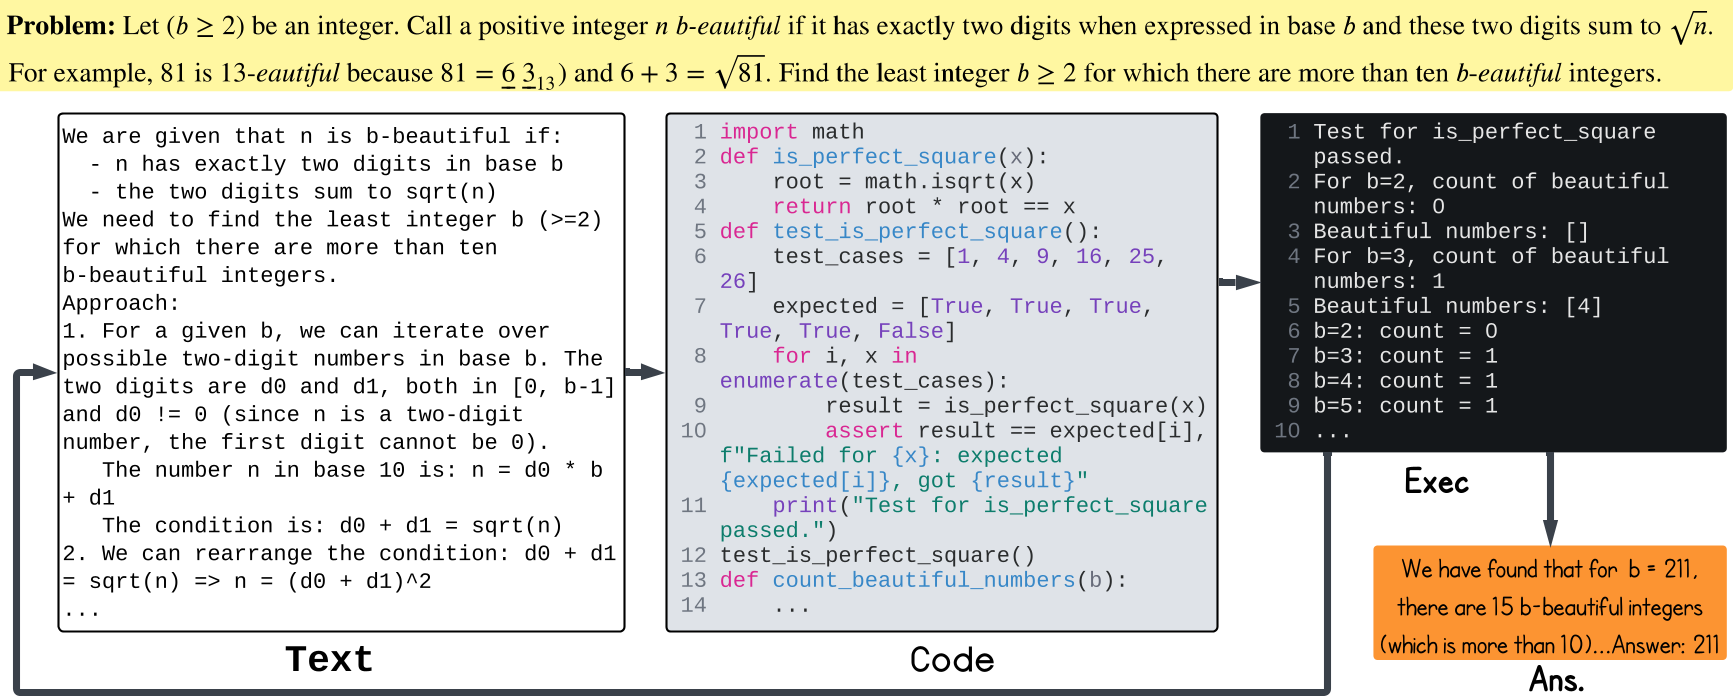 图 1:多轮工具集成推理 (TIR) 的标准流程:推理、工具调用、结果反馈的循环。
核心机制:GTPO 的三位一体改进
1. 回合级 MDP 的重构
不同于 GRPO 将整个 Sequence 作为一个 Action,GTPO 将每一轮(Turn)定义为一个 Action。这意味着状态空间 现在包含了之前的对话历史、工具返回结果,而奖励 则根据当前回合的格式规范和最终结果进行动态分配。
2. 带折扣的 Return 优势估计
借鉴传统在线 RL 的智慧,GTPO 引入了折扣因子 (实验证明 最优)。公式如下: 这种设计让模型学会为了长远的正确答案而优化当前回合的工具调用质量,解决了时空信贷分配的难题。
3. 自监督奖励塑形 (Reward Shaping)
这是 GTPO 最具灵气的创新。如果一个采样组(Group)里有正确答案,模型会提取正确答案里的代码。对于那些答错的轨迹,计算其代码各部分与正确代码的 Embedding 相似度,并将其作为“辛苦分”喂给模型。
- 直觉:代码是逻辑的浓缩。代码像,说明逻辑靠谱。
- 效果:即使最终没算对,只要代码逻辑在接近,模型就能获得正向反馈,极大地缓解了训练初期的探索困境。
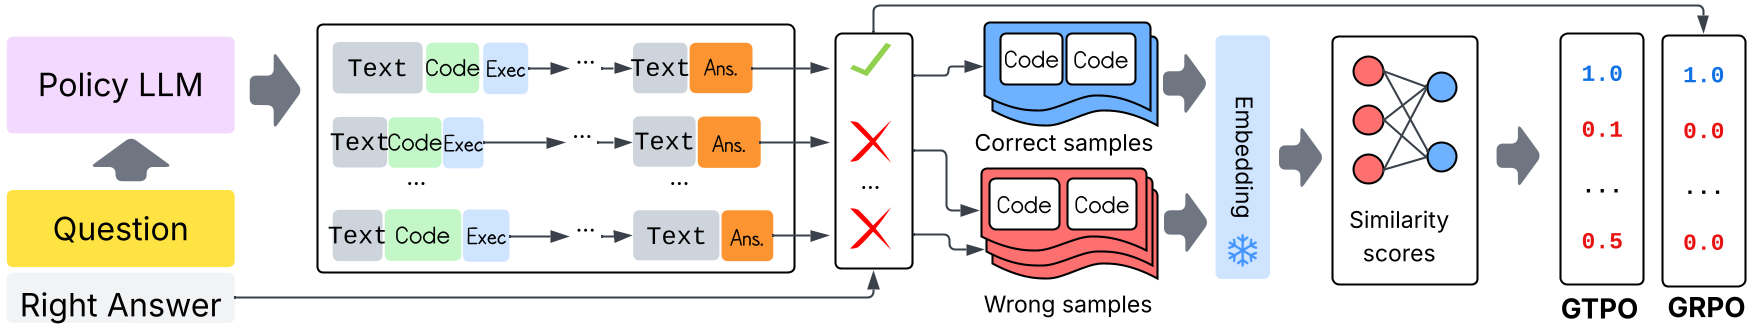 图 2:自监督奖励塑形:通过计算错误轨迹与正确轨迹的代码相似度来“加密”奖励信号。
实验战绩:全方位超越
研究团队在 Qwen2.5-7B 和 Llama-3.2-3B 上验证了 GTPO 的效力:
- 数学能力:在 AIME 2024、MATH 500 等硬核榜单上,GTPO 比 GRPO 稳步提升 3.0%。
- 泛化能力:这种提升不仅局限于数学,在 GPQA(常识推理)和 HumanEval(程序合成)上同样有效,涨幅最高达 3.9%。
- 执行力:GTPO 训练出的模型不仅更聪明,而且更“听话”。实验显示,其生成代码的运行成功率提高了 3% 左右,不再只是无意义地堆砌工具调用。
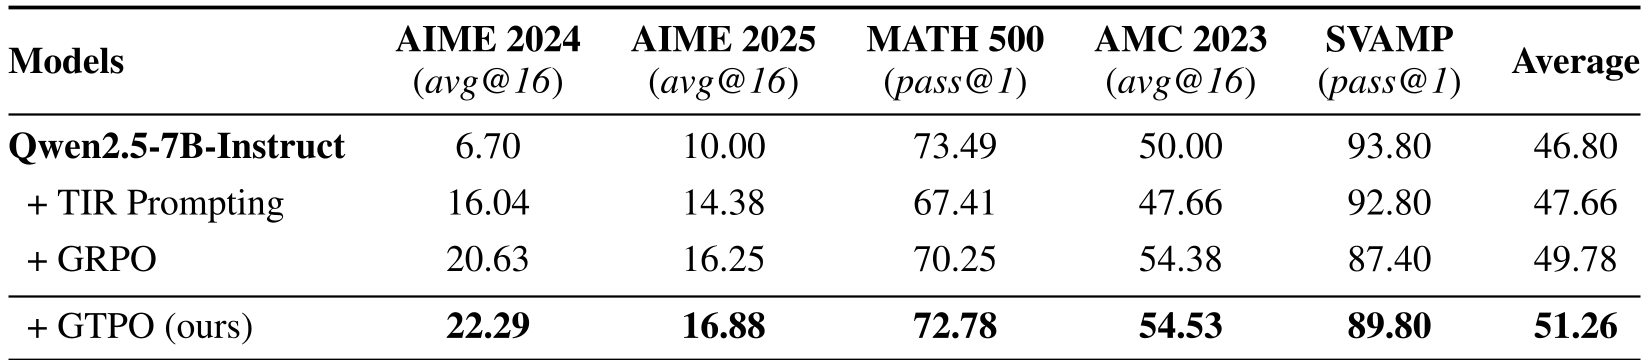 表 1:GTPO 在各数学基准测试中均显著优于基线模型。
深度洞察:为什么 GTPO 能赢?
通过消融实验可以发现,回合级奖励是提供基础稳定性的基石,而自监督奖励塑形则是加速收敛的关键。 一个有趣的观察是图 6 所示的“代码占比”:GTPO 训练的模型在早期就展现出极高的代码调用倾向(Code Ratio 接近 98%),而 GRPO 则显得步履蹒跚。这说明细粒度的反馈能让模型更快意识到:“在解决这些难题时,调用工具才是正确姿势。”
总结与局限
GTPO 成功的关键在于**“尊重多轮任务的时空逻辑”**。它并没有改变 Transformers 的结构,而是通过更先进的 RL 训练协议,挖掘出了模型在复杂 Agent 场景下的潜力。
局限性:目前的实验主要集中在 7B 规模的模型。在百亿、千亿级模型上,这种复杂的 Turn-level 序列处理是否会带来显存极度紧张的压力?此外,对于不需要调用工具的纯自然语言多轮对话,如何进行有效的自监督奖励塑形(没有代码可对比了)?这些都是未来的研究方向。
一句话评论:如果你正在构建处理长程任务的 AI Agent,抛弃粗放的轨迹级奖励,转向 GTPO 式的回合级优化将是你的必经之路。