
机器学习助力长期风电预测:跨越地理限制的智能评估
Energy Conversion and Management
本文提出了一种基于机器学习回归算法的长期风力发电量预测方法,利用每日平均风速和标准差作为输入特征。通过对比 LASSO, kNN, XGBoost, Random Forest (RF) 和 Support Vector Regression (SVR) 五种模型,实现在未知地理位置的年预测任务中达成 SOTA 性能。
TL;DR
风能作为清洁能源的核心,其长期电量预测一直是行业痛点。本文通过对比五种机器学习算法,提出了一种结合每日平均风速与小时级标准差的高精度预测框架。实验证明,该方法不仅在本地预测中 R² 高达 0.995,更具备强大的“跨区预测”能力,能为新电厂选址提供高效决策支持。
1. 痛点:为何长期风电预测如此困难?
在风电领域,短期预测(1小时至数天)由于观测连续性强,精度普遍较高。然而,**长期预测(提前一年)**面临以下局限:
- 随机性极强:风速受季候影响呈现极大的非平稳性。
- 模型泛化差:传统统计学方法(如 ARIMA)在处理非线性风速-功率转换关系(Power Curve)时力不从心。
- 选址盲区:在尚未落成风电场的“处女地”,由于缺乏历史功率数据,难以评估投资价值。
2. 核心直觉:捕捉数据背后的“波动性”
作者认为,单纯的每日平均风速掩盖了传感器在一日之内的波动细节。通过引入每日风速的标准差 (Standard Deviation),模型得以学到更精细的特征。例如,两个平均风速相同的日子,如果一个持续平稳,另一个剧烈波动,其通过风机功率曲线(Power Curve)转换出的总电量是完全不同的。
3. 方法论详解 (Methodology)
本研究构建了一个从数据预处理到算法决策的完整 Pipeline:
- 数据外推:利用 Power Law 将 10m 高度的观测风速外推至 50m 轮毂高度。
- 特征工程:计算每日 Mean Wind Speed 和 Standard Deviation。
- 物理建模:基于 1MW 风机的功率曲线(如下所示)生成 Ground Truth。
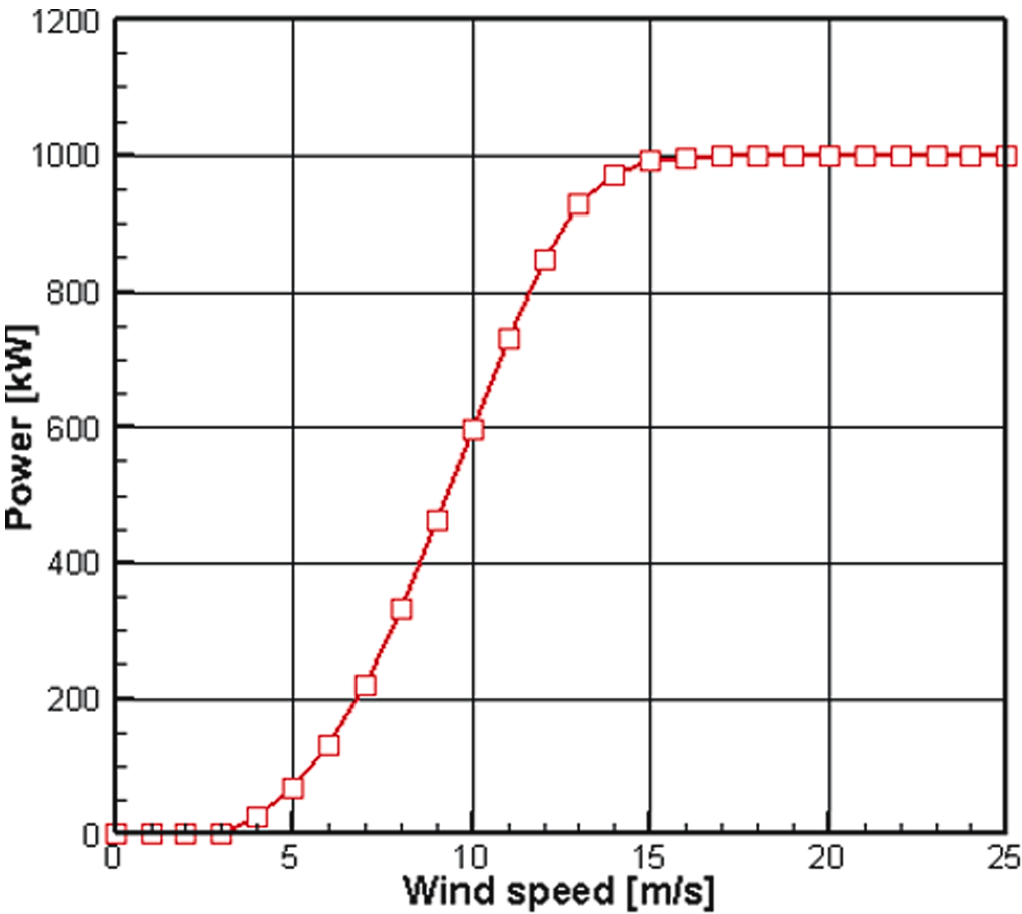 图 1: 实验采用的 1MW 风机典型功率曲线,展示了切入风速与额定风速的关系。
算法选型上,作者对比了线性模型(LASSO)和非线性模型(kNN, XGBoost, RF, SVR)。研究发现,Random Forest (RF) 在处理具有阈值特征(如风机的切入/切出风速)的数据时拥有天然的优势。
4. 实验战绩与深度分析
4.1 特征的价值:标准差是关键
实验分为有无标准差两个对比组。结果显示,加入标准差后,模型的平均绝对误差(MAE)显著下降。这印证了学术界的一个共识:在回归任务中,通过特征工程引入领域知识(即风机的非线性响应特性)比单纯调参更有效。
4.2 跨区预测:打破地域藩篱
这是本论文最具工程价值的部分。作者在土耳其的 Nigde 地区训练模型,并将其直接用于 Cesme, Bozcaada 等完全不同气候特征的地区进行测试。
 表 1: 跨区域测试结果。可以看到 SVR 和 RF 在异地测试中依然保持了极高的 R² 值。
即便在风速特征极其独特的 Bozcaada 地区,模型依然表现稳健。这证明了机器学习捕捉的是风速到功率的物理映射逻辑,而非简单的曲线拟合。
5. 总结与未来展望
核心贡献:
- 验证了机器学习在长期风电预测中的优越性,RF 算法以 0.995 的 R² 成为赢家。
- 证明了模型在不同地理坐标系下的可迁移性。
局限性: 该研究目前基于历史风速的“已知值”进行回测,在实际应用中,长期风速预测本身的误差(来自气象数值模式 NWP)仍将是影响最终功率预测精度的瓶颈。
未来启示: 未来的工作可以尝试将深度残差网络(ResNet)或时空图卷积网络(STGCN)引入,以进一步挖掘多个邻近站点间的时空相关性。