
CARD:强化扩散模型引导,反事实注意力破解推荐缺失数据难题
Enhancing guidance for missing data in diffusion-based sequential recommendation
本文提出了 CARD,一种基于反事实注意力调节的扩散模型,用于解决序列推荐中由于缺失数据导致的引导信号不可靠问题。CARD 通过动态区分序列稳定性并结合反事实推理,实现了 SOTA 的生成式推荐性能。
TL;DR
在序列推荐(Sequential Recommendation)领域,扩散模型因其卓越的生成能力正逐渐取代传统的判别模型。然而,现实场景中用户行为数据的**缺失(Missing Data)**会导致引导信号失真。本文提出的 CARD (Counterfactual Attention Regulation Diffusion) 模型,通过首创的“反事实注意力机制”,能够精准识别并放大用户兴趣转向的关键信号,在 Zhihu 等数据集上刷新了 SOTA 纪录,同时保持了极高的运算效率。
背景:生成式推荐的“阿喀琉斯之踵”
扩散模型在推荐中的核心逻辑是:在历史交互序列的“引导(Guidance)”下,通过去噪过程生成用户可能感兴趣的下一个项目(Oracle Item)。
早期的研究(如 TDM)发现,如果序列中存在大量冗余或缺失,引导效果会大打折扣。它们尝试通过删除局部相似的项目来简化序列,但这带来了一个严重的负面效应:误伤“兴趣转折点”。例如,用户从看“咖啡杯”转向看“咖啡豆”,这两个项目虽在局部不相似,却是理解用户意图跨越的关键桥梁。
痛点深挖:为何“补全”和“简单模拟”都不行?
- 补全陷阱 (Recovering-based):尝试预测缺失的项目。由于没有 Ground Truth,这本质上是“推测”,极易引入二次噪声。
- 局部模拟局限 (Simulating-based):如 TDM 基于局部相似度删除项目,这种做法默认了“相似即冗余”,却忽略了那些代表兴趣漂移(Interest Shift)的关键孤立点。
核心方法:CARD 的双路路由与反事实推理
CARD 的核心理念是不再简单地“删除”项目,而是**“动态重新赋权”**。
1. 稳定性评估与路由机制
CARD 首先对序列进行“稳定性检查”。
- 高稳定性序列:用户兴趣平稳,采用成熟的 DTS 策略去除冗余。
- 低稳定性序列:可能包含兴趣转向,进入 CARD 的核心模块——反事实注意力调节。
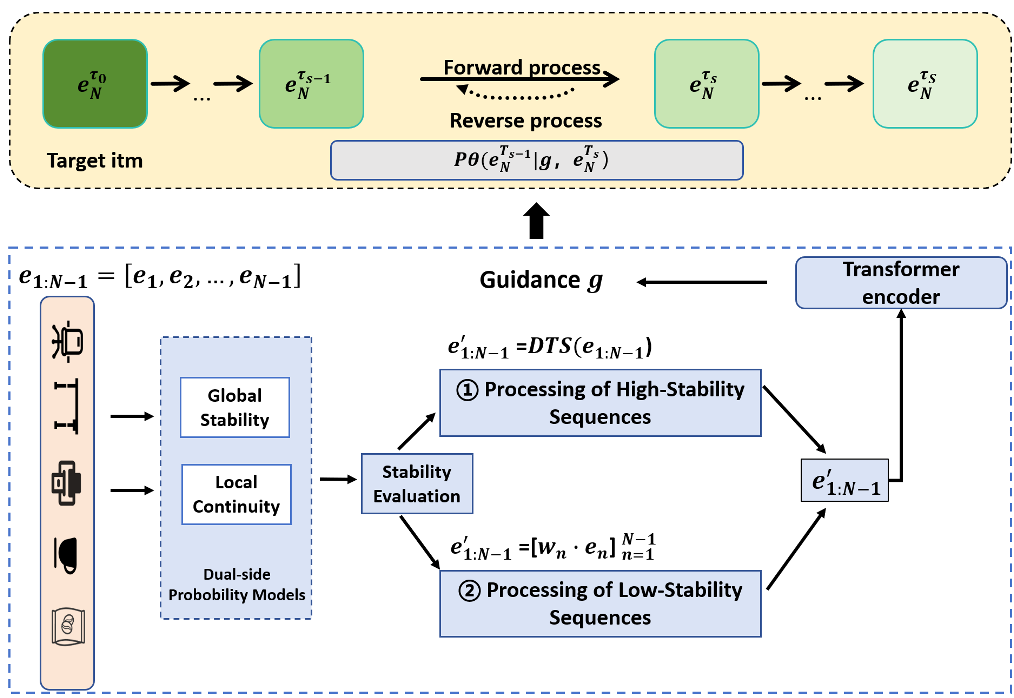 图 2:CARD 系统的三步流程:稳定性评估、分支处理、特征编码。
2. 反事实注意力:量化“贡献度”
这是本文最精彩的设计。作者利用**反事实推理(Counterfactual Reasoning)**来衡量一个项目的重要性:
- 实验组:包含当前项目 时,预测未来 个项目的误差。
- 对照组(反事实):剔除当前项目 时,预测未来的误差。
- PER (Prediction Error Reduction):两者的误差之差。
如果剔除某个项目后,模型对未来的预测大幅变差(PER 很高),说明该项目是不可或缺的“兴趣转折点”。CARD 会通过 1 + tanh(PER/T) 公式放大其权重;反之,若一个项目存在与否不影响预测,其权重会被抑制。
实验战绩:精度与效率的双重胜利
实验在 Zhihu 和 KuaiRec 两个真实数据集上展开。
1. SOTA 对比
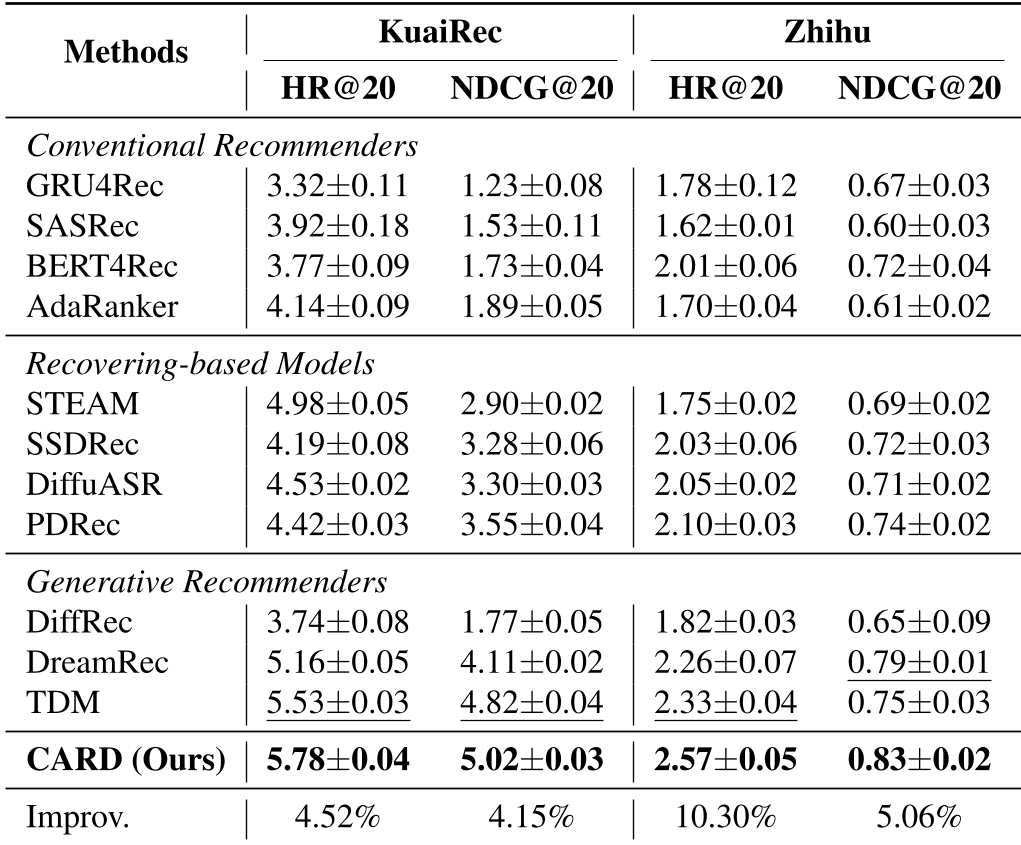
CARD 在所有指标上均优于现有的扩散模型(如 DreamRec, TDM)和数据恢复模型(如 PDRec)。在 Zhihu 数据集上,其 HR@20 提升了 10.30%,这是一个非常显著的增幅。
2. 训练效率
尽管引入了复杂的反事实计算,但得益于路由机制,CARD 仅对低稳定性序列进行计算。在 KuaiRec 上,其单轮训练时间(02m 40s)甚至低于 TDM(03m 30s),实现了“加量不加时”。
深度洞察
CARD 的成功证明了一个深刻的直觉:在处理不确定性数据时,因果贡献(Causal Impact)比表面相关性(Correlation)更重要。
- 局限性:模型依赖于一个辅助的预测任务来计算 PER,这要求辅助模型本身具有一定的预测强度。
- 未来展望:这种“反事实调节引导信号”的思路,完全可以迁移到多模态生成或 AI 智能体的长序列记忆管理中。
总结
CARD 为扩散模型在推荐系统中的落地提供了一个更加稳健的范式。它告诉我们,面对支离破碎的用户行为数据,不应盲目修补,而应通过智能的权重分配,让扩散模型“看清”那些真正指引未来的关键信号。