
ELERAG:打破语义迷雾,通过实体链接为 RAG 注核心“事实灵魂”
Enhancing Retrieval-Augmented Generation with Entity Linking for Educational Platforms
本文提出了 ELERAG,一种增强型检索增强生成(RAG)架构,通过集成基于 Wikidata 的实体链接(Entity Linking)模块来提升教育问答系统的准确性。该方法在意大利语教学数据集上,利用倒数排名融合(RRF)策略结合语义向量与实体信号,显著优于传统的 Cross-Encoder 重排序方法。
TL;DR
在 LLM 时代,RAG(检索增强生成)已成为减少幻觉的标准配置。然而,仅仅依靠向量相似度(Semantic Similarity)真的足够吗?本文提出的 ELERAG 证明了在教育等专业领域,结合 实体链接(Entity Linking) 的结构化信号,能比昂贵的 Cross-Encoder 模型更精准地定位正确知识,将检索准确率(Exact Match)提升至 56.5% 以上。
背景定位
目前大多数 RAG 系统是“语感强而逻辑弱”:它们能识别出两段话看起来很像,但分不清“Smith 教授”和“Smith 模型”在学术上下文中的本质区别。本文在领域坐标系中属于检索端的知识增强优化,特别针对非英语(意大利语)和垂直领域(高等教育课程)提供了重要的实战范式。
痛点深挖:语义搜索的“领域错配”
传统的稠密检索(Dense Retrieval)通常在通用数据集(如 Wikipedia)上预训练。当它面对大学讲义、专业经济学名词或复杂的通信术语时,会出现明显的领域错配(Domain Mismatch):
- 术语歧义:同一个词在不同学科含义迥异。
- 转录噪声:教育视频经 ASR(自动语音识别)转录后可能存在拼写偏差,导致向量偏离。
- 排序失效:Cross-Encoder 虽然强大,但在专业领域因缺乏上下文知识而无法胜任“最后 100 米”的精准排序。
核心方法:ELERAG 架构解析
作者提出了一种三流并行的增强架构,其精髓在于实体感知的重排序。
1. 实体链接模块(EL Module)
该模块不只是做 NER(命名实体识别),而是通过 API 将识别出的实体锚定到 Wikidata。
- 混合打分:结合了实体的流行度(Popularity)和上下文语义相似度。
- 去歧能力:通过唯一的 Wikidata ID,系统能明确知道用户问的是哪一个特定概念。
2. RRF-Based Re-ranking
这是本文的杀手锏。作者没有使用简单的线性加权,而是采用了 倒数排名融合(RRF)。
- 逻辑直觉:如果一个文档在语义检索和实体匹配中同时名列前茅,那么它的置信度将呈指数级增长。
- 平滑性:如果查询中没有检测到实体,系统会自动降级为标准的向量检索,不会像 Cross-Encoder 那样产生不可预测的错误分值。
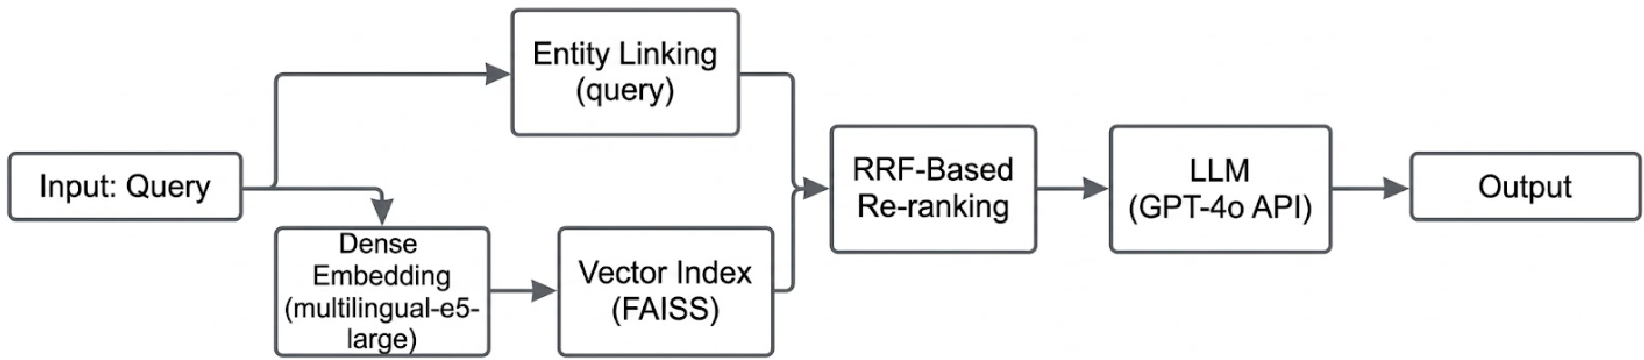
实验与结果:轻量级战胜重量级
在意大利语教育数据集(基于真实课程讲义)的测试中,实验结果令人惊讶:
| 策略 | EM (准确匹配) | MRR (平均排名倒数) | P@1 (精确率) |
|---|---|---|---|
| Standard RAG (基线) | 0.522 | 0.652 | 0.652 |
| ELERAG (RRF) | 0.565 | 0.668 | 0.696 |
| Standalone Cross-Encoder | 0.536 | 0.646 | 0.652 |
深度分析:
- 精准度飞跃:ELERAG 在 P@1 指标上显著优于强基线。这意味着系统最推荐的第一个片段往往就是正确答案,这对于上下文窗口有限的 LLM 极其关键。
- 领域反转效应:在通用领域(SQuAD-it),Cross-Encoder 依然是王者。但在教育垂直领域,ELERAG 反超!这证明了外部知识库(Wikidata)在垂直领域的补益作用远超模型的通用参数记忆。

深度洞察与总结
核心贡献
- 工程友好:ELERAG 的重排序是在离线预索引实体的基础上进行的,在线推断只需极轻量的 API 调用,避开了 O(L^2) 复杂度的 Cross-Encoder 重型推理,非常适合低算力教育场景。
- 非英语鲁棒性:通过多语言 Embedding 和 Wikidata,该架构具有天然的跨语言能力,对中文专业领域 RAG 亦有极强借鉴意义。
局限性与展望
尽管表现出色,但该方法重度依赖实体链接的质量。如果 ASR 转录严重失真,实体提取失败,性能就会回落至基线水平。未来可以探索如何将这种硬性的 ID 匹配与软性的神经图谱(Neural Graphs)进一步融合,以应对更模糊的非学术查询。
结论: 别迷信大模型的参数量,在工业级专业 RAG 应用中,通过实体链接引入的“事实锚点”才是真正的降本增效利器。