
Salesforce Koa:把 Agent Script 规格转化为企业工具调用的 GRPO 训练环境
An Enterprise Language Model for Agentic Tool Use
本文提出 Salesforce Koa,一个基于 Nemotron-3-Super-120B 并通过 GRPO 后训练得到的企业语言模型。其核心是把 Agent Script 声明式工作流规格转化为 persona-conditioned 多轮训练环境,并用接地任务覆盖率奖励驱动策略优化。实验显示 Koa 在 Tau2Bench、BFCL 和 CRM Bench 上均优于基座,多轮工具使用提升最明显,并能超过 GPT-4.1,但仍落后于更强的前沿闭源模型。
TL;DR
Salesforce Koa 是从 Nemotron-3-Super-120B 基座经过 GRPO 后训练得到的企业主语言模型,训练数据只用公开资源和合成数据,不使用客户数据。它的关键不是简单堆工具调用轨迹,而是把 Agent Script 这类声明式代理规格编译为可执行多轮环境,并用成功工具接地、子问题覆盖率和重复调用门控共同形成奖励。Table 1 显示,Koa 在 Tau2Bench 加权平均达到 69.41,在 BFCL 达到 66.63%,在 CRM Bench 达到 0.86,相对基座有稳定提升,并超过 GPT-4.1;不过它仍低于 GPT-5.5 和 Claude Opus 4.8 这类更强前沿模型。
背景定位
这是一篇方法改进型工业报告。它在开源基座后训练与 agentic RL 两条已有路线之间,插入了一条更偏企业系统工程的路线:不是只优化“调对函数”,而是优化“在多角色、多路由、多轮对话中最终解决任务”。论文把这一路线命名为 specification-driven RL,核心贡献是把 Agent Script 的声明式规格与 NeMo Gym 的在线 rollout、覆盖判断奖励连接起来。相比一般 BFCL 或 APIGen 风格工具调用工作,它更像是在训练一个企业 CRM 代理的运行策略,而不是训练一个函数解析器。
问题与动机
企业 agentic 系统的难点在于请求不会自然停在单轮函数调用上。一个销售支持任务可能先被 router 分派到某个 subagent,再暴露有限工具,再经过多轮用户补充信息,最后还要确认某个字段是否真的由系统工具返回。现有大量工具调用训练面向公共 API 和静态 schema,目标通常是“下一步是否调用正确函数”。但企业场景需要“整条会话是否解决问题”。这就产生两个具体失效机制。
第一,监督模仿缺少长时程目标。论文附录 C 和 J 显示,从已经深度后训练的基座出发,SFT 可以在 memory、relevance detection 和部分 AST 类别上提升,但 BFCL 多轮类别几乎没有进步。Table 3 报告 base 的 multi-turn average 是 54.12,SFT only 反而降到 53.25,而 RL only 达到 59.50。这个现象说明,只模仿单个 assistant 决策点,不足以让模型学会在多轮中承担沟通、等待、重试和终止的责任。
第二,奖励设计容易被 LLM judge 的宽泛性破坏。如果只要答案看起来合理就给高分,模型会学会绕过工具。论文因此要求:涉及客户或系统专有事实的子问题,只有答案由成功相关工具调用接地时才算 resolved;普通常识类陈述可以无需工具。这个约束把“看起来对”和“确实从企业状态里查对”区分开来。
核心方法:从 Agent Script 到接地奖励的 GRPO
从声明式规格到联合训练环境
企业域任务的起点是 Agent Script。一个规格定义 router、specialized subagents、typed actions、工具权限范围和自然语言 workflow instructions。论文描述了一个静态提取过程,把规格编译为 typed workflow graph,捕获每个工具的参数 schema、声明的状态副作用、路由条件和循环或终止配置。公共工具使用域没有 Agent Script 规格时,作者直接合成同样的 typed workflow graph,使两类来源都能进入同一个仿真和奖励机制。
这一步的本质变化,是把“代理配置”从部署期语言提升为训练期环境生成器。规格不再只是告诉推理时能调用哪些工具,而是告诉强化学习“任务如何展开、奖励如何判定、策略应该在哪种状态上学习”。当多个环境联合训练时,论文通过重复每个环境的样本再 shuffle 来实现差异曝光:
其中 是环境集合, 是某个具体环境, 是该环境的训练样本, 是每环境重复因子,Shuffle 打散混合后的样本。这个式子在论文中的作用是解释多域联合训练的样本权重如何形成:若某些企业环境更稀少但更重要,可以通过 提升曝光;若所有 都等于 1,则训练分布接近各环境样本数的自然比例。论文还明确 validation corpus 不上采样,因此验证奖励更接近真实环境占比。若没有这种显式 dispatch 和重复机制,单个小环境容易被大环境淹没,作者也无法在同一 run 中通过每行 agent_ref 分派多个环境。
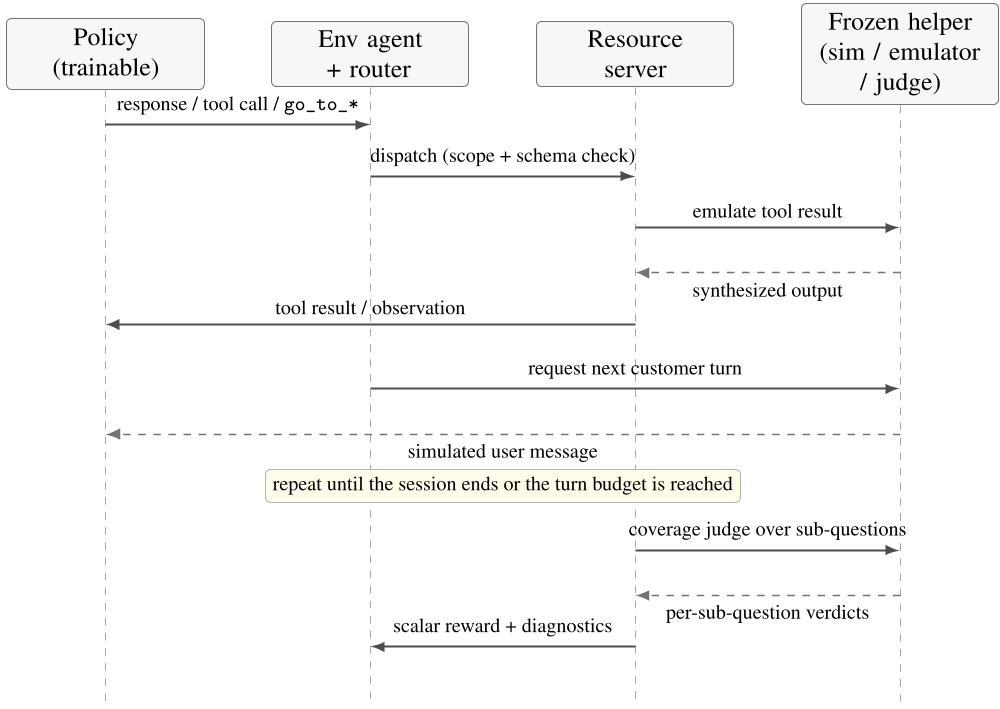
Figure 1 进一步展示了 rollout 的组件边界。实线是训练路径,虚线是 frozen helper 响应。策略模型是唯一被更新对象;客户模拟器、工具模拟器和覆盖判断器都来自同一个冻结 helper,不参与 GRPO 更新。这张图帮助理解为何奖励不是外部人工标注,也不是环境内隐式 oracle,而是由一个固定评价器在轨迹末端产生。
在线 rollout 与接地任务解决奖励
在线 rollout 中,每个样本都作为多轮交互展开。对于 simulated-dialogue 环境,一个 frozen Nano-30B helper 同时扮演三种角色:根据 persona 生成下一轮用户话语,模拟工具输出,以及作为 coverage judge 判断任务是否解决。奖励不是简单的二元 pass,而是基于任务意图中编号子问题的覆盖率:
其中 是该任务意图被拆分出的子问题总数, 是覆盖判断器判为 resolved 的子问题数,结果在 0 到 1 之间。missing 或 malformed verdict 默认计为未解决。这个式子在论文中的作用是把自然语言任务意图转化为细粒度、可解释的解决度信号;相比只看最终答案,它能区分“解决了三个子问题中的两个”这种中间状态。它的边界也很明显:如果 helper judge 对“已解决”判断不准,覆盖率会失真;因此论文要求依赖客户或系统专有事实的子问题必须有成功工具调用支撑,generic factoid 才可无工具解决。
为了抑制无限重试和循环调用,论文给覆盖率加上重复调用门控:
其中 在轨迹出现连续重复调用时等于 0,否则等于 1。这个式子在优化链条中承担标量奖励的角色:没有重复调用时,奖励就是覆盖率;一旦出现连续重复的 name 和 arguments 组合,即便部分子问题看似解决,奖励也直接归零。这个选择并非无代价。若一个环境允许同一参数在状态更新后合法重试,或者用户中途澄清后需要相同查询再试,严格门控可能抑制合理策略。论文没有报告这类误伤的具体比例,但从设计上看,它优先追求行为安全,避免模型用刷工具调用换取部分分数。
环境并非同一种形态。Table 2 比较了论文使用的三类训练环境:
| 环境类型 | 交互拓扑 | 验证方式 |
|---|---|---|
| 扁平客服 | 单个代理直接调用该会话公开的全部工具,persona 条件化模拟客户 | 子问题覆盖判断器加重复调用门控,judge prompt 要求数据绑定问题由成功工具接地 |
| 路由客服 | 增加 router 和 specialized subagents,通过 go_to_* 切换,越界调用返回 wrong-subagent 错误,每次切换追加 focus 系统消息 | 同样使用覆盖奖励与重复调用门控,并加入域特定 scope 和 grounding 规则 |
| 确定工具沙盒 | 单个代理运行有状态工具,没有模拟客户,也没有 helper | 二元状态等价:预测动作产生的最终状态与参考动作匹配时才得 1,否则为 0 |
这张表说明 Koa 的训练并非只用一种“对话式成功”。扁平客服和路由客服使用 LLM judge 的覆盖率,更贴近企业支持中“用户是否被解决”;确定工具沙盒则使用状态等价,更接近后端系统验证。两类奖励互补:覆盖率让奖励可拆分、可诊断;状态等价在可执行工具上提供更硬的真值。论文还强调工具列表是 per rollout 而不是全局,因此策略只能看到当前会话或当前 subagent 合法暴露的工具,这比一次性给所有 API 更贴近生产部署。
GRPO 优化与单步约束决策
优化目标是最大化期望轨迹奖励。论文使用 GRPO 的组内采样和 leave-one-out advantage,不训练 value network:
其中 表示同一 prompt 组内的一条轨迹, 是该轨迹的标量奖励, 是不包含 的组内均值基线, 是不包含 的组内标准差, 是平滑项, 是对称裁剪上界。这个式子的作用是把不同环境、不同任务难度的奖励差异归一化为相对优势,让组内表现更好的轨迹获得正梯度,表现更差的轨迹获得负梯度。它的适用边界很明确:dynamic sampling 会丢弃零方差组并重采样直到凑满 batch;若一组轨迹全部得到相同奖励,就没有学习信号。
策略损失采用序列内 token 平均,再对轨迹求均值:
其中 是 batch 中轨迹数, 是轨迹 的生成 token 序列, 是其长度, 是 prompt 或初始对话上下文, 是上面的轨迹优势, 是 token 级截断重要性权重。论文指出,每个 rollout batch 只做一次 on-policy update,并强制 policy ratio 为 1,因此 PPO clip 项不起作用,也不加 reference KL。 用来修正训练时 log probability 与生成时 log probability 的不一致。先在轨迹内平均再跨轨迹平均,可以防止更长的失败 rollout 单纯因 token 数多而主导梯度。
除了完整轨迹训练,论文还用附录 F 的 single-step mode 处理“少数但决定性”的约束决策轮。例如某个工具在该轮被故意 withholding,用户却要求列表,此时正确行为不是乱调近名工具,也不是继续写入状态,而是向用户说明限制或请求澄清。其单步奖励为:
其中 是被隔离的 constrained decision turn, 是程序性门控,只有当该轮没有提前进行状态改变调用时才为 1; 是后果分数,衡量桥接消息恢复工具后,recovery turn 是否发出被 withholding 的调用,并按函数名和类型感知参数比较匹配。这个设计的关键在于只优化真正困难的那一步:recovery turn 仅用于计算奖励,不进入梯度轨迹;因此策略从“当前轮是否克制”中学习,而不是从后续恢复动作中直接模仿。论文还报告一个边界案例:如果只训练 mid-conversation 约束状态,turn-0 约束会回退;加入 turn-0 生成后恢复。这说明约束决策的空间位置会改变泛化,不能只采中间轮。
实验与证据
主结果来自 Table 1,对比了三个公开或企业内部基准:Tau2Bench、BFCL 和 CRM Bench:
| 模型 | Tau2Bench加权平均 | BFCL准确率 | CRM Bench总体 |
|---|---|---|---|
| Claude Opus 4.8 | 74.00 | 78.18 | 0.87 |
| OpenAI GPT-5.5 | 83.99 | 67.63 | 0.90 |
| OpenAI GPT-4.1 | 54.48 | 53.96 | 0.81 |
| Nemotron-3-Super-120B | 68.64 | 64.73 | 0.84 |
| Salesforce Koa | 69.41 | 66.63 | 0.86 |
这组数字支持论文的核心判断:Koa 确实优于自己的开源基座,但优势幅度在三个基准上并不一致。Tau2Bench 加权平均只比 base 高 0.77,BFCL 高 1.90,CRM Bench 高 0.02;相对 GPT-4.1,Koa 在 Tau2Bench 高 14.93,在 BFCL 高 12.67,在 CRM Bench 高 0.05。Table 1 还显示 Koa 的 CRM 函数调用准确率为 0.77,高于 base 的 0.71。整体看,Koa 是“超过一个强但并非最强的专有基线”,不是“追上前沿模型”。
更细的多轮工具使用证据来自 Table 3。该表给出完整 BFCL 分项,下表选取总体和多轮相关类别:
| 配置 | BFCL总体 | 多轮工具使用平均 | 缺少函数 | 缺少参数 | 长上下文 |
|---|---|---|---|---|---|
| Nemotron-3-Super-120B | 64.73 | 54.12 | 42.50 | 47.50 | 59.50 |
| SFT only | 65.03 | 53.25 | 45.50 | 44.00 | 55.50 |
| RL only | 66.63 | 59.50 | 54.00 | 51.00 | 62.00 |
Table 3 的多轮类别是理解这篇论文的关键。SFT only 的总体略高于 base,但多轮平均从 54.12 降到 53.25;RL only 则把多轮平均提高到 59.50,并在缺少函数、缺少参数和长上下文子类别上都高于 SFT。这说明 spec-driven RL 的提升并非泛泛“更会用工具”,而是集中在需要跨轮纠错、等待信息和长上下文决策的能力上。附录 J 的 Tau2Bench 表则提供另一面:SFT only 加权平均 70.04,RL only 69.41,base 68.64,因此单看 Tau2Bench,SFT 甚至略高。这个反差提醒读者,不能把 SFT 与 RL 简单排序;能力结构不同,单轮模仿可能帮助局部动作格式,RL 更影响长时程解决。
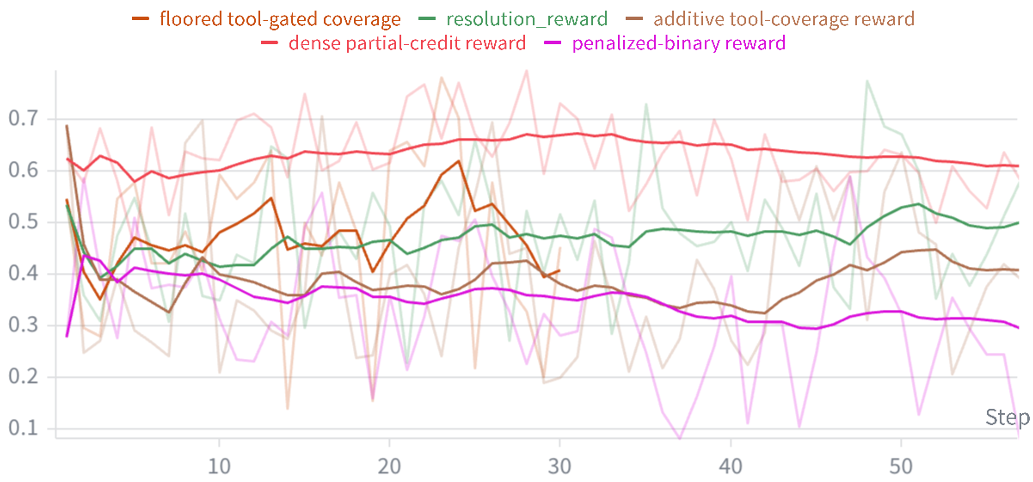
Figure 3 展示了 reward engineering 的消融。论文在 Nano-30B 代理上比较多种奖励:penalized binary、dense partial credit、additive tool-coverage、floored tool-gated coverage,以及最终的 gated coverage。图注明确说明每条曲线是各自 run 的自有奖励,绝对值不可横向比较,只有趋势有意义。最终门控覆盖率趋势向上且稳定;penalized binary 下行;additive 和 floored 变体 noisy 或 flat-to-declining;dense partial credit 曲线看起来最高,只是因为部分得分膨胀了自身标量,属于 reward hacking。这个证据解释了为什么作者拒绝给中间过程太多直接奖励,而坚持把奖励压在“任务解决 + 工具接地 + 防止重复调用”上。
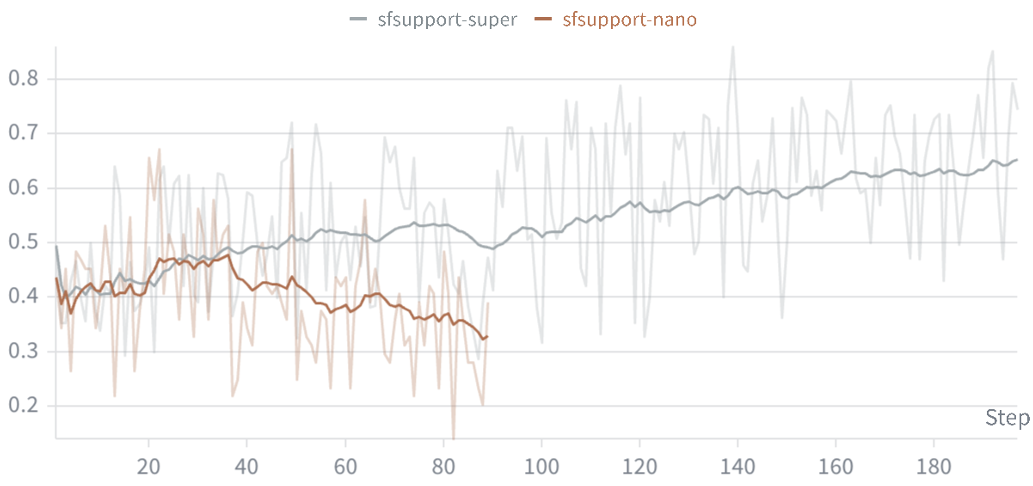
Figure 4 揭示了另一个重要边界:奖励稳定并不完全由奖励形状决定,也受模型规模影响。论文称同一 gated-coverage 奖励在 Super-120B 策略上使 task resolution score 在约 200 步内稳定提升到约 0.65,但在 Nano 代理上约 step 30 峰值约 0.47 后 collapse 到约 0.33。这个现象说明 Koa 的 120B 结果不能简单外推到小模型;即使使用最终奖励,小模型也可能无法维持训练稳定性。它也更支持把奖励工程放在代理模型上做快速筛选,再移植到大策略上验证的实践逻辑。
证据质量与适用边界
从证据结构看,论文最强的是多基准一致性:Koa 相对 base 的提升在 Tau2Bench、BFCL、CRM Bench 上都存在,而多轮子类别的 Table 3 提供了机制性解释。论文还做了两个有用控制:第一,训练 helper 与离线 judge 分离,避免训练期 helper 失败污染最终 benchmark;第二,附录 J 的 scoped SFT-versus-RL 比较显示,RL 对多轮工具使用更关键,SFT 更像单轮行为修正。
但结论的适用边界同样清楚。所有 checkpoint 都以 vLLM BF16 服务,Tau2Bench 使用 GPT-4.1 user simulator,四 trial 的 pass^1 平均;这些设置有利于复现,却不等同于生产部署。更关键的是,base 本身已经是 RL-post-trained,因此 SFT 与 RL 的相对优势不能从“预 RL 基础模型”外推。论文在 conclusion 中也明确把这一发现称为 scoped observation。另一个不确定来自 LLM judge:coverage judge 使用冻结 helper,要求数据绑定子问题由成功工具接地,但“成功相关工具调用”的判断仍依赖 helper 本身。若 helper 把无关工具输出误判为 grounding,或把未真正解决的用户问题判为 resolved,GRPO 就会放大这种偏差。
最后,Koa 没有追上最强的前沿闭源模型。Table 1 中 Claude Opus 4.8 的 BFCL 为 78.18,GPT-5.5 的 Tau2Bench 为 83.99 和 CRM Bench 为 0.90,都明显高于 Koa。因此这项工作更像是在证明“开源基座可以通过规格驱动 RL 专化到企业 agentic 任务”,而不是宣称已经解决企业 agentic 性能天花板。
深度洞察与总结
Salesforce Koa 的真正价值,不在某个单点算法,而在把企业代理工程资产重新定义为训练资产。Agent Script 的 router、subagent、tool scope 和 workflow instruction 本来用于部署,被论文编译成 rollout 环境的骨架,又通过覆盖判断器连接到奖励。这形成了一条清晰的闭环:作者写什么工作流规格,策略就在什么多轮环境中优化;作者定义什么数据问题必须由工具解决,奖励就惩罚什么虚假 grounding。相比通用 tool-use RL,这一路径更贴近 CRM 这类业务系统的组织方式。
局限也必须具体。其一,最终 gated coverage 只在 Figure 3 的 Nano proxy 上做了奖励形状筛选,Figure 4 又显示小模型会崩溃,因此奖励设计对模型规模和训练配置敏感。其二,SFT 与 RL 比较依赖已经 RL 后训练的 Nemotron base,不能泛化到普通预训练或指令模型起点。其三,CRM Bench 提升幅度较小,Koa 为 0.86,base 为 0.84,而 GPT-5.5 为 0.90,说明单轮 CRM 适配仍有未闭合差距。其四,论文没有报告客户生产环境中的在线指标、失败恢复成本、人工审核比例或工具误调用造成的业务损失。
面向后续工作,有三个方向更有技术含量。第一,可以在从 pre-RL 基础模型开始的 SFT-then-RL 课程中重新检验这篇论文 scoped comparison,判断 SFT 是否能作为奖励塑形前的行为先验。第二,可以把 coverage judge 从单一 frozen helper 升级为可验证 schema checker、确定性状态 diff 和受限工具调用审计器的组合,降低 LLM judge 的接地偏差。第三,可以把 constrained decision turn 的 single-step 训练扩展到权限审批、数据保留策略和不可逆写入等更强企业治理场景,让“何时不调用工具”成为一等优化目标,而不是长轨迹奖励的副产品。