
EOPD:解决在线蒸馏中的“盲目跟风”,让小模型学会教师的深思熟虑
Entropy-Aware On-Policy Distillation of Language Models
本文提出了熵感知策略下的在线蒸馏方法 EOPD (Entropy-Aware On-Policy Distillation)。该方法根据教师模型在不同 token 位置的置信度(熵值)动态切换优化目标,成功在保持在线训练效率的同时,在 6 个数学推理基准测试中显著提升了 Pass@8 准确率(如 Qwen3-4B 提升 +5.05%)。
TL;DR
在线蒸馏(On-Policy Distillation)虽然高效,但长期受困于其核心损失函数——逆 KL 散度(Reverse KL)的副作用。本文提出的 EOPD (Entropy-Aware On-Policy Distillation) 发现:逆 KL 会把学生模型变得“武断”,使其丢弃教师模型在复杂连接处保留的多样性。通过在教师模型高熵(不确定)的位置精准引入前向 KL,EOPD 在不显著增加计算开销的前提下,在 Qwen3-4B 上实现了推理性能的跨越式提升(Pass@8 +5.05%)。
背景定位
该工作属于大模型后期对齐与蒸馏的前沿研究,是在最近流行的 OPD (On-Policy Distillation) 基准之上的重要理论与实践补充。它不仅在 SOTA 刷榜上表现优异,更从数学本质上回答了“为什么简单的概率对齐在复杂推理任务中会失效”。
痛点深挖:逆 KL 的“过拟合”陷阱
在目前的 LLM 推理模型(如 O1, DeepSeek-R1 等)蒸馏中,On-Policy 训练已成为标准范式。它的直觉是:让学生模型沿着自己的思维路径生成,由教师模型实时纠正。
然而,工业界常用的逆 KL 目标函数()存在天然缺陷:它只鼓励学生去对准老师概率最高的一两个点(Mode-seeking)。
- 现象:当老师觉得有三个词(A, B, C)各有 30% 的概率都很合理时(高熵场景),逆 KL 会逼迫学生只选其中的一个。
- 后果:学生模型的生成变得单调(Diversity Collapse),在面对需要发散思维的数学难题时,这种“视野狭窄”直接导致了 Pass@k 性能的瓶颈。
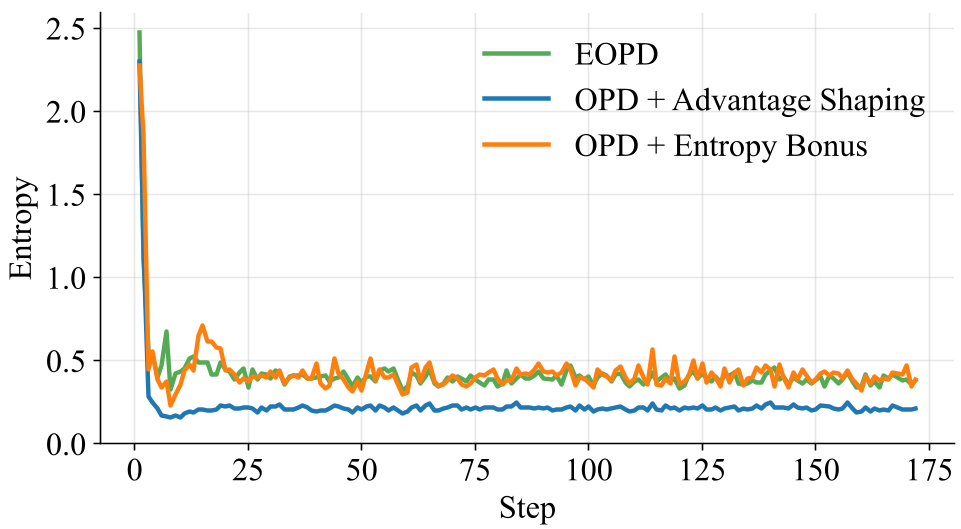 图注:观察 Figure 3 可以看到,标准 OPD 模型(橙色)在高熵区域的 token 占比远低于教师模型(蓝色),而 EOPD(绿色)则完美贴合了教师的分布。
核心方法:熵感知的目标切换 (EOPD)
作者并没有盲目地全面替换损失函数,因为前向 KL(Forward KL)虽然能覆盖所有模式,但在在线训练中计算开销巨大且收敛缓慢。
1. 物理直觉:看人下菜碟
EOPD 提出了一个极其优雅的准则:
- 低熵区域(老师很笃定):继续用逆 KL。老师都说这就是唯一真理了,学生直接学最强的那个 Mode 效率最高。
- 高熵区域(老师在纠结):切成前向 KL。老师在这里犹豫说明存在多个合理的推理路径,学生必须把老师对 A, B, C 的概率分布“整体搬运”过来。
2. 数学表征
其总损失函数定义为: 其中 是教师在 位置的熵。只有当熵超过阈值 时,才激活前向 KL 惩罚项。
3. 效率优化
为了解决显存瓶颈,EOPD 仅在教师预测的前 16 个(Top-k)token 上计算前向 KL。图表显示,Top-16 已涵盖了绝大部分概率质量,而显存消耗仅为全量的 1/7。
实验与战绩:更强的搜索能力
实验在 Qwen3 全系列上展开,覆盖了从 0.6B 到 4B 的参数规模。
1. 核心提升
在数学竞赛基准 AIME 和 AMC 上,EOPD 表现出了碾压性的优势。
- Qwen3-4B:在六项数学任务的 Pass@8 平均提升达 +5.05。
- 外推能力:即便只在数学数据上训练,EOPD 在通用推理(MMLU-Pro)和科学问答(GPQA)上也优于标准 OPD。
2. 为什么 Pass@k 提升更多?
这是一个关键洞察:由于 EOPD 保留了高熵位置的多样性,当我们在推理时增加采样次数(k 变大)时,EOPD 找到正确解的概率增长曲线远比 OPD 陡峭(见下图)。这说明 EOPD 的学生真正学到了“条条大路通罗马”的灵活性。
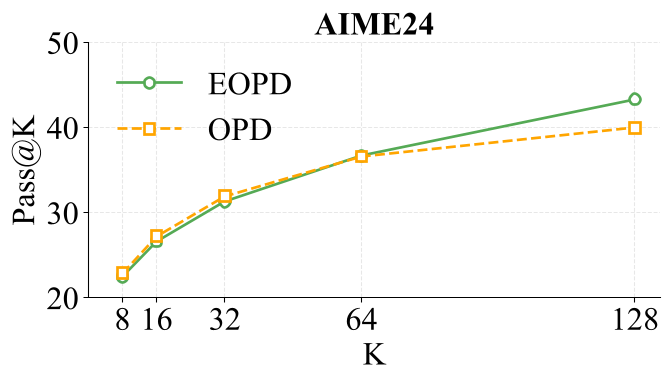 图注:Figure 2 展示了随着采样频率 k 增加,EOPD 与标准 OPD 的差距越拉越大,展现了极强的长尾搜索能力。
深度洞察与总结
主编点评: 这篇论文的精妙之处在于它意识到:蒸馏不只是学老师的“对”,还要学老师的“犹豫”。在推理任务中,错误往往发生在那些模棱两可的分支点上。如果学生模型只学会了老师的一个 Mode,它就失去了在复杂问题中回溯、修正和探索其他可能性的能力。
局限性: 虽然 EOPD 在数学任务上表现优异,但其性能高度依赖于教师模型的质量。如果教师模型的高熵部分仅仅是由于预训练不充分导致的噪声而非真实的“推理分支”,那么强制模仿这种高熵分布可能会引入冗余。
未来展望: 该方法可以与最新的 COT (Chain-of-Thought) 逐步奖励模型(PRM)结合。如果能根据中间步骤的“逻辑熵”来动态蒸馏,或许能进一步压榨出小模型的逻辑极限。