
Papo:解构 RLVR 训练中的熵力学,实现高效率推理微调
Entropy Polarity in Reinforcement Fine-Tuning: Direction, Asymmetry, and Control
本文提出了名为 Papo (Polarity-Aware Policy Optimization) 的强化学习微调框架,通过引入“熵极性 (Entropy Polarity)”这一 Token 级度量,精确量化采样更新对策略熵的扩张或收缩影响。在数学推理和智能体任务中,Papo 在 Qwen2.5 等模型上取得了显著的 SOTA 性能及更高的训练效率。
TL;DR
复旦大学 NLP 团队等机构的研究者们在论文中提出了一套关于 熵力学 (Entropy Mechanics) 的理论框架。他们发现,并非所有的强化学习更新都对模型的多样性有益。通过识别 熵极性 (Entropy Polarity),他们开发了 Papo 算法,能够通过自适应调整 Token 级别的权重,在保护模型“探索能力”的同时,极大提升了数学推理和 Agent 任务的性能与训练速度。
背景定位
在可验证奖励强化学习(RLVR,如 DeepSeek-R1 的范式)中,**探索(Exploration)与利用(Exploitation)**的平衡是核心难题。过度利用会导致“熵塌陷”,模型变得僵化;而过度探索则会让模型收敛缓慢。Papo 不是简单的“缝补”,而是从数学底层入手,首次回答了:当我们在强化一个特定的 Token 时,策略熵到底发生了什么?
熵极性:理解更新的“正负能量”
作者通过对 Softmax 策略的一阶泰勒展开,拆解出了影响熵变化的两个关键项:
- 采样项 (Sampled-token term):决定了强化该 Token 是让分布变尖锐(收缩)还是变平滑。
- 分布修正项 (Distributional correction):一个全局的修正力。
核心洞察(Asymmetry):研究发现强化高概率(常见)的 Token 会天然触发熵收缩,而熵扩张则需要强化低概率样本。这种非对称性解释了为什么“熵塌陷”在 RL 训练中极易发生且难以逆转。
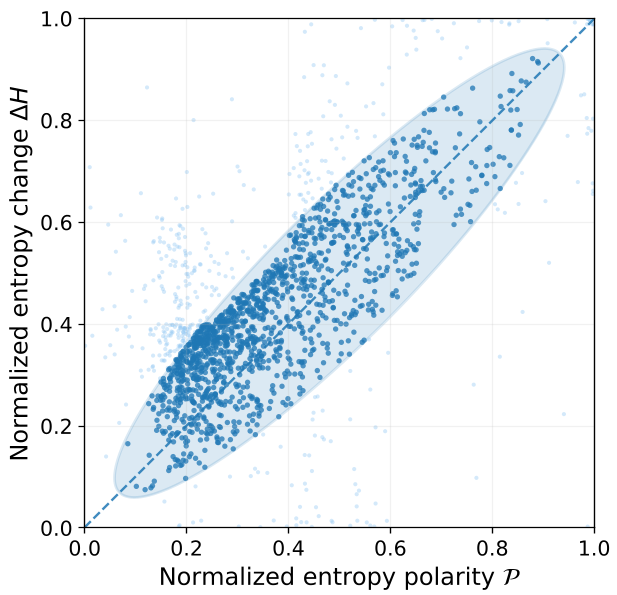 图 1:熵极性 P 能够精准预测实验中观察到的实际熵变化 ΔH,且呈现长尾分布。
Papo 算法:自适应的分支控制
基于上述理论,作者设计了 Papo (Polarity-Aware Policy Optimization)。其核心逻辑非常直控:
- 监控熵轨迹:将训练过程中的熵下降斜率作为在线信号。
- 极性重赋权:如果熵下降太快(面临塌陷),则调低“熵收缩分支”的权重,放大“熵扩张分支”的权重以保护探索。
- 阶段性转换:当训练稳定后,逐渐恢复对“利用”的压力,确保性能提升。
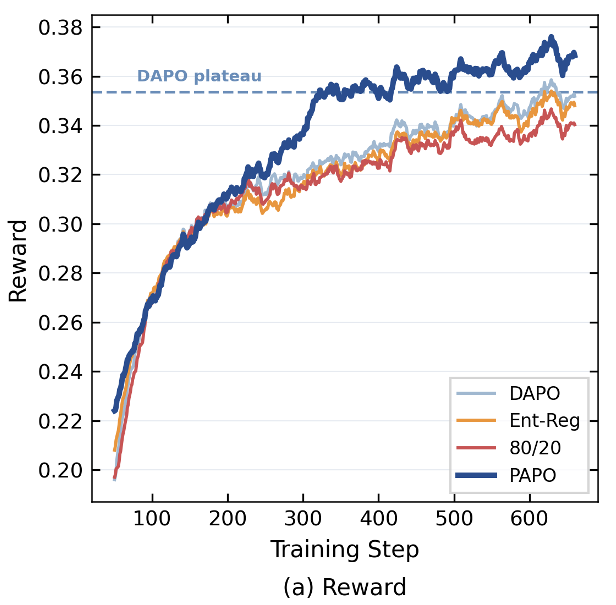 图 2:Papo 展示了非单调的熵路径——通过中期适度收缩换取更高的最终奖励和更健康的熵水平。
实验结果:速度与质量的双重飞跃
在复杂的数学推理榜单(如 AIME, OlympiadBench)上,Papo 展现了傲人的战绩:
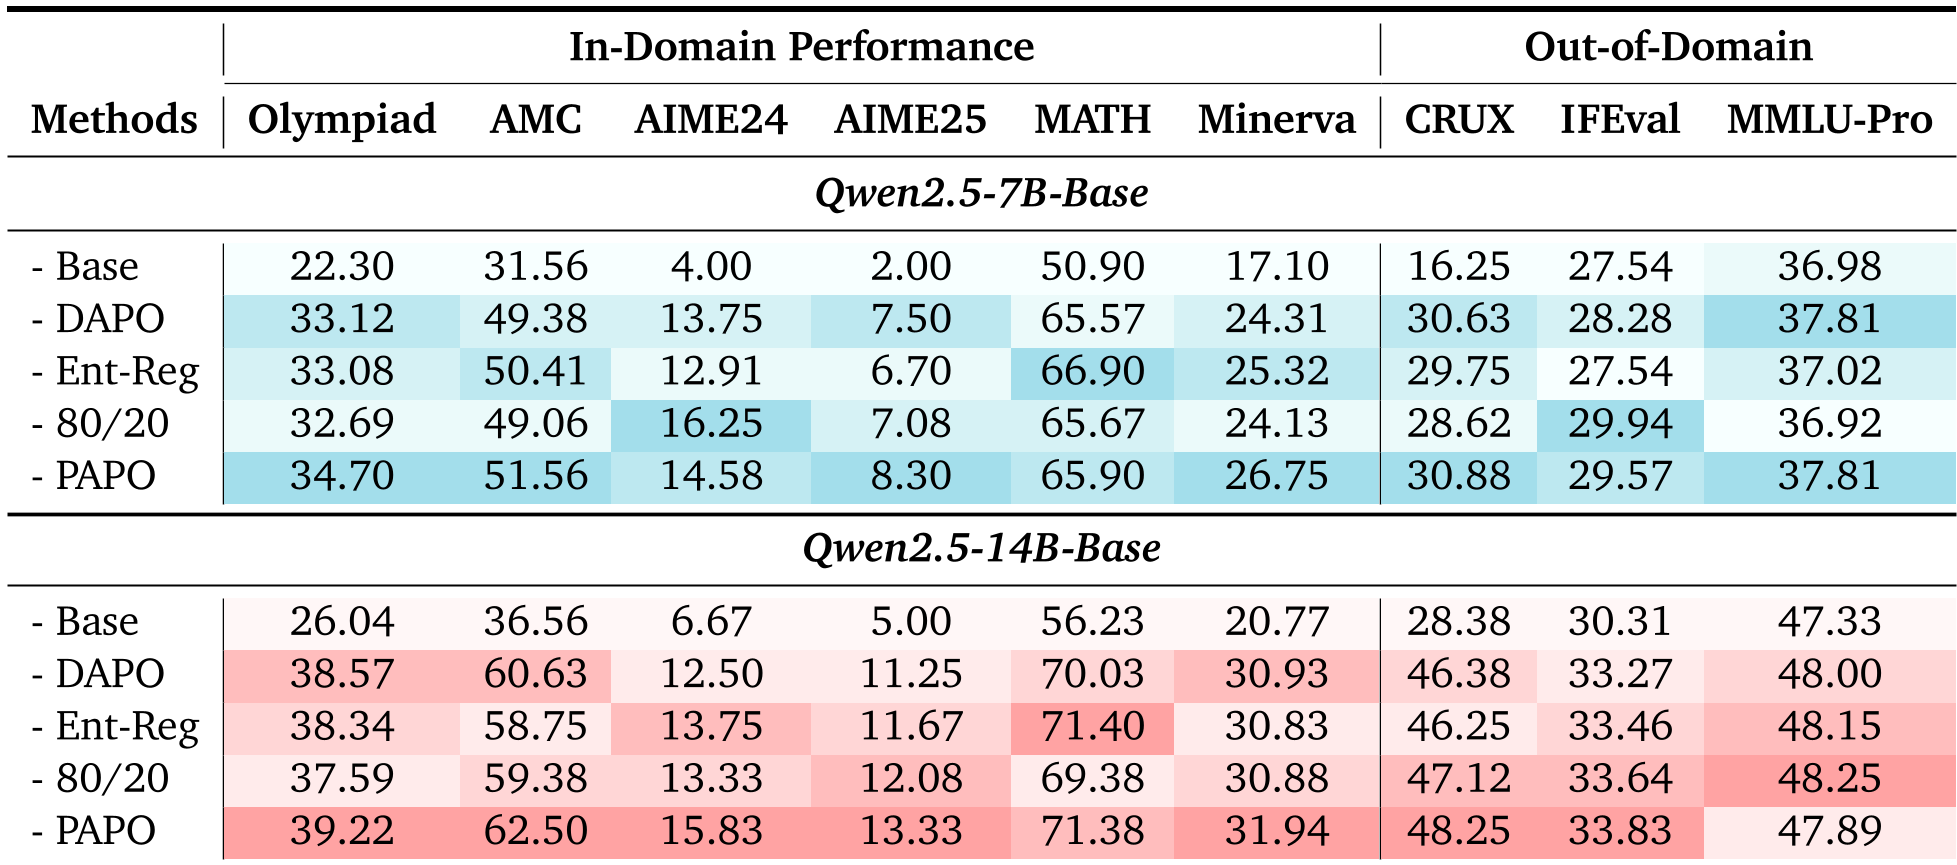
- SOTA 性能:在 Qwen2.5-14B 上,相比 baseline DAPO,性能在多个榜单提升了 2%~3% 以上。
- 两倍加速:Papo 仅用一半的计算资源(Training Budget)就达到了传统方法满产出的性能水平。
- 跨领域通用性:虽然是在数学数据上训练,但 Papo 训练出的模型在代码(CRUX)和工具调用(BFCL)上也表现出更强的泛化能力。
深度洞察:为什么有效?
词云分析(Word Clouds)揭示了一个有趣的物理直觉:
- 正极性更新 (Expansion):主要涉及连接词、结构化词汇(如 "and", "first", "step"),这些 Token 保持了思维的开放性。
- 负极性更新 (Contraction):主要涉及具体的推理片段和答案导向的词汇(如 "find", "product", "final"),这些词汇负责将思维收束到正确答案。
Papo 的成功在于它不再均一化地对待所有 Token,而是有选择地保护了那些“关键的转折点”。
总结与局限
Papo 为 RLVR 引入了微观的控制工具。尽管目前主要在 7B/14B 模型及数学/Agent 场景下验证,但其理论框架具有普适性。未来的挑战在于如何在更长程(Long-horizon)的推理和更大规模的模型中,进一步自动挖掘这类极性信号。
Takeaway:在 RL 训练中,关注“更新的方向”比关注“更新的大小”更具生产力。