
《Error Correction Code Transformer:把 Transformer 真正带入纠错码解码,首次系统超越 neural BP》
Error Correction Code Transformer
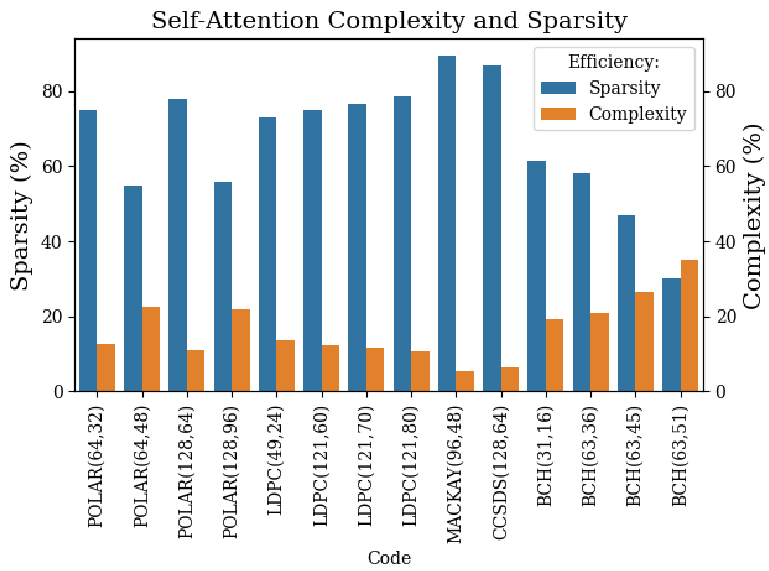
本文研究的是线性纠错码的 soft decoding 任务,提出了首个面向任意 block length 线性码的 Transformer 解码器 Error Correction Code Transformer。其核心是 Positional Reliability Encoding 与 code-aware masked self-attention 的结合,在 Polar、LDPC、BCH 等多类码上显著超越当时的 neural BP 系列 SOTA。该方法不仅提升误码率表现,还将自注意力计算复杂度从稠密 O(n²d) 降到与校验矩阵密度相关的稀疏形式。
核心速览
TL;DR
这篇论文提出了一个用于线性纠错码 soft decoding 的 Transformer 架构,是较早、也非常完整地把 Transformer 引入 error correction decoding 的工作。
它的核心不只是“把编码器换成 Transformer”,而是做了两件非常通信感知的设计:一是把接收符号的 reliability 直接写进 embedding 尺度,二是用 parity check matrix 构造 masked self-attention,把 code structure 显式注入网络。
结果是,这个模型在 Polar、LDPC、BCH 多类码上显著超过 BP、Hyper-BP、AR-BP 和早期 RNN/GRU model-free decoder,并且复杂度反而比标准 self-attention 更低。
从学术定位上看,这不是简单刷榜,而是一次很有代表性的架构迁移:它证明了 neural decoding 不必继续被 BP-unrolling 这条路线锁死。
背景定位
这项工作处在一个很关键的位置:
- 不是最早的 neural decoder;
- 也不是对 BP decoder 的小修小补;
- 而是第一次较为成功地提出一个 de-novo 的 Transformer decoder,并在多个 code family 上真正压过 neural BP 系方法。
更重要的是,它回答了一个长期存在但很少被明确表达的问题:
神经网络要想在纠错码上成功,不只是需要更强的函数拟合能力,更需要一种能同时表达“符号可靠度”和“校验约束关系”的归纳结构。
痛点与动机
1. 传统 BP 系列方法的问题:强,但太“像 BP”
在本文之前,最强的 neural decoder 基本都围绕 Belief Propagation (BP) 展开,例如:
- Neural BP
- Hyper-BP
- AR-BP
这类方法的优点很明确:
- 利用 Tanner graph,结构天然合理;
- 满足 code symmetry 后,可以只训练 zero codeword;
- 不需要真正面对整个指数级 codeword space。
但它的核心问题也同样明确:
- Inductive Bias 太强:
你在本质上仍然是在 BP 的消息传递框架里“学参数”,而不是重新学习解码本身。 - 结构上受限于 Tanner graph:
信息传播路径、更新规则、层间交替方式都继承自 BP,模型自由度有限。 - 表达能力上更像“可学习 BP”,而不是“真正新的 decoder”。
这篇论文最有价值的一点,是作者明确提出:
如果我们一直在 BP 图上做微调,那么神经网络的表达优势永远释放不出来。
2. model-free 方法的问题:灵活,但学不会 code
另一类工作尝试抛开 BP,直接用 MLP、RNN 或 autoencoder 风格网络做解码。问题在于:
- 输入空间随 k 指数增长;
- 更长 block length 时几乎不可训练;
- 网络必须同时学会:
- 哪些位置不可靠;
- 哪些 bit 在 parity relation 上相关;
- 如何融合局部与全局校验信息。
这对普通 MLP/RNN 来说太难了。
论文点得很准:这些模型不是没有容量,而是 缺少合适的结构接口来表达“码的代数约束”。
3. 作者的研究直觉:Transformer 的强项恰好对上了解码需求
Transformer 天然擅长:
- 表达元素间复杂交互;
- 建模长程依赖;
- 对变长输入更友好;
- 通过 attention 实现内容依赖的动态信息聚合。
这与纠错码解码的需求几乎一一对应:
- 每个接收 bit 的可靠度不同;
- 比特之间的依赖并非局部欧氏邻域,而是由 parity equation 决定;
- 一个错误 bit 往往只有在结合多个 parity relation 后才可判定。
于是作者的问题变成:
如何把“可靠度”和“校验图”写进 Transformer,而不是直接拿一个 NLP Transformer 硬套?
这就引出了全文最关键的两项设计。
方法论详解
1. 总体框架:先做 codeword-invariant preprocessing,再用结构化 Transformer 解码
论文沿用 Bennatan 等人的 syndrome-based preprocessing,以保证对发送 codeword 的不变性,并避免 model-free 训练直接遭遇 overfitting。
输入不直接是 y,而是:
- 幅值信息
|y| - syndrome 信息
s(y)=H y_b
拼接得到: [ ilde y = h(y) = [|y|, s(y)] ]
最终预测不是直接输出 codeword,而是预测 multiplicative noise,再与原始 y 结合恢复输出。
这个设计的意义在于:
- 通过 preprocessing 保持 codeword-invariance;
- 把“观测可靠度”和“校验矛盾”分离成两种不同但互补的信号;
- 让后续 Transformer 面对的是更适合学习的表示。
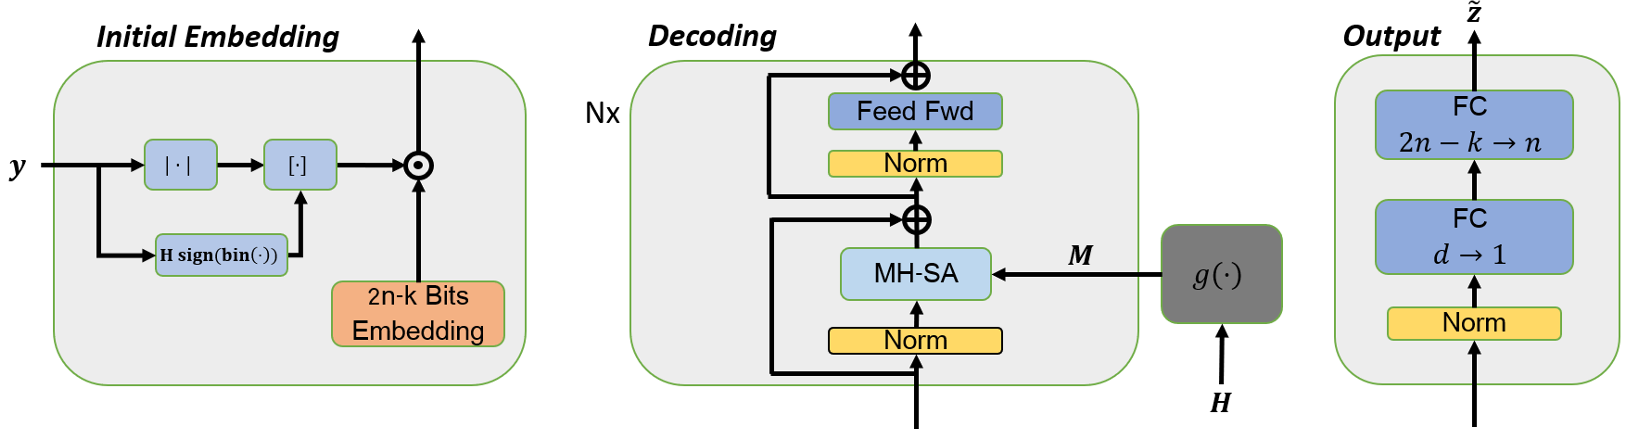
上图是论文给出的整体架构图。与标准 Transformer 相比,它真正不同的地方不是层堆叠,而是:
- 初始 scaled bit-wise embedding;
- 基于 H 的 code-aware masking;
- 面向 noise prediction 的输出头。
2. Positional Reliability Encoding:把“可靠度”编码进 embedding 的长度
这是本文最有意思的设计之一。
作者不是像 NLP 那样给 token 一个普通 embedding,而是对 2n-k 个输入元素分别构造高维向量:
- 前 n 个对应
|y_i| - 后 n-k 个对应 syndrome bit
形式上: [ \phi_i = \begin{cases} |y_i| W_i, & i \le n \ (1-2s(y)_{i-n+1})W_i, & ext{otherwise} \end{cases} ]
这里的关键不是公式本身,而是它背后的几何含义:
W_i表示位置身份;|y_i|作为缩放因子表示该 bit 的可靠程度;- 如果某 bit 幅值很小,embedding 会接近原点;
- syndrome 为 1 时,会引入符号翻转,改变 attention 中的相互作用方向。
这相当于把“这个位置是谁”和“这个位置有多可信”合并到了同一个向量里。
在 self-attention 的点积里,不可靠 bit 的贡献会自动变弱,因为它本身向量范数就小。
这比传统做法更强的地方在于:
- 不是让网络在深层里自己“学会谁更可靠”;
- 而是从第一层起就把 reliability 暴露给注意力机制;
- attention score 的几何结构直接携带通信意义。
这是一种非常漂亮的设计:
把概率可靠度变成向量几何。
3. Code-aware Self-Attention:不是所有 bit 都该互相看
标准 Transformer 做全连接 attention,即每个 token 与所有 token 交互。
但在纠错码中,这并不合理。比特之间真正相关的关系不是“全局任意”,而是由 parity check matrix H 决定。
所以作者构造了一个基于 H 的 mask: [ A_H(Q,K,V) = ext{Softmax}\left(\frac{QK^T + g(H)}{\sqrt d}\right)V ]
其中 g(H) 取值为 {0, -∞},用于屏蔽无关位置。
mask 的构造原则是:
- 每个 syndrome bit 只和对应 parity equation 中出现的比特交互;
- 同一 parity equation 中共同出现的比特彼此可见;
- 保留自身连接。
这件事非常关键,因为它改变了 Transformer 的 inductive bias:
- 标准 attention:假设全局所有 pair 都可能有用;
- 本文的 masked attention:只保留 algebraically meaningful 的 pair。
论文对此有一个很准确的类比:
- 普通 Transformer 类似在 complete graph 上做神经网络;
- 本文方法相当于在 Tanner graph 扩展出的 “two-rings connectivity” 上做 attention。
这与 BP 的本质区别是:
- BP 是固定消息流;
- 本文是结构约束下的内容自适应聚合。
所以它既保留了图先验,又不被 BP 公式绑死。
如果你后续能补充论文 Figure 2 的原图 URL,这里最适合插入 code-aware mask 与 Tanner graph 关系的图。当前输入未给出 Figure 2 的明确图片地址,因此先保留占位。
4. 为什么这个 mask 不只是“加速”,而是真正提高精度?
一个常见误解是:mask 只是为了稀疏化计算。
但在这篇论文里,mask 的核心作用首先是 学习约束,其次才是 复杂度降低。
原因很简单:
- 如果不加 mask,模型必须自己从数据中发现哪些 bit 有 parity relation;
- 这相当于让网络同时学“码结构”和“解码规则”;
- 对有限样本和中小网络来说,这非常难。
mask 相当于告诉网络:
- 不必从零学习谁和谁相关;
- 只需在已知相关图上学“如何聚合”。
作者的 Ablation Study 也直接支持这点:
- BCH(63,36) 上 loss 降低 76%
- POLAR(64,32) 上降低 69%
- LDPC(49,24) 上降低 66%
这说明 mask 不是锦上添花,而是成功训练的核心条件。
5. 输出头与训练目标
论文没有直接预测 codeword,而是预测 multiplicative noise。
损失采用 cross-entropy,对每个 bit 的 noise indicator 进行监督。
这样做的好处是:
- 与 preprocessing/post-processing 保持一致;
- 保留对 transmitted codeword 的不变性;
- 网络学习的是“哪些位置被噪声翻转”,而不是记忆具体码字。
从建模角度看,这比直接做 bit classification 更自然,因为真正需要纠正的是 channel-induced perturbation,而不是原始信号本身。
实验与结果
1. 覆盖面:不是只在单一代码上奏效
论文实验覆盖三大类线性码:
- LDPC
- Polar
- BCH
并与以下方法比较:
- BP
- Hyper-BP
- AR-BP
- syndrome-based RNN/GRU
这是本文说服力强的原因之一:
它不是在某个“特别适合 Transformer”的任务上选点突破,而是在多种 code family 上都成立。
2. SOTA 对比:浅层模型就能压过更深的 BP 系方法
论文表 1 用 -ln(BER) 汇报结果,数值越高越好。
很多地方最值得注意的不是绝对值,而是:
- 作者的 N=2 或 N=6 的浅层模型就已经超过 BP / Hyper-BP / AR-BP;
- 说明收益不来自“堆更多层”,而来自表示方式本身更对。
例如在 Polar(64,32) 上:
- AR-BP 在 6 dB 为 7.02
- Ours N=2 为 8.19
- Ours N=6 为 9.82
因为这是 -ln(BER),差 1 个单位对应 BER 约乘上 e^{-1}。
所以从 7.02 到 8.19 已经是相当可观的误码率下降;
从 7.02 到 9.82 则几乎是数量级层面的差距。
在 BCH(63,51) 上也能看到一致优势:
- AR-BP 在 6 dB 为 8.16
- Ours N=2 为 9.18
- Ours N=10 为 9.03(不同配置下仍整体占优)
论文还指出,在高 SNR 区间,相比收敛 AR-BP 可达到 最高两个数量级 的 BER 优势。
这在通信里非常重要,因为高 SNR 区域的 error floor/尾部表现往往决定工程可用性。
这张图展示了不同 SNR 下的 BER 曲线,包括 Polar(64,32)、BCH(63,51) 以及与 Bennatan 等模型在 BCH(127,64) 上的对比。最值得关注的是右移/下移趋势:在相同 SNR 下,本文方法整体 BER 更低;在相同 BER 目标下,所需 SNR 更小。
3. 与 syndrome-based RNN 的比较:不是小改进,而是结构代差
作者特别比较了 Bennatan 等人在 BCH(127,64) 上的 GRU 模型。对方模型:
- 五层 stacked GRU
- 五次迭代
- embedding 维度很大
- 训练 5000 epochs
- batch size 1000
而本文方法:
- 层数减半左右;
- 参数量约十分之一;
- 训练要求更低;
- 仍获得最高 211% ratio 的性能优势。
这说明本文不是单靠“更大模型”赢,而是赢在结构更匹配问题本身。
4. LDPC 上的观察:为什么优势相对没那么夸张?
论文提到一个很重要的现象:
- 对 LDPC,方法也很强;
- 但相较于 Polar/BCH,优势没那么“夸张”。
这是合理的。因为 LDPC 本来就是为 BP decoding 高度优化设计的。
也就是说,BP 在 LDPC 上已经有非常强的先天匹配性。
在这种任务上,一个 de-novo Transformer 仍能显著竞争甚至超越,本身就已经很说明问题。
5. Ablation Study:mask 的贡献是决定性的
论文给出了 masking 的消融实验。结论非常直接:
- 不加 mask,让 Transformer 自己学 code structure,训练明显更困难;
- 加了基于 H 的 mask,收敛更快、loss 更低。
定量上:
- BCH(63,36): loss 降低 76%
- POLAR(64,32): loss 降低 69%
- LDPC(49,24): loss 降低 66%
这基本可以视为论文最核心的实验证据之一。
它证明本文的成功不是“Transformer 本身万能”,而是 Transformer + 正确的结构先验 才有效。
这张图直观地显示,masking 不是 marginal gain,而是显著改变训练动力学的关键模块。
6. Reliability embedding 的可解释性分析
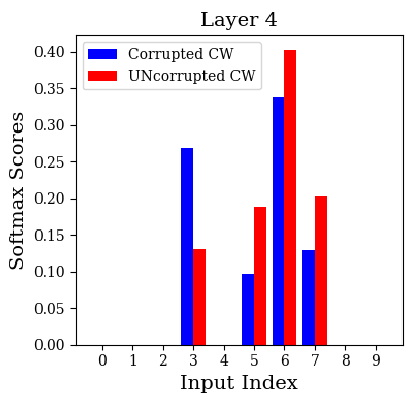
作者还分析了 scaled embedding 如何影响 self-attention。
在 Hamming(7,4) 的例子里,当第一位被噪声污染时:
- 该 bit 的 embedding 因可靠度降低而接近原点;
- 它对 attention aggregation 的直接影响减弱;
- 但相关 syndrome 位置的影响增强;
- 当网络逐层修正该错误后,attention 分布又回到正常状态。
这说明本文设计不是黑盒 trick,而是有清晰的机制解释:
- embedding norm 反映可靠度;
- mask 控制信息流向;
- attention 负责在相关约束子图内重分配证据。
深度洞察与总结
1. 这篇论文真正的贡献,不只是“用了 Transformer”
很多跨领域论文都会犯一个问题:
只是把最新架构直接套到旧问题上。
但这篇并不是。
它真正做对了三件事:
- 保留问题不变性:通过 syndrome-based preprocessing 避免 codeword overfitting;
- 显式表示可靠度:通过 scaled embedding 把 channel reliability 几何化;
- 显式表示代数结构:通过 H-induced mask 把 parity relation 图结构化。
所以它不是“Transformer for decoding”,而是:
一个被通信理论重新塑形后的 Transformer。
2. 为什么它比 neural BP 更值得关注?
neural BP 的问题在于,它更像“传统方法的可学习补丁”。
本文则展示了另一条路线:
- 不再继承 BP 的消息更新形式;
- 只保留最必要的 algebraic prior;
- 用更一般的 attention 学习信息融合。
这意味着未来 neural decoder 的研究重点,可能从:
- “如何更聪明地 unroll BP”
转向:
- “如何设计更适合 code structure 的通用神经算子”。
这是路线级别的变化。
3. 局限性
这篇论文虽然很强,但也有明显限制:
- 主要验证对象仍是中等 block length 的代数码
对超长码、大规模工业级码的泛化与吞吐表现仍需验证。 - 仍依赖显式 parity check matrix H
对非标准码、时变码、隐式约束码的适配尚不明确。 - 复杂度虽比稠密 attention 低,但仍不是极致高效
与高度优化的经典硬件 BP decoder 相比,部署优势还需要更系统的 latency / energy 评估。 - 训练成本依旧不低
尽管优于许多竞争方法,但 1000+ epochs 的训练设置说明它更像研究型系统,而非直接工业即插即用方案。
4. 未来展望
这条路线后续很值得继续推进,可能的方向包括:
- 更大尺度稀疏 Transformer decoder
- 针对长码设计 block-sparse / hierarchical attention
- 进一步降低 latency 与 memory
- 联合码设计与解码器设计
- 不只固定 H 再学 decoder
- 而是共同优化 code structure 与 Transformer mask
- 跨通信任务迁移
- MIMO detection
- channel estimation
- sequence detection
- joint source-channel coding
- 面向硬件的轻量化
- pruning
- quantization
- low-rank attention
- FPGA / ASIC-friendly sparse kernels
5. 最终 Takeaway
如果只用一句话概括这篇论文,我会这样说:
它证明了 neural decoding 的下一步,不一定是把 BP 做得更深,而可能是把码的代数结构翻译成 attention 的结构偏置。
这是本文最大的学术价值。
它给出的不是一个孤立模型,而是一种方法论:
当问题本身有严格组合结构时,最有效的 Transformer 往往不是通用 Transformer,而是带着结构先验的 Transformer。