
SDE:戳破通用 AI 的“全才”幻觉,大语言模型离真正的科研超智能还有多远?
Evaluating Large Language Models in Scientific Discovery
本文推出了 SDE (Scientific Discovery Evaluation) 框架,这是首个全面评估大语言模型(LLMs)在生物、化学、材料和物理四大领域科研发现能力的基准。该研究涵盖了从 43 个研究场景抽取的 1,125 个专家级问题以及 8 个闭环科研项目,揭示了当前顶级模型(如 gpt-5, deepseek-R1)在真实科研逻辑中相较于 SOTA 基准的性能差距。
TL;DR
如果把 LLM 比作一个学生,它可能在各科期末考试中拿了 A,但当把它扔进实验室面对一个全新的研发难题时,它可能连起码的假设都提不出来。由 Deep Principle 联合康奈尔、斯坦福等顶尖学府发布的 SDE (Scientific Discovery Evaluation) 评测框架显示:现有的顶级模型(gpt-5, deepseek-R1 等)在处理场景化的科学发现任务时,尽管推理能力有显著进步,但依旧无法在所有科研项目中胜任。
背景:知识不等于发现
目前的 AI 评测界陷入了一个误区:堆砌大量的研究生水平 Q&A。然而,正如论文所指出的:“能通过课程考试不代表能成为伟大的科学家”。
现有的基准测试如 GPQA 高度“去语境化”,模型只需要关联知识点即可满分。但真实的科研是迭代的——你需要针对一个失败的模拟结果调整参数,需要从杂乱的 NMR 谱图中推理分子结构。为了填补这一空白,SDE 框架应运而生。
核心机制:情景驱动 (Scenario-grounded) 与 闭环发现
SDE 将评估分为两个维度:
- 模块化科研场景:包含 43 个细分场景(如 PXRD 晶体系统确定、CRISPR 输送策略等),确保问题与实际研发流程挂钩。
- 项目级闭环 (The Loop):这是论文最精彩的部分。它让模型担任“首席科学家”,通过进化算法进行假设提案,调用第三方模拟器(如 RDKit, VASP)获取反馈,并自主完成 8 个核心项目的优化。
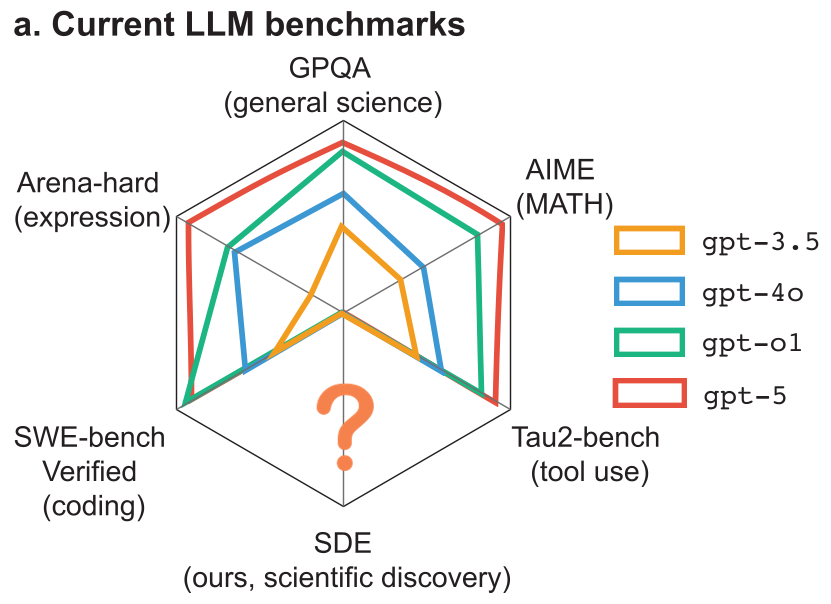 SDE 框架流程:从模块化场景问答到闭环项目评估
深度洞察:科研里的 LLM 众生相
1. 推理能力的“双刃剑”
通过对 DeepSeek-R1(推理强化版)与 V3.1(非推理基座版)的对比,作者观察到了明显的推理红利。在物理、化学等严谨逻辑场景中,推理能力让准确率跃升。然而,这种提升在项目级优化中却出现了“高原反应”——随着推理步数的增加,模型可能在长程规划中因一个微小的 SMILES 语法错误而导致整个合成路径失败。
2. 惊人的“共犯现象”
研究发现,来自不同厂商的顶级 LLM 在面对高难度科研难题时(SDE-hard),倾向于犯完全相同的错误。这意味着目前所有主流模型可能受困于相似的预训练数据集分布,单纯的架构改进已进入瓶颈。
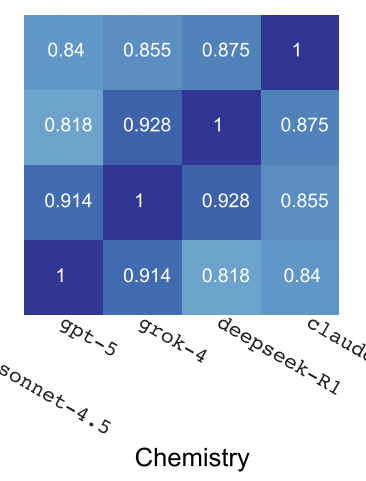 图示:即使是 gpt-5 与 deepseek-R1,在某些特定的 MOF 合成问题上也高度共现了错误,预示了底层数据同源的隐患。
3. 科研中的“意外之喜” (Serendipity)
有趣的是,在过渡金属配合物(TMC)优化项目中,即便模型在预测氧化态这类基础问答中分数不高,但在寻找具有高极化率的新分子时却极其高效。这说明 LLM 具有一种某种程度上的**“群体统计直觉”**,即使细节报错,大方向却往往是对的。
实验战绩与 SOTA 对标
- 生物学准确率:顶级模型最高可达 0.71,但相较于 MMMU-Pro 的 0.84+,科研语境下的性能损耗明显。
- 符号回归 (Symbolic Regression):deepseek-R1 和 gpt-5 展现了卓越的收敛速度,能在大规模 OOD(分布外)数据中精准捕捉物理公式,远超传统方法 PySR。
- 物化挑战:在伊辛模型 (Ising model) 的能量极小化搜索中,除了 deepseek-R1,多数模型竟然败给了传统的模拟退火算法。
局限性与未来展望
尽管 LLM 已经显露头角,但研究强调它们离真正的“科学超级智能”还有一段距离。主要短板在于:
- 合规性检查:经常产生非法的化学 SMILES 符号。
- 工具耦合不足:模型推理与专业仿真工具(如 LAMMPS)的集成还不够丝滑。
- 长程规划:在多步逆合成路径规划中容易“断片”。
总结 (Takeaway)
科学发现不仅是关于“知道什么”,更是关于“如何探索未知”。SDE 的出现为这一领域设定了新的“北极星”,提醒开发者:未来的 AI 科学家,不应只是一个博学多才的考试机器,而应是一个能够忍受失败并从数据反馈中不断学习的、具备韧性的探索者。