
SDE 框架:学术“超级智能”尚远,LLM 距离真正的科学家还有多长?
Evaluating Large Language Models in Scientific Discovery
本文推出了 SDE (Scientific Discovery Evaluation) 框架,这是一款专门评估大语言模型 (LLMs) 在生物、化学、材料和物理四大领域科研发现能力的基准。该框架通过 1,125 个专家审核的科研问题及 8 个端到端科研项目,全面评估了包括 GPT-5、DeepSeek-R1 等在内的顶级模型。
TL;DR
如果说传统的科学问答是考查学生的“刷题能力”,那么 SDE 框架则是直接把大模型拉进了实验室。这项由 Deep Principle 联合斯坦福、MIT 等多所顶尖学府推出的研究发现:即便是目前最强的 GPT-5 或 DeepSeek-R1,在真实科研场景下依然存在明显的性能鸿沟。科研不仅仅是寻找标准答案,更是关于在不完全信息下进行假设、验证与纠错的闭环能力。
背景定位:从“刷题家”走向“研究员”
目前的 AI 评估正处于范式转换期。代码领域有 SWE-bench,数学有 AIME,但在科学发现领域,我们长期依赖 GPQA 这种去语境化的单轮问答。
本文作者认为,学术能力的评价应当具备场景感(Scenario-grounded)。一个能背诵元素周期表的模型不一定能推断出复杂的过渡金属配合物(TMC)极化率。因此,SDE 试图建立一套从“原子级问题”到“全流程项目”的评价体系。
方法论详解:SDE 的双重透镜
1. 微观层面:43 个科研场景
作者将科学研究拆解为 43 个模块化的 Scenario。例如,在化学领域,不仅考概念,更考实操中的推理,如从光谱图推断分子结构(Structure Elucidation)。
2. 宏观层面:sde-harness 科研闭环
这是本论文最具前瞻性的部分。它模拟了科学发现的经典循环:
- Initialization:生成初始假设。
- Mutation/Crossover:利用 LLM 的知识进行改进。
- Selection:通过计算模拟器(Oracle)反馈评分。
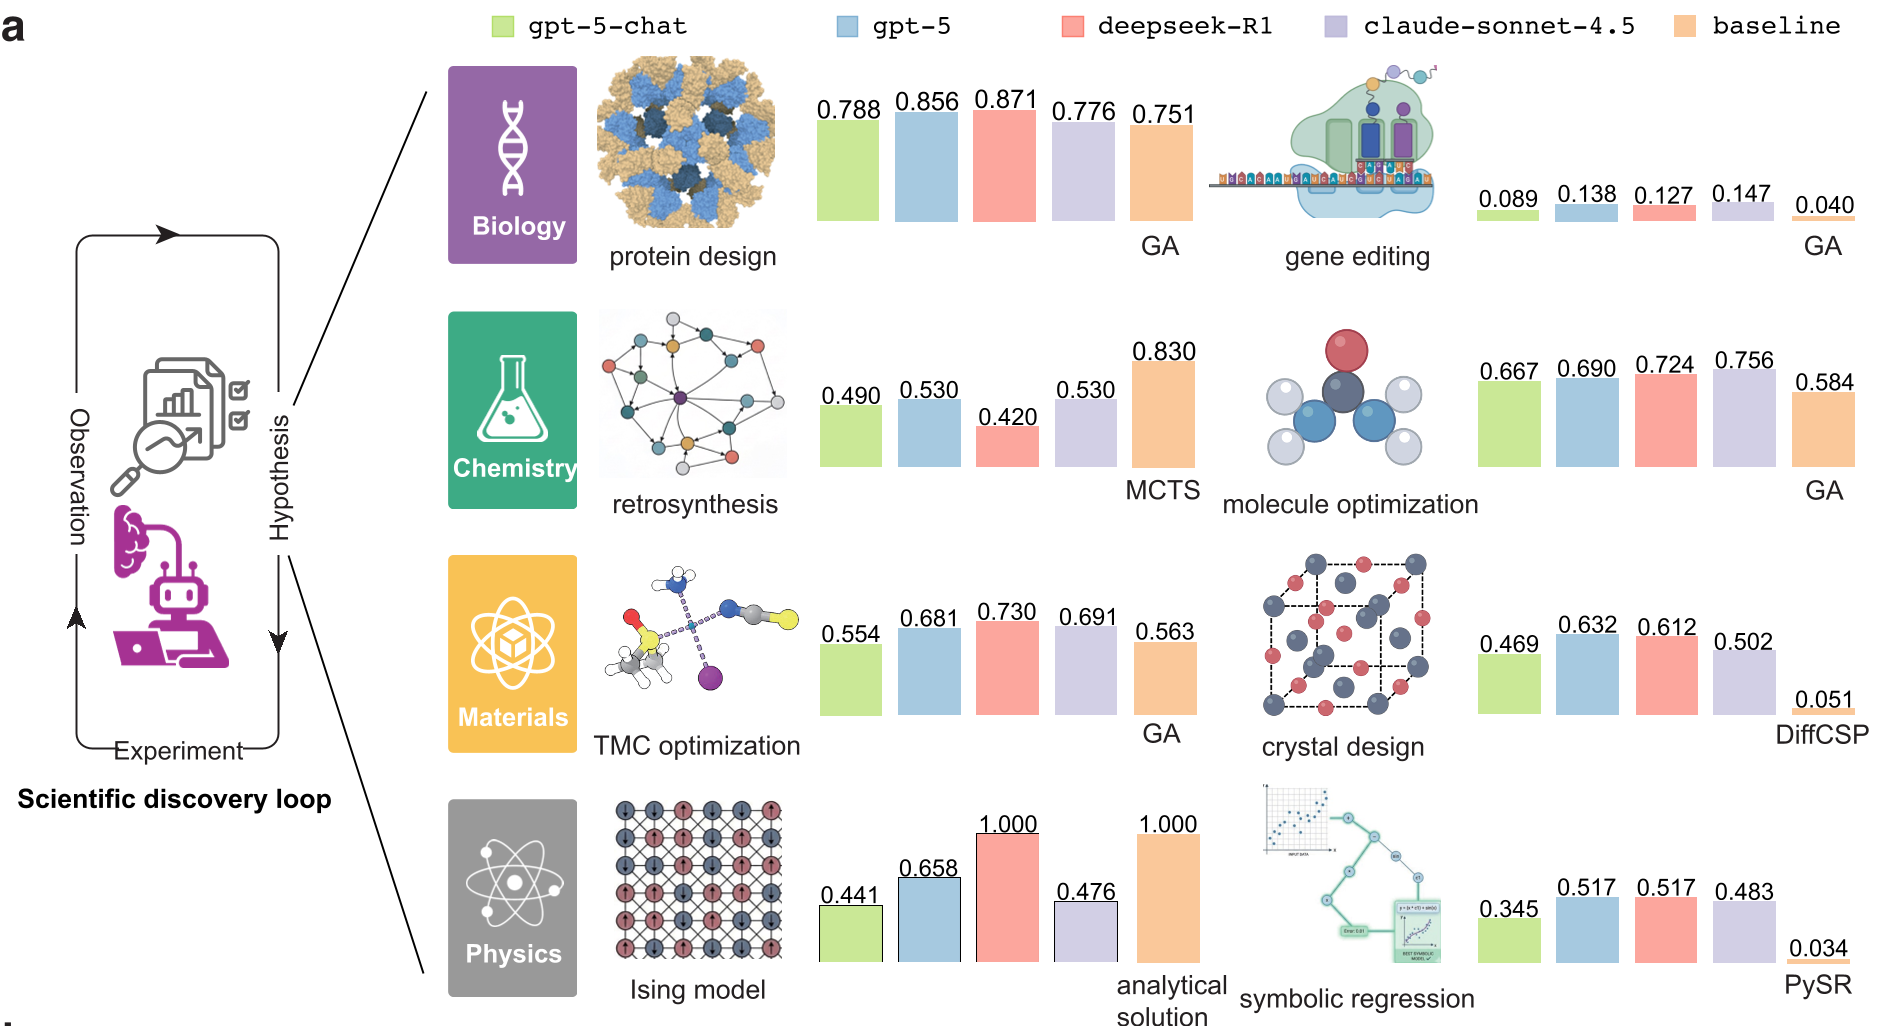 图 1:sde-harness 模拟的科研闭环优化流程
核心发现:推理与规模的“天花板”?
推理能力的红利分布不均
研究对比了 DeepSeek-V3.1 与带思维链调优的 DeepSeek-R1。结果显示,**显式推理(Test-time Reasoning)**在生物医药预测(Lipinski 规则)、物理符号回归等方面带来了质的飞跃(准确率从 0.6 提升至 1.0 附近)。这证明了 CoT(思维链)能够帮助模型解析复杂的逻辑约束。
规模效应的边际递减
令人惊讶的是,随着 GPT-5 或 o3 等模型从 Mini 升级到 Pro,在某些科学场景下的准确率并没有显著提升。这暗示:单纯增加模型体量或推理算力,可能无法自动解决那些缺乏高质量科研语料的“硬科技”痛点。
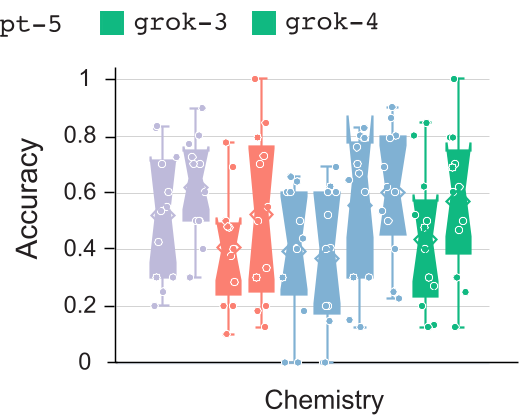 图 2:不同领域下 LLM 的准确率分布情况,可见其表现存在极大的不平衡性
深度洞察:科研中的“偶然性”与“局限性”
1. 给力的偶然性 (Serendipity)
在过渡金属配合物(TMC)的优化项目中,即便模型在“氧化态预测”这种微观测试中得分很低,它们依然能在迭代优化中找到极化率极高的分子。这说明 LLM 具备某种“全局优化直觉”,能够捕捉到某种模糊的梯度,即使它们无法精确描述背后的物理公式。
2. 致命的合规性 (Validity)
但在反合成(Retrosynthesis)路径设计任务中,新一代模型反而输给了 GPT-4o。原因极具讽刺性:推理能力更强的模型虽然步数更久,但却容易在生成 SMILES 分子表达式时出现语法错误。长程规划中的“一步错步步错”是科研 AI 的噩梦。
结论与展望:走向科学“超级智能”
SDE 基准的出现为行业指明了三条路:
- 领域数据才是王道:通用的互联网文本已经无法满足深层科研推理的需求。
- 深度的工具耦合:模型必须学会如何熟练地调用计算化学、计算物理工具并进行“调试”。
- 针对科研逻辑的 RL:既然针对数学和代码的强化学习有效,那么针对“科学范式”的强化学习将是下一个前沿。
目前的 LLM 仍然是优秀的“科研助手”,但距离能够独立开辟新领域的“科研领袖”还有一段漫长的路要走。