
破译 RAG 评估黑盒:从 Auepora 框架看检索增强生成的统一评价之道
Evaluation of Retrieval-Augmented Generation: A Survey
本文提出了名为 Auepora 的统一 RAG 评估流程框架,对检索增强生成(RAG)系统的评估挑战、基准测试(Benchmarks)及指标进行了全面审视。它将评估分为检索、生成和整体系统三个维度,并系统化总结了从 RAGAs 到 DomainRAG 等 12 个主流评估框架。
TL;DR
随着大语言模型(LLM)的爆发,**检索增强生成(RAG)**已成为解决模型幻觉、引入即时知识的事实标准。然而,如何客观衡量一个 RAG 系统的好坏?本文深度解析了最新的综述论文,介绍了 Auepora (A Unified Evaluation Process of RAG) 框架,它不仅解构了检索与生成双引擎的评估逻辑,更揭示了未来评估从“硬性指标”向“语义对齐”演进的趋势。
背景定位:从工具堆砌到系统度量
RAG 不再是简单的“检索+拼提示词”。它是一个包含索引(Indexing)、搜索(Searching)、重排序(Reranking)、提示词工程(Prompting)和推理(Inference)的复杂流水线。本文认为,RAG 的评估正处于从验证“是否有用”到量化“边界在哪”的跨越期。
痛点深挖:为什么 RAG 评估这么难?
- 评价目标的漂移:检索阶段好(Recall 高)并不代表生成的答案就对。
- 数据的实效性陷阱:传统的 SQuAD 或 Natural Questions 等静态数据集已通过训练进入 LLM 的权重,无法测试模型处理“昨晚发生的新闻”的能力。
- 黑盒挑战:LLM 代替了传统的分类器,其输出具有不可预测的随机性,传统的 BLEU/ROUGE 指标因无法识别语义等价性而逐渐失效。
Methodology:Auepora 统一评估框架
为了破解上述困局,作者提出了 Auepora 框架,核心分为三个模块:
1. 评价目标 (What to Evaluate)
评估被拆解为两个核心链路的交互:
- 检索端 (Retrieval):关注相关性 (Relevance) 和准确性 (Accuracy)。
- 生成端 (Generation):关注忠实度 (Faithfulness)(是否基于检索文档)和回答相关性 (Answer Relevance)。
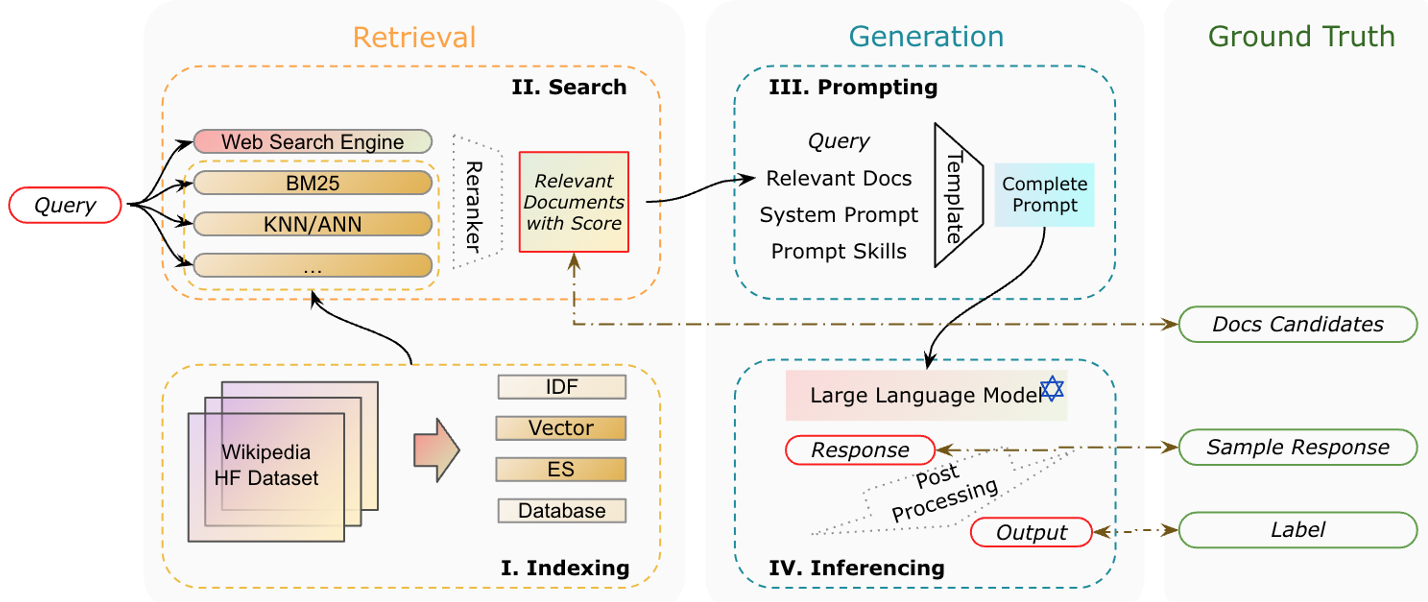 上图展示了 RAG 系统从 Query 到最终 Response 的流转过程,评估贯穿于每一个中间节点。
2. 构建数据集 (How to Evaluate)
为了模拟真实环境,最新的基准测试(如 RGB, MultiHop-RAG)倾向于:
- 生成式构建:利用 GPT-4 等高级模型,基于最新的新闻或企业内部文档生成问答对。
- 对抗性设计:故意引入“噪声文档”或“虚假事实”,测试系统的识别能力。
3. 量化指标 (How to Measure)
除了 MAP, MRR 等传统排名指标,LLM as a Judge 成了核心角色。
- 自评审评分:利用 Prompt 指定评分量表(1-5分),让 LLM 评估回答的流畅度和逻辑性。
- 语义对齐:使用 BERTScore 代替字面匹配,识别“语义相同但表述不同”的优质回答。
实验对比:SOTA 基准测试大赏
下表收录了当前最前沿的评估工具和基准。我们可以清楚地看到,从 2023 年底开始,评估维度已从简单的“准确率”扩展到了“延迟 (Latency)”、“噪声鲁棒性 (Noise Robustness)”和“负采样识别”。
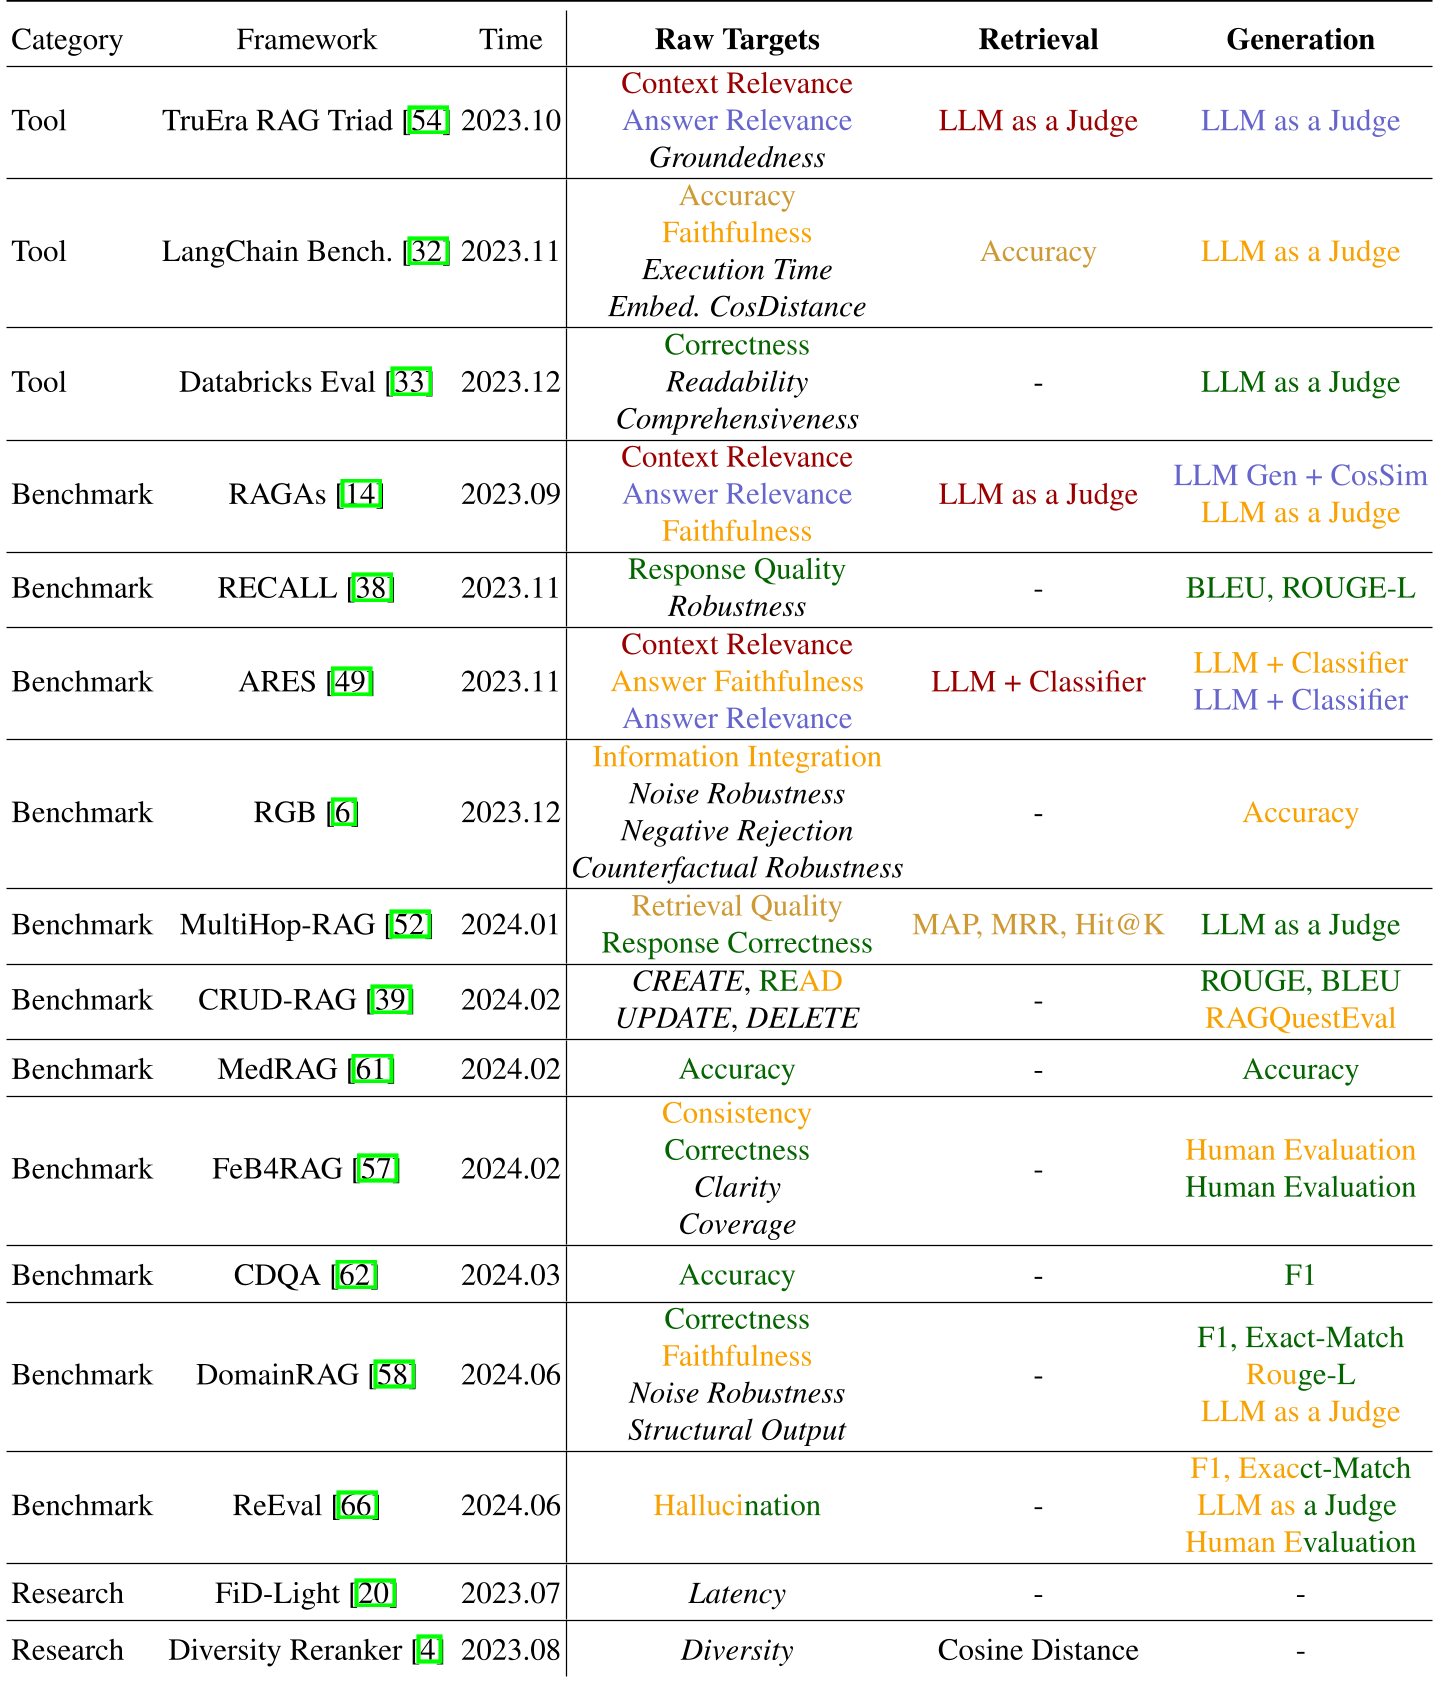 表格对比了 RAGAs, ARES 等主流工具,红色和紫色标注代表了对检索和生成质量的不同侧重。
深度洞察:RAG 评估的“下半场”
本文的 Critical Analysis 指出,未来的 RAG 评估将不仅是“对或错”的判断,而是以下三个维度的平衡:
- 性能平衡:在保持高检索质量的同时,如何压缩长上下文带来的推理延迟(Latency)?
- 鲁棒性边界:当检索到的信息中包含 30% 的误导性噪声时,模型能否保持“清醒”?这是 Counterfactual Robustness 的核心。
- 自动化闭环:利用 PPI(Prediction-Powered Inference)减少对人工标注的依赖,实现 RAG 系统的在线自动化监控。
总结与局限
Auepora 为我们提供了 RAG 评估的北斗导航,但目前 LLM as a Judge 依然存在“模型偏见”问题(例如 LLM 倾向于给长答案打高分)。此外,对于垂直领域(如医疗、法律)的评估,通用的基准测试仍显不足,需要更强的领域专家知识注入。
关键词:RAG, Auepora, LLM as a Judge, 忠实度评估, 鲁棒性测试