
FaithfulRAG:拒绝盲从上下文,以“事实级对齐”破解 RAG 知识冲突
Faithfulrag: Fact-level conflict modeling for context-faithful retrieval-augmented generation
本文提出了 FaithfulRAG,一个旨在解决检索增强生成(RAG)中知识冲突问题的创新框架。该方法通过在“事实层面”(fact-level)显式建模模型参数知识与检索上下文之间的差异,在保持上下文忠实度的同时,显著提升了生成答案的准确性。
TL;DR
在检索增强生成(RAG)的世界里,当外部文档说“地球是方的”,而模型知道“地球是圆的”时,悲剧往往就发生了。传统的解决方案通常是强制模型“闭嘴”,无条件听从文档,但这往往导致模型变笨(误解上下文)。厦门大学等机构提出的 FaithfulRAG 另辟蹊径:它让模型先“反思”自己知道什么,再把自己的知识与外部文档在事实颗粒度上逐一比对,通过一个“自我思考(Self-Think)”的过程来优雅地解决冲突。
背景定位
FaithfulRAG 不是简单的 Prompt 工程,它是在 RAG 的 生成阶段(Generation Stage) 进行深层逻辑修补的 SOTA 级别工作。它精准打击了现有 RAG 系统在面对“知识冲突”时的软肋——即在追求“忠实度(Faithfulness)”时牺牲了“理解力(Comprehension)”。
痛点深挖:忠实度的“杀敌一千,自损八百”
研究者通过实验发现了一个令人沮丧的现象:
- Vanilla RAG:容易因为过度自信(Over-confidence)而忽略上下文。
- SOTA Faithful 方法(如基于解码增强或强约束 Prompt):虽然强制模型听话了,但导致模型在处理复杂逻辑时更容易出现错误匹配(Incorrect-match Error)。
本质原因在于:现有方法通过强制抑制参数知识,破坏了模型内部的知识结构,使其变成了“被动的复读机”,失去了辨别上下文细微差异的能力。
方法论详解:三位一体的冲突调和
FaithfulRAG 的核心架构分为三个环环相扣的阶段:
1. 自我事实挖掘 (Self-Fact Mining)
模型不再直接读文档。相反,它先进行内部查抄:
- 知识提取:梳理出回答该问题所需的领域知识背景。
- 语境生成:将抽象知识转化为具体的叙述。
- 事实提取:将上述内容蒸馏成一系列“原子级”的自生事实(Self-Facts)。
2. 上下文知识对齐 (Contextual Knowledge Alignment)
这是全书的“锚点”。系统将检索到的原始文档切片(Chunking),利用 Embedding 模型将模型自己的“自生事实”与文档切片在共享语义空间中进行相似度匹配。
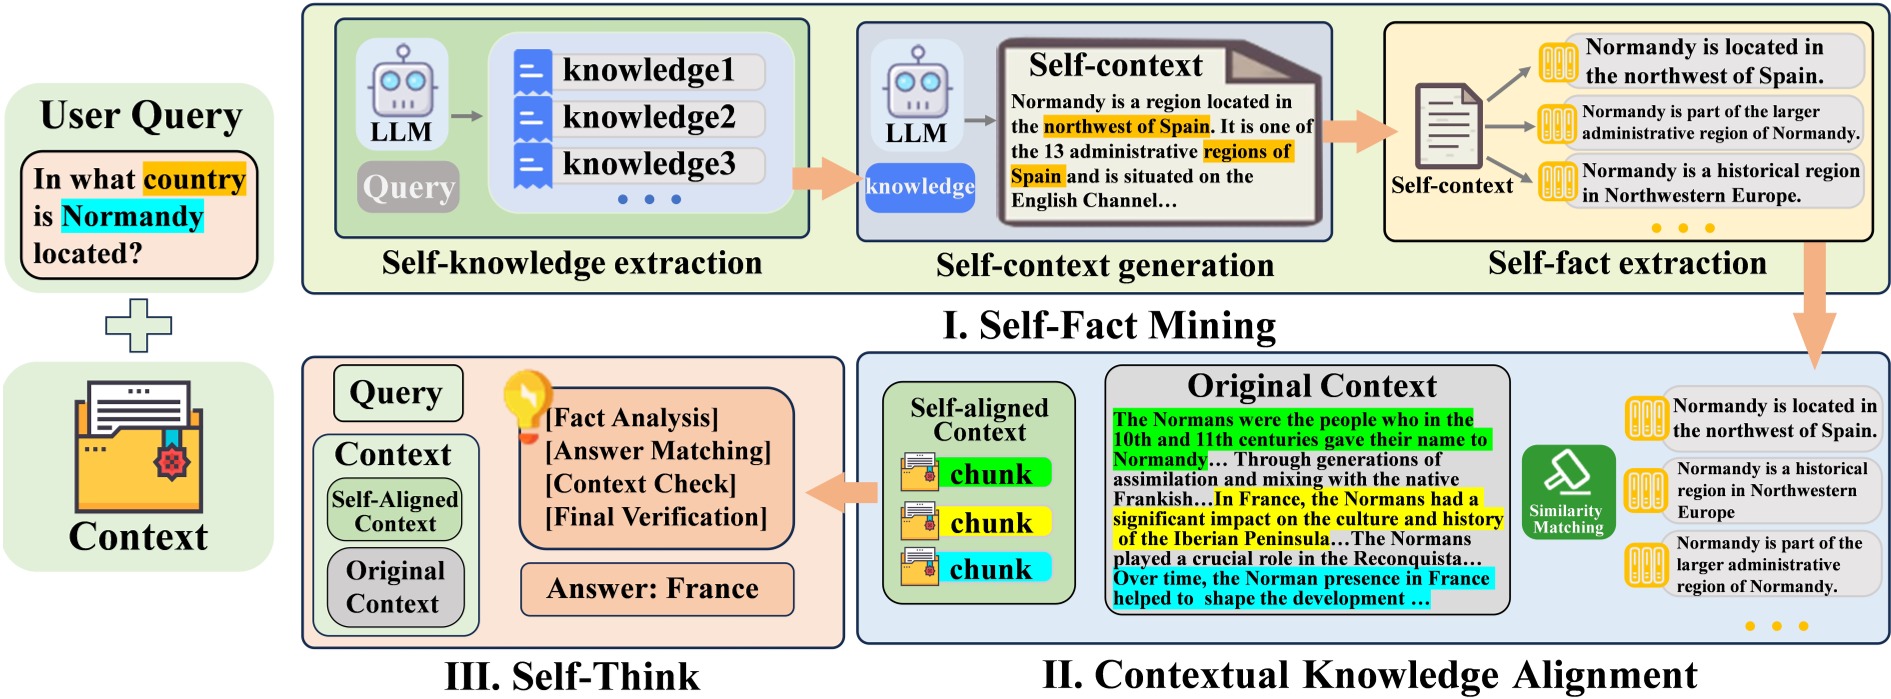 图 1:FaithfulRAG 总体流程,展示了从挖掘自生事实到最终 Self-Think 的全过程
3. 自我思考 (Self-Think) 模块
这是最体现学术见解的部分。模型并不同时处理所有乱七八糟的信息,而是分两步走:
- Thinking:基于对齐后的事实生成初步判断,并评估证据是否充分。
- Reasoning:如果发现冲突或信息不足,则引入原始上下文进行交叉验证,通过结构化推理(如冲突预测步骤)生成最终答案。
实验与结果:全方位碾压
FaithfulRAG 在 FaithEval, RealtimeQA, MuSiQue, SQuAD 四大数据集上刷新了记录:
- 性能飞跃:在 SQuAD 上比 Llama 原始 RAG 提升了近 17% 的准确率。
- 双重修复:如图 5 所示,它是极少数能同时显著降低 Case 1(过度偏执)和 Case 2(盲目从众)错误的方法。
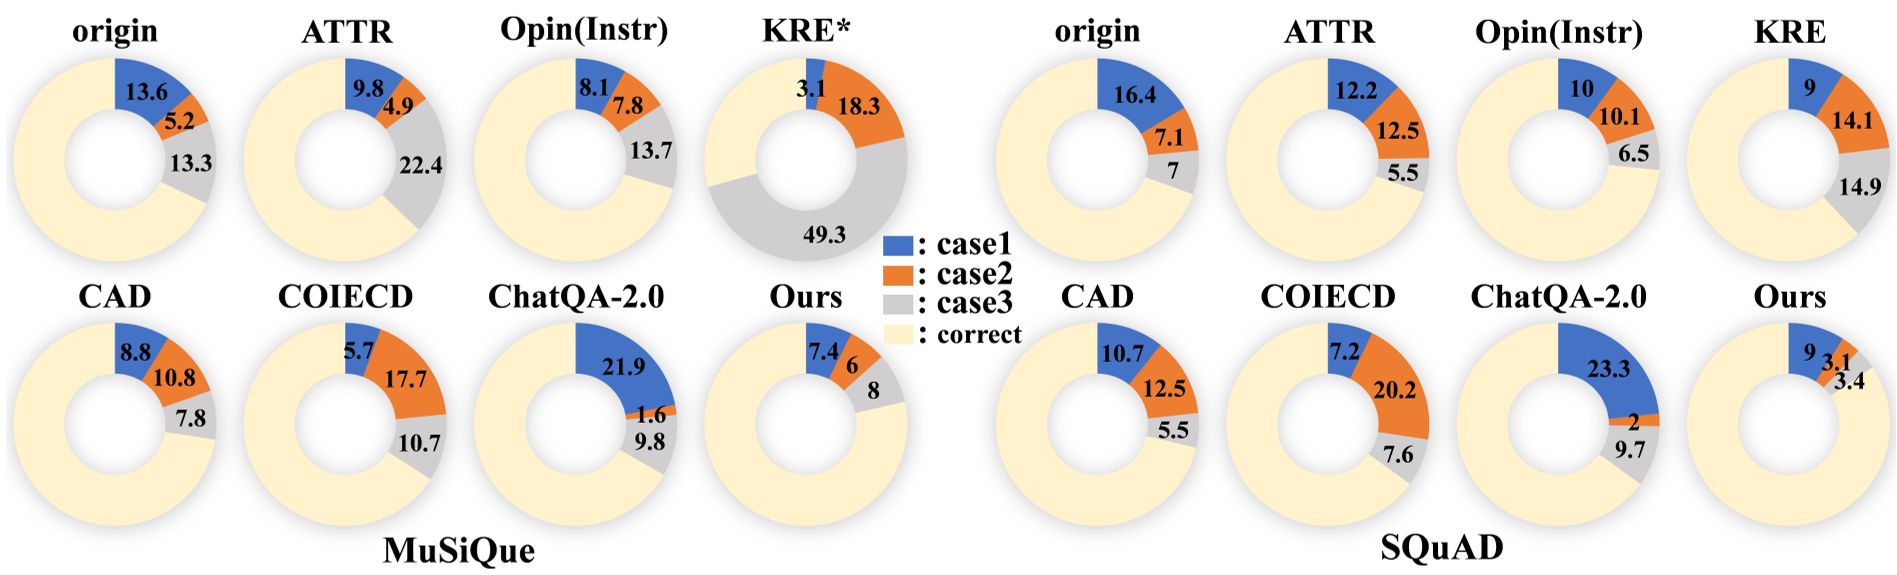 图 2:各类错误分布对比。FaithfulRAG(最右侧)在所有错误类型上均表现出了最低的比例
此外,消融实验显示,如果去掉 Self-Think 模块,准确率会暴跌 22.2%,这证明了“主动推理”在解决知识冲突中的核心地位。
深度洞察与总结
Takeaway:FaithfulRAG 的成功告诉我们,大模型的参数知识不是 RAG 的终结者,而是 RAG 的辅助仪。
局限性:
- 多模态缺失:目前仅支持文本。在现实中,图片里的文字也可能与文档冲突。
- 算力开销:三阶段的事实挖掘增加了推理延迟,如何轻量化是未来的课题。
未来展望:这种“先提取自身认知,再对齐外部证据”的模式,可能会成为下一代 Agent 架构的标准范式,尤其是在法律、医疗等对准确性极其敏感的垂直领域。