
告别 Item ID:TRM 框架重塑排序模型的 Scaling Law
Farewell to Item IDs: Unlocking the Scaling Potential of Large Ranking Models via Semantic Tokens
本文提出了 TRM (Token-based Recommendation Model),一个旨在取代传统 Item ID 的语义 Token 化排序框架。通过引入协同感知的多模态表示、混合 Token 机制(平衡泛化与记忆)以及判别与生成联合优化,TRM 在大型搜索排序任务中实现了 AUC +0.85% 的提升,并减少了 33% 的稀疏存储开销。
TL;DR
在推荐系统和搜索排序领域,Item ID 就像是模型的“身份标签”,但这一标签正成为阻碍模型规模化(Scaling)的桎梏。本文介绍的 TRM (Token-based Recommendation Model) 框架,提出了一套完整的“去 ID 化”方案。它不仅将存储开销降低了 33%,更在字节跳动的大规模搜索场景中显著提升了用户指标。更重要的是,它向我们展示了:语义 Token 比传统 ID 具有更强的 Scaling 潜力。
1. 痛点:为什么 ID 阻碍了模型的 Scaling?
当前的排序模型(如 DCN-v2, RankMixer)虽然在稠密参数上不断加深加宽,但其底层逻辑仍依赖于庞大的 ID Embedding 表。
- 知识孤岛:每个 ID 是独立的,新老 ID 之间无法共享特征,这导致模型在处理冷启动和长尾内容时表现拙劣。
- 分布不稳:随着流量和内容的快速迭代,ID 空间极度不稳定。研究发现,随着模型参数增大,ID 嵌入的范数方差(Norm Variance)剧烈波动,这会破坏稠密网络(Tower)的梯度学习效率。
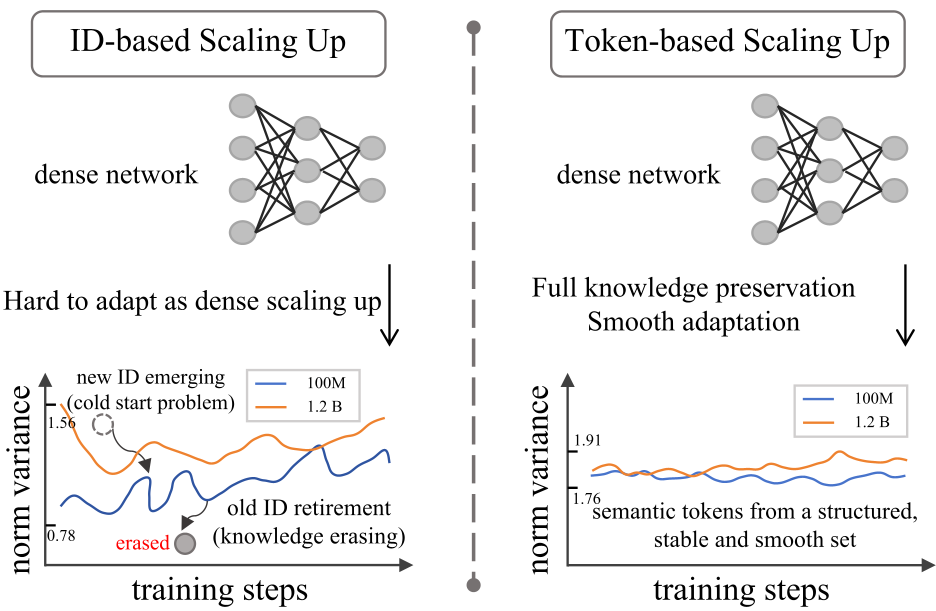 图 1:语义 Token 在模型规模增加时展现出比 Item ID 更好的分布稳定性
2. 核心技术:TRM 的“三板斧”
为了彻底解决语义 Token 的局限性(如记忆力不足),TRM 提出了三项核心改进方案:
2.1 协同感知的多模态表示
单纯基于内容语义(如标题、视觉分析)的 Token 往往忽略了用户的行为意图。TRM 采用两阶段训练:
- 多模态对齐:使用 MLLM 生成视频描述,注入领域语义。
- 行为对齐:通过对比学习,将 Query-Item 和 Item-Item 的点击协同信号注入 Embedding,确保生成的 Token 既懂“内容”又懂“人”。
2.2 混合 Token 化 (Hybrid Tokenization):平衡博弈
普通的语义 Token(基于 RQ-Kmeans)虽然泛化性好,但容易丢失“细粒度特征”,导致模型“记不住”高效的老视频。
- Gen-tokens (泛化):保留粗粒度的语义结构。
- Mem-tokens (记忆):使用 BPE (Byte Pair Encoding) 算法提取高频的 Token 组合,赋予模型对特定特征组合的深度记忆能力。
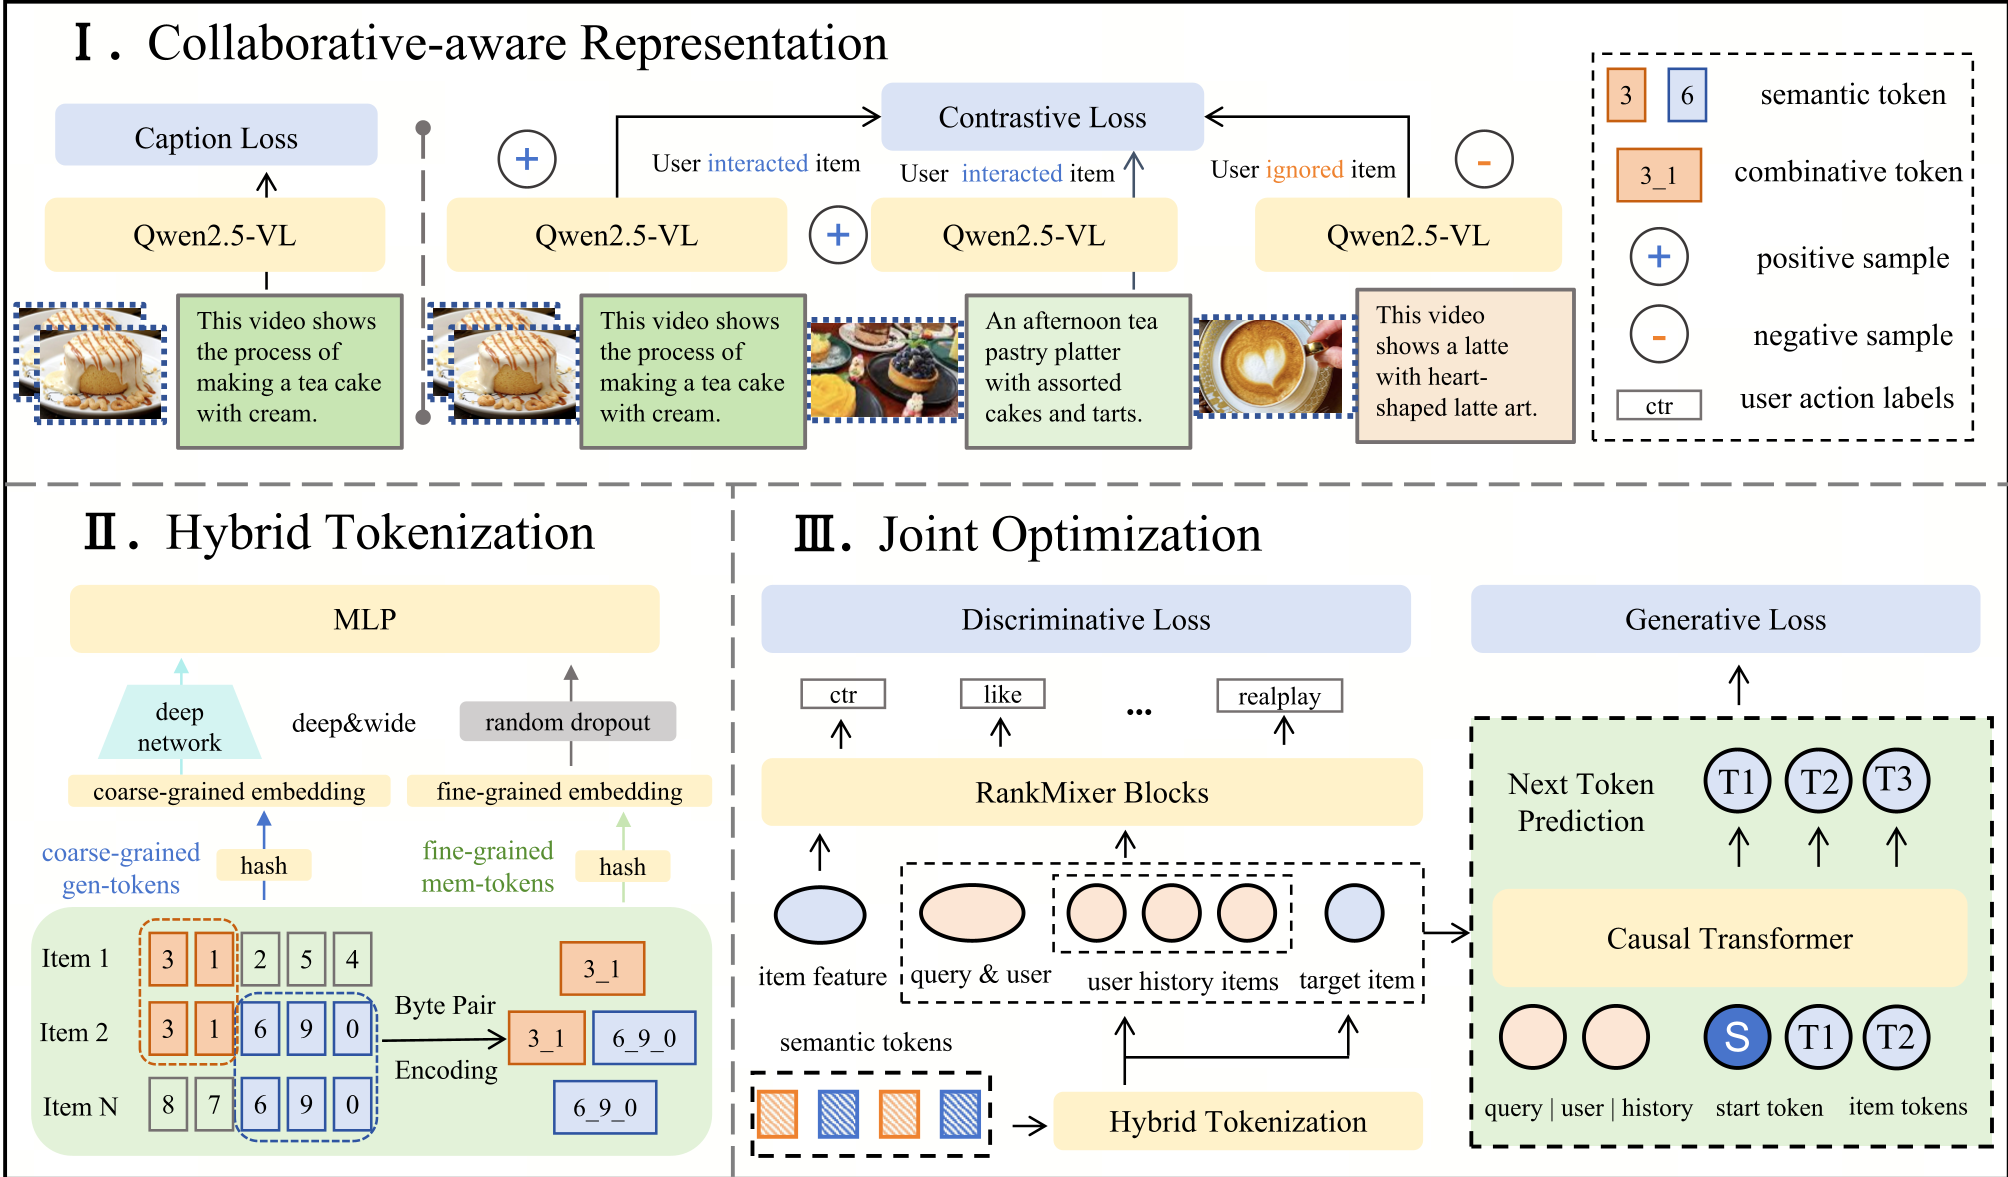 图 2:TRM 整体框架,包含多模态对齐、混合 Token 化及联合训练流
2.3 生成式辅助任务
TRM 不仅仅做分类预测(CTR),还引入了 NTP (Next Token Prediction)。通过预测下一个语义 Token,模型被逼迫去学习 Token 序列背后的层级结构信息,这大大增强了长尾内容的表征鲁棒性。
3. 实验结果:Scaling Law 的胜利
TRM 在字节跳动真实数据上的测试结果令人振奋:
- 更陡峭的 Scaling 曲线:如图 4 所示,随着稠密参数(Dense Params)增加,TRM 的精度提升斜率显著高于传统的 ID 模型。
- 存储效率:稀疏存储空间大幅压缩 33%,为部署超大规模模型腾出了空间。
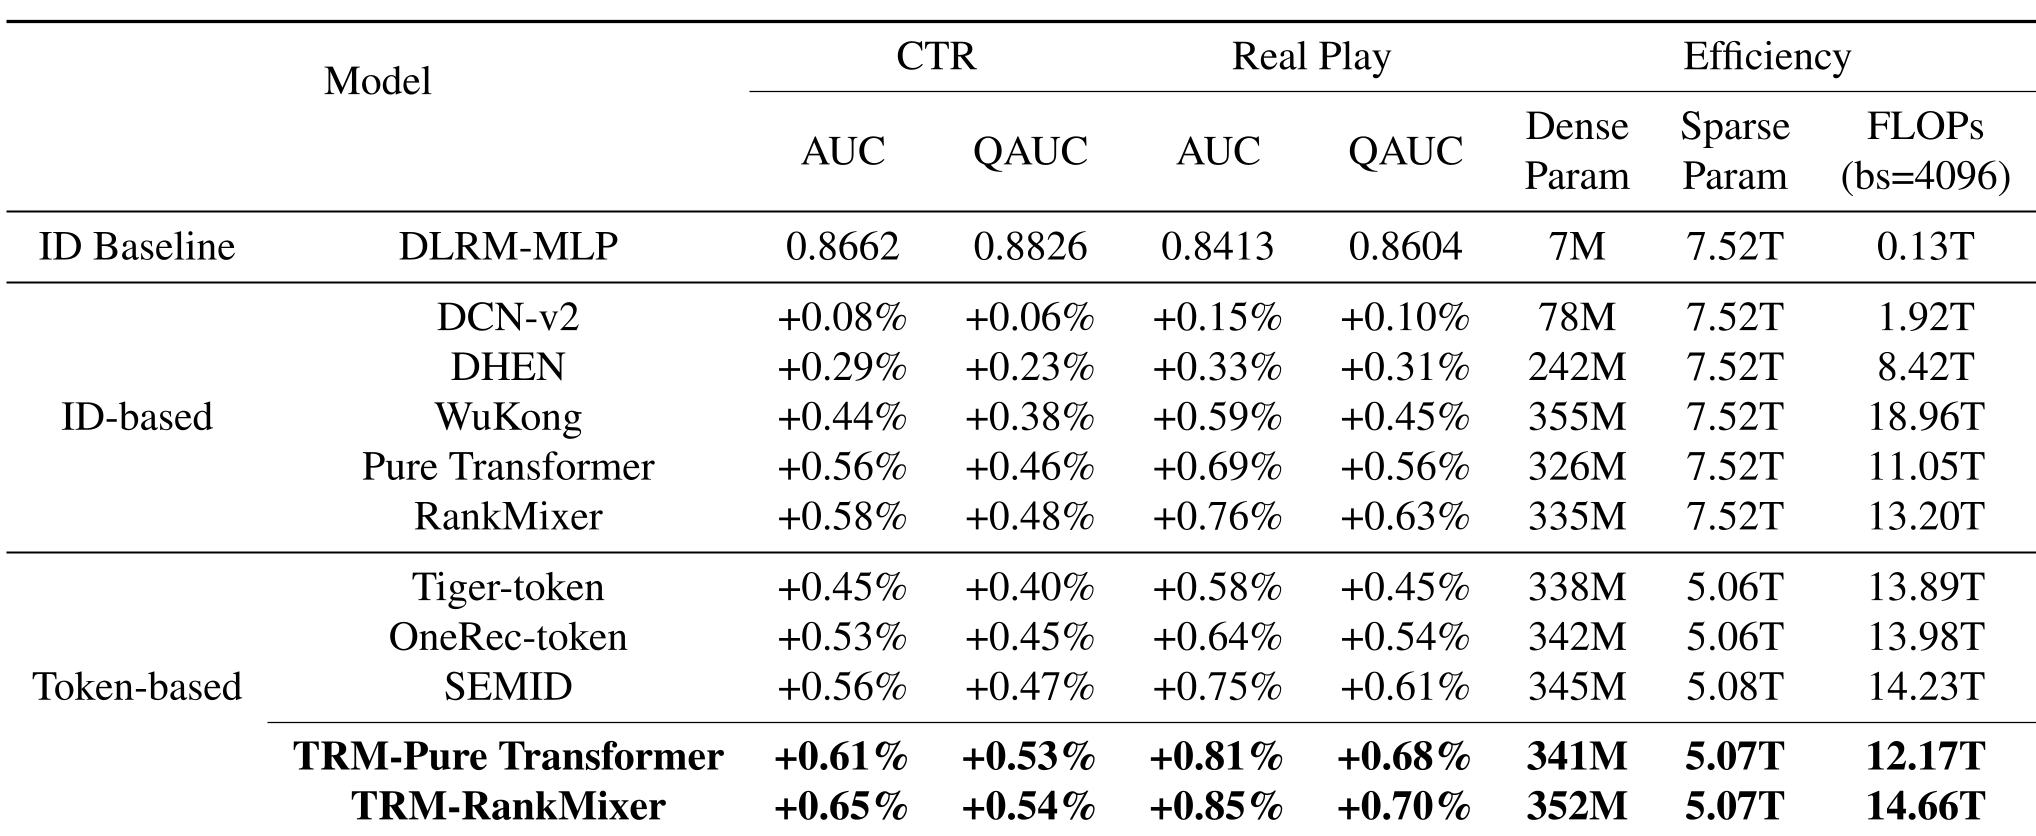 表 1:TRM 与行业 SOTA ID 模型及 Token 模型的性能与效率对比
4. 深度洞察
TRM 的成功揭示了一个深刻的学术直觉:模型的 Scaling 能力不仅取决于“参数量”,更取决于“输入空间(Representation Space)的平滑度”。
Item ID 本质上是一个离散、噪声大、无结构的集合,其有效维度 极高,导致 Scaling Law 的指数 较低。而语义 Token 通过量化(Quantization)将 Item 投影到一个低维、平滑且具备结构化的流形(Manifold)上,从而显著提升了神经网络的逼近效率。
总结
TRM 的工作证明了,通过引入语义 Token 代替符号 ID,我们不仅能解决冷启动问题,更能在 Scaling 竞赛中获得更大的领先优势。未来的大规模排序系统,或许将彻底摆脱对 ID Embedding 表的依赖,步入全 Token 化的新时代。