
FD-LLM:让大模型听懂机器的“脉搏”,突破复杂设备诊断的特征叠影难题
FD-LLM: Large language model for fault diagnosis of complex equipment
本文提出了 FD-LLM,一种专门用于复杂设备故障诊断的多模态大语言模型。通过将工程时间序列数据与文本模态对齐,并引入模糊语义嵌入(Fuzzy Semantic Embedding),FD-LLM 在航空发动机等数据集上实现了 SOTA 性能,准确率达到 94.38%。
TL;DR
传统的工业故障诊断模型往往深陷于“模式混淆”的泥潭,而哈尔滨工业大学的研究团队通过 FD-LLM 给出了一套新方案。他们不仅让 LLM 学会了阅读传感器波形,更引入了模糊语义嵌入 (Fuzzy Semantic Embedding) 机制,利用 LLM 强大的逻辑推理能力来辅助判断那些连资深专家都难以区分的特征重叠样本。
1. 行业痛点:工业数据的“脸盲症”
在航空发动机或大型液压设备中,传感器回传的是高频、多维的时间序列信号。传统深度学习模型(如 CNN, LSTM)面临两个死穴:
- 模式叠影 (Pattern Aliasing):不同故障在特征空间里的表现可能极其相似,数据点紧挨在一起,导致传统分类器在决策边界处频繁“翻车”。
- 孤岛效应:每个场景都要从头练模型,缺乏对工业领域常识的通用理解能力。
2. 核心架构:FD-LLM 它是如何工作的?
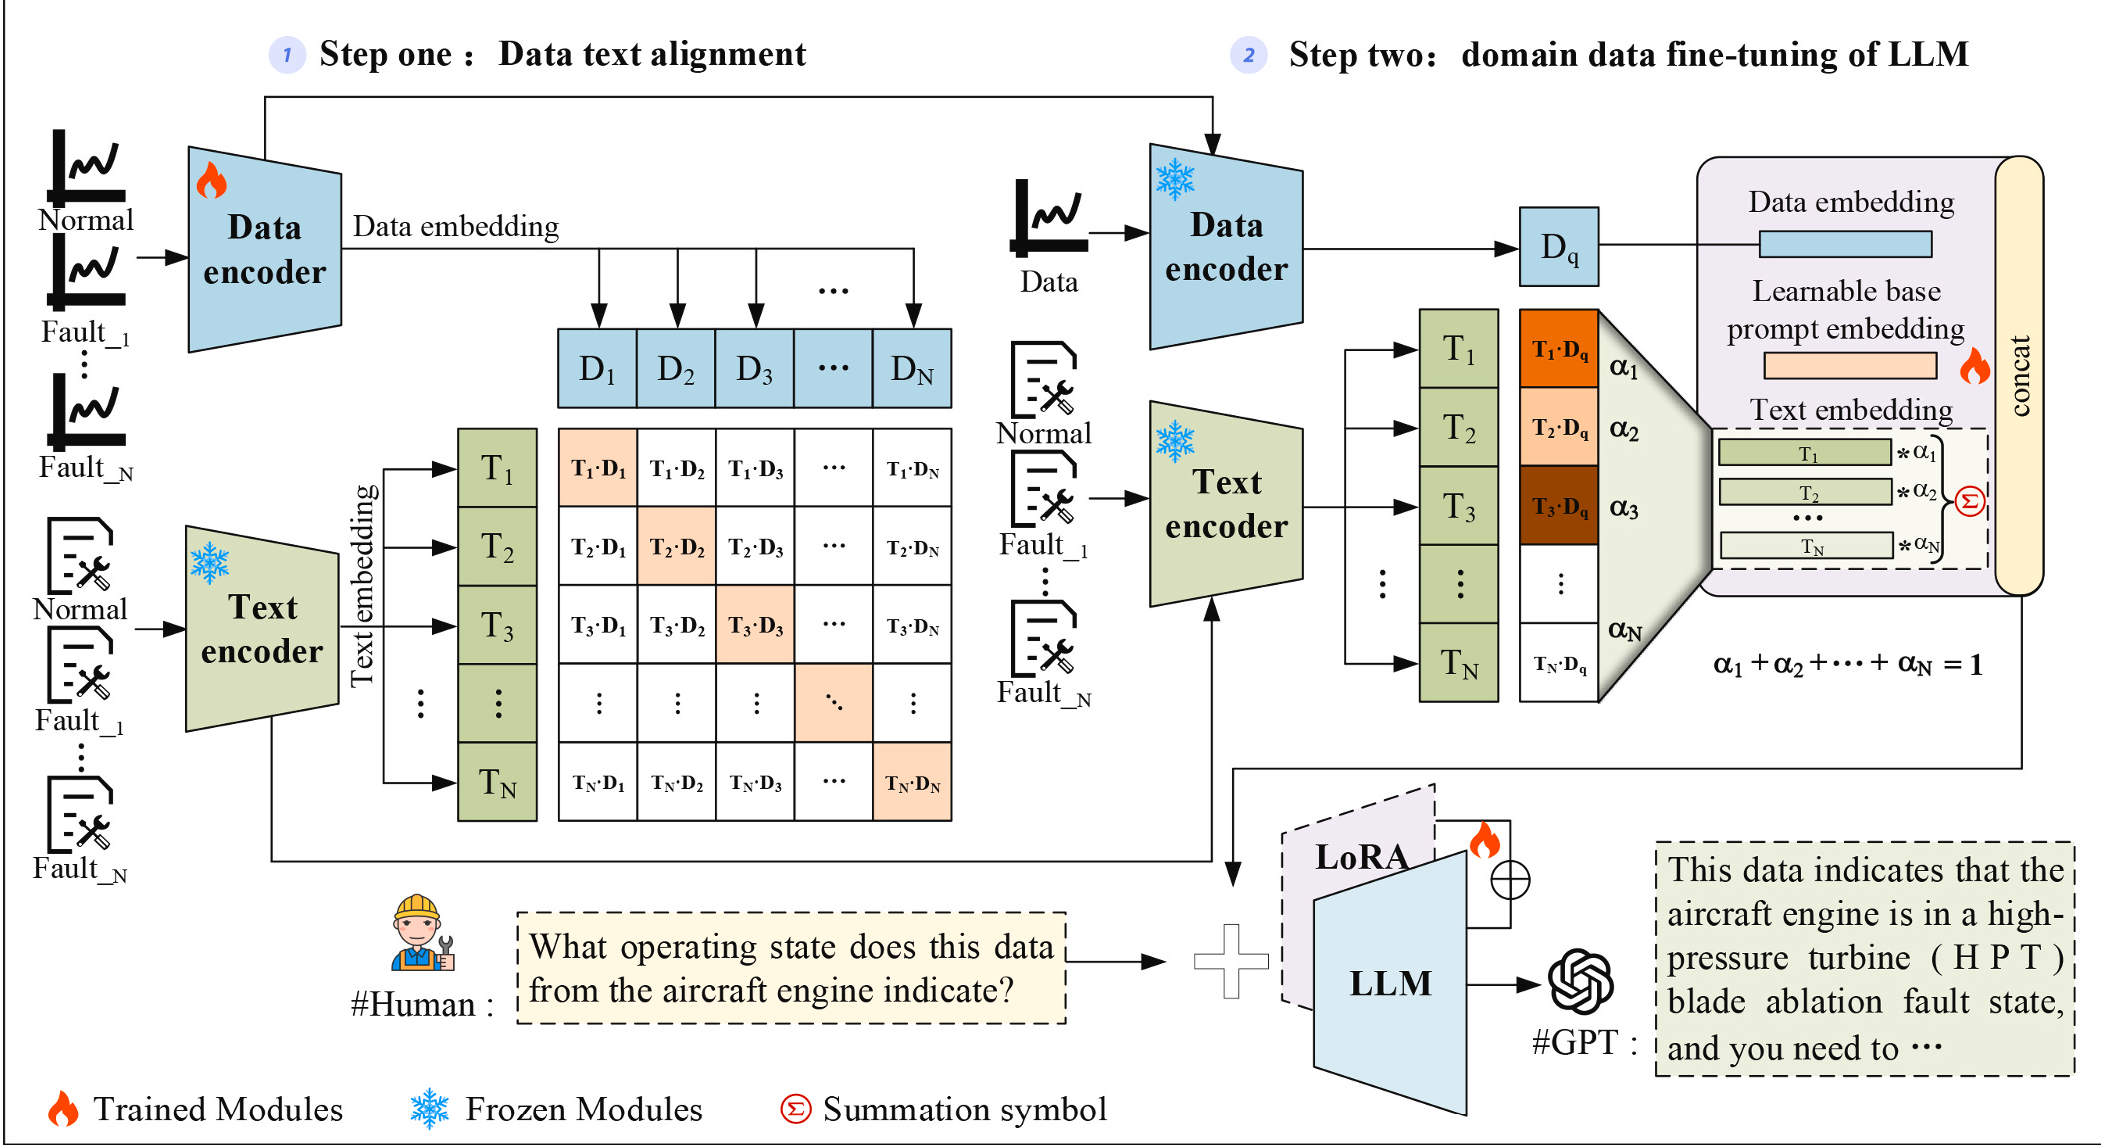
FD-LLM 的架构设计非常精妙,它并没有试图重造轮子,而是巧妙地通过“模态转换器”将 LLM 接入了工业现场。
2.1 模态对齐 (Modal Alignment)
作者使用 LSTM 作为数据编码器(Data Encoder),负责将原始信号转化为向量。关键点在于,他们冻住了一个大模型的 Text Encoder,强迫 LSTM 把传感器信号映射到与文本描述相同的向量空间里。
- 直觉解释:这就像是给哑巴(传感器数据)请了个翻译官,把电信号翻译成了 LLM 能听懂的“语义密电”。
2.2 模糊语义嵌入 (FSE):解决“似是而非”的艺术
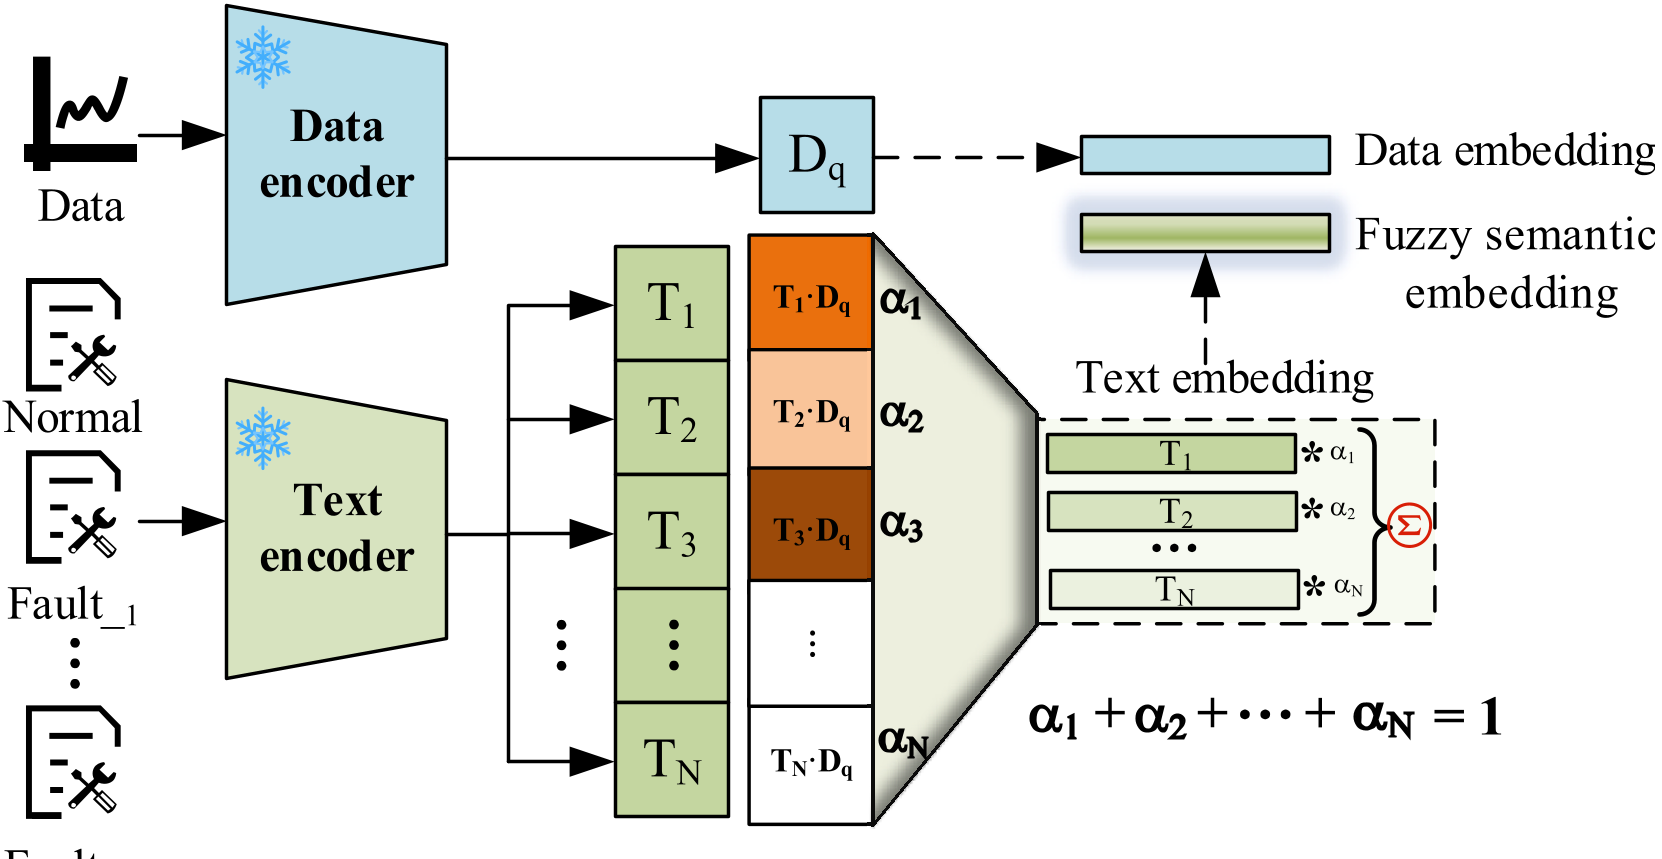
这是本文最大的亮点。面对由于噪声或工况重叠产生的暧昧特征,作者不再进行“非黑即白”的硬分类,而是计算待测样本与各个已知故障类别的相似度,构成一组“模糊权重”。 通过这种方式,输入给 LLM 的不再是一个孤立的点,而是一个包含上下文信息的语义场。LLM 结合这些模糊信息和预设的专业 Prompt 进行推理,能够极大地修正边界样本的分类结果。
3. 实验战绩:全方位的跨越
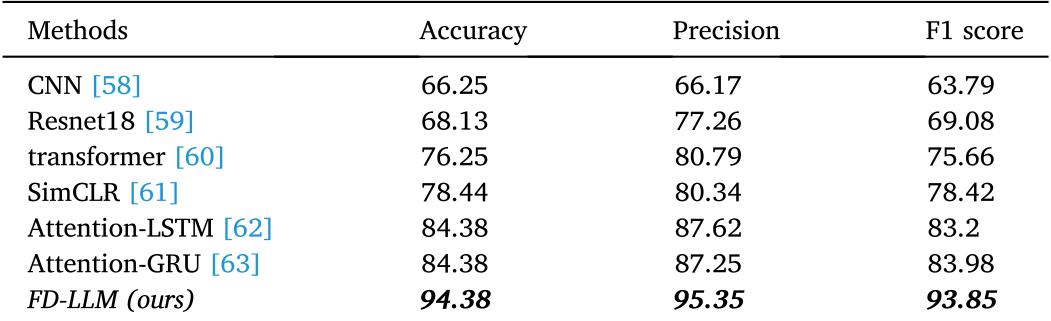
在航空发动机测试中,FD-LLM 在 Accuracy, Precision, F1 三大指标上实现了全面碾压。
- 对标 SOTA:相比于精心调优的 Attention-GRU,准确率从 84.38% 直接拉升到 94.38%。
- 通用性验证:在经典的 CWRU 轴承数据集和岩石钻机数据集上,FD-LLM 分别拿下了 98.79% 和 99.89% 的成绩。
4. 深度洞察
FD-LLM 的成功在于它精准捕捉到了 LLM 的真正价值所在:不是用来做端到端的黑盒分类,而是作为“知识融合器”。 通过 LoRA 微调,FD-LLM 在保持轻量化(低算力成本)的同时,成功激活了 LLM 在专业垂直领域的常识推理能力。这种“模糊输入 + 确定逻辑”的设计思路,为工业 AI 从特定任务向 AGI 演进提供了一个极具参考价值的范本。
局限性探讨: 尽管表现卓越,但该模型对第一阶段“数据-文本对”的高质量生成依赖较强。在完全未见过的极端新型故障面前,其自适应能力仍有待验证。此外,推理速度(~0.5s)在极高频实时监测场景中可能仍需进一步压缩。
关键词:Multimodal LLM, Fault Diagnosis, Modal Alignment, Aero-engine PHM, LoRA.