
FedCONST:利用凸约束突破联邦学习中的过拟合瓶颈
Federated Learning for Feature Generalization with Convex Constraints
本文提出了 FedCONST,一种通过凸约束(Convex Constraints)增强联邦学习(FL)特征泛化能力的方法。核心方法通过全局模型权重幅值作为特征强度指标,动态调整本地更新步长,在 CIFAR 等数据集上显著超越了 FedAvg、FedProx 及 MOON 等 SOTA 基线。
TL;DR
联邦学习(FL)常因客户端数据异构而陷入本地过拟合的泥潭。本文提出的 FedCONST 另辟蹊径,通过引入基于全局模型权重的两个“凸约束”(中心化与正交化),强制模型在保留强泛化特征的同时,重点挖掘未充分学习的弱特征。实验证明,该方法在不增加通信负担的前提下,大幅提升了模型的准确率与损失平面的凸性。
痛点深挖:为什么简单的对齐还不够?
在标准的 FL 流程(如 FedAvg)中,模型在异构客户端上训练时面临两大挑战:
- 本地过拟合:客户端数据量小且分布单一,模型容易迷失在局部的“偏见”中。
- 聚合扭曲:即使某个客户端学到了具备良好泛化能力的特征,这些特征在服务器端与其它“偏见更新”混合聚合时,往往会被冲淡或扭曲(Misalignment)。
现有的对齐方法(如 FedProx)虽然强制本地更新不要偏离全局模型太远,但这种限制是“盲目”的——它并没有区分哪些是真正有用的泛化特征,哪些是无意义的噪声。
核心直觉:权重大小即“特征强度” (Conjecture 1)
作者提出了一个极具物理直觉的猜想:全局模型中较大的权重代表了已经学得很好、具备鲁棒性的强特征;而较小的权重对应的是尚未开发或不稳定的弱特征。
这一猜想在理论上与梯度信噪比(GSNR)挂钩。通常计算 GSNR 需要复杂的统计,但在 FL 环境下,直接利用全局权重的幅值(Weight Magnitude)作为 GSNR 的代理(Proxy)是一种极低成本且高效的选择。
方法论:FedCONST 的双重凸约束
为了实现这一目标,作者在本地训练阶段植入了两个线性凸约束:
- 中心化约束 (Centralization Constraint): 确保梯度的均值为零,稳定训练,防止参数更新出现无偏偏移。
- 正交约束 (Orthogonal Constraint): 这是灵魂所在。 物理意义上,它要求模型更新量与已有的强特征向量正交。这意味着模型被禁止在已经“很强”的方向上继续堆砌权重(防止过拟合),转而强迫它在权重较小的“处女地”进行搜索。
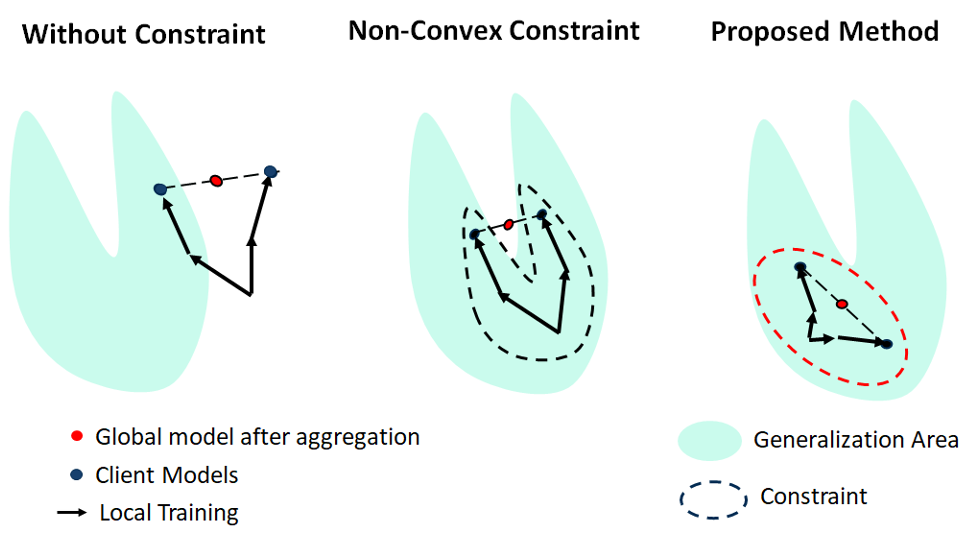 图 1:FedCONST 将优化轨迹引导至泛化区域,并通过凸约束确保聚合后的模型依然落在该区域。
实验战绩:全线飘红的性能提升
在 CIFAR-100 和 CIFAR-10 数据集上,无论是轻量级的 LeNet-5 还是经典的 ResNet-18,FedCONST 都展现了统治级的 SOTA 性能。
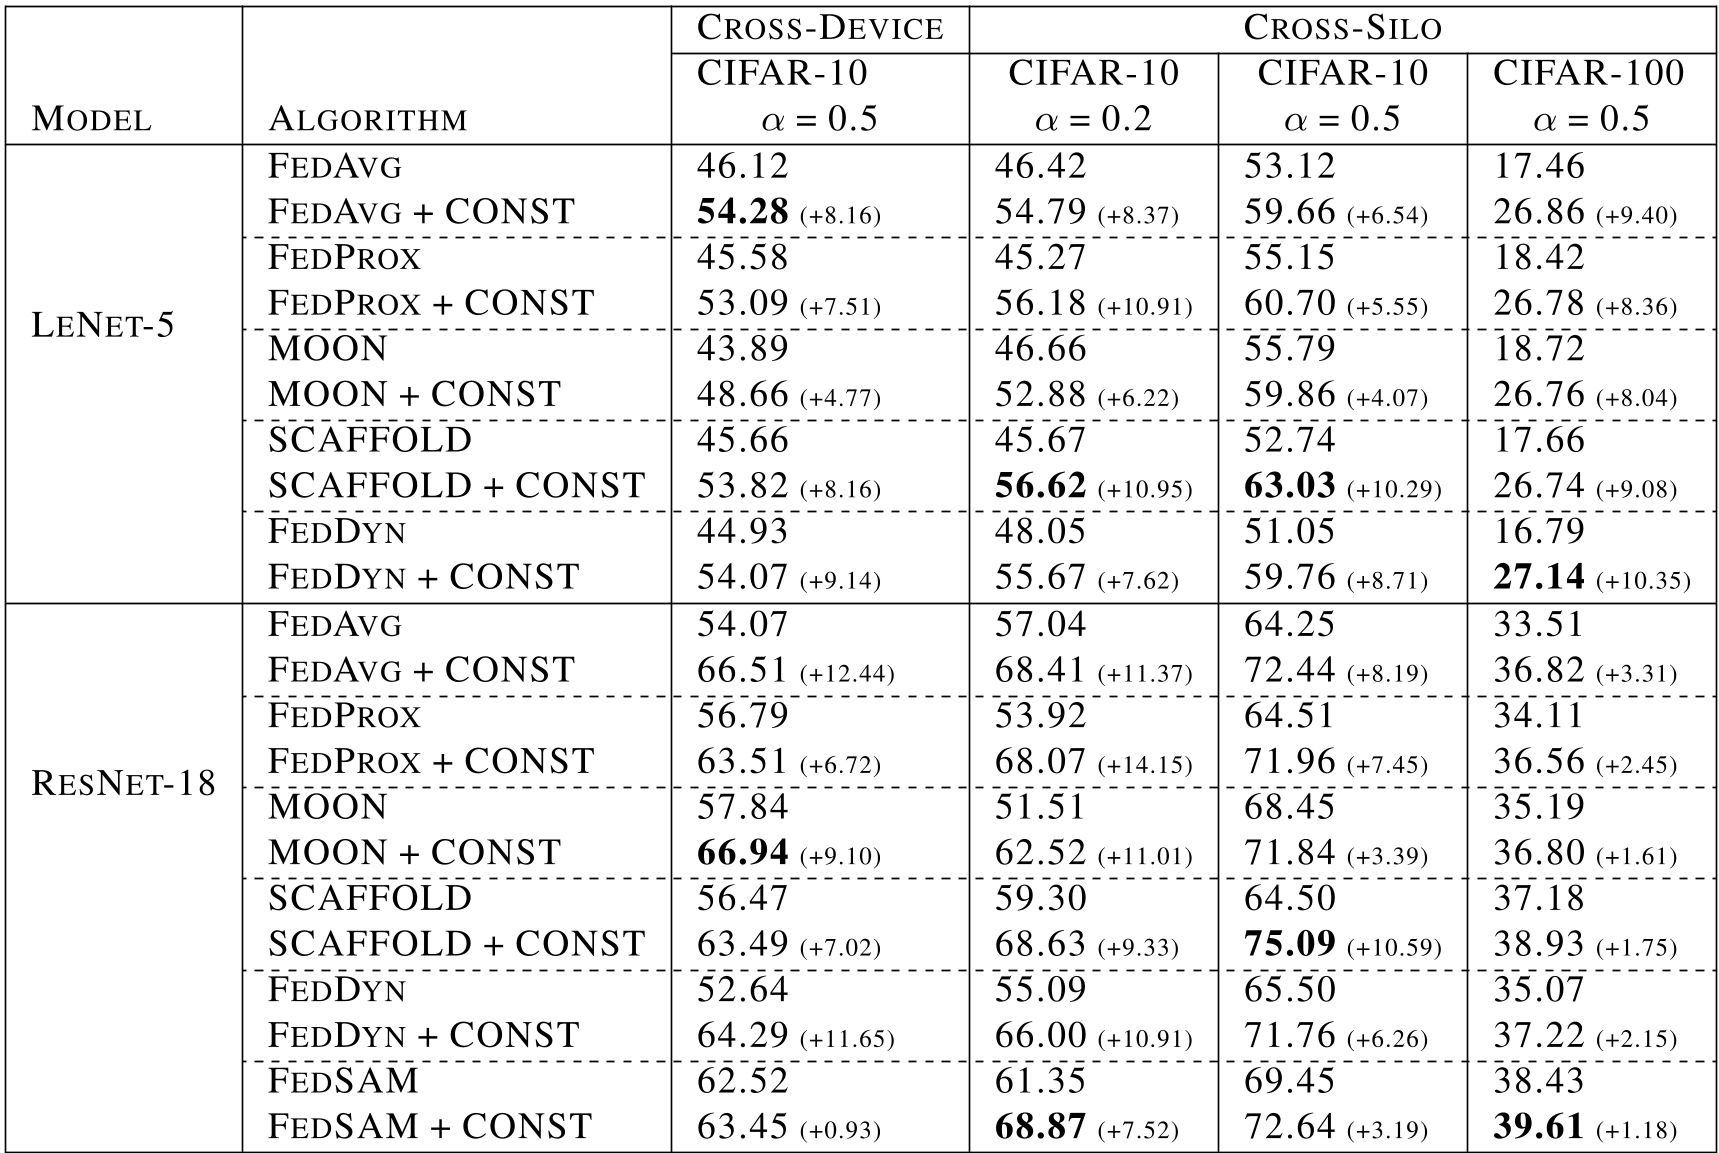 表 1:FedCONST 叠加在不同算法(FedAvg, FedProx, SCAFFOLD)上均带来了显著的准确率加分。
深度解析:损失平面的平滑化
为什么它有效?作者通过 Hessian 矩阵分析发现,FedCONST 显著增加了损失平面的 Convexity(凸性)。
- Vanilla FedAvg:容易收敛到鞍点,Hessian 迹(Trace)常为负。
- FedCONST:损失平面更像一个干净的“碗”,不仅 λmax 增大,且 λmin 显著优化,确保了模型向全局最优解稳定收敛。
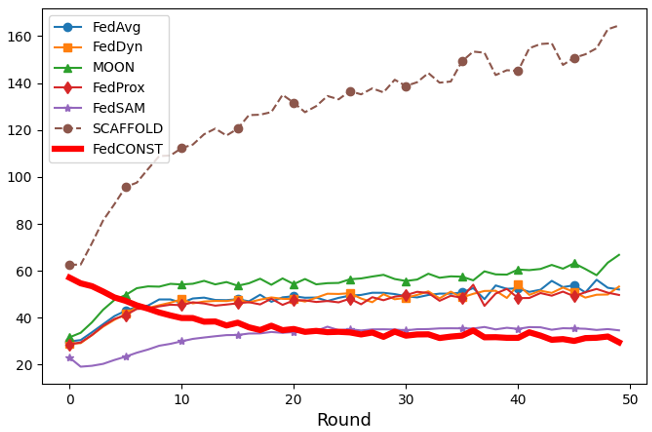 图 4:FedCONST 增强了客户端之间的一致性(Consistency),减少了异构数据带来的更新冲突。
总结与洞察
FedCONST 的成功证明了一个道理:在联邦学习这种受限环境下,“少即是多”。通过正交约束限制模型在过强特征上的冗余训练,反而释放了模型学习多样化特征的潜力。
局限性:虽然权重幅值是 GSNR 的良好代理,但在极大规模模型或经过剧烈剪枝的模型中,这种相关性是否依然稳健仍需进一步验证。此外,除去 Batch Normalization 的副作用也值得在更复杂的 Transformer 架构中探讨。
对于 FL 领域的研究者,FedCONST 提供了一个极佳的示范:与其设计复杂的通信协议,不如回归优化理论本身,利用简单的几何约束解决分布不匀带来的过拟合难题。