
FINSKILLOPS:把 SEC 文件问答可靠性做成可门控的技能运维系统
FINSKILLOPS: A Self-Evolving Multi-Agent System for SEC Filing QA
FINSKILLOPS 提出面向 SEC filing QA 的自演进多智能体系统,将复发失败转化为带适用条件的技能补丁,并通过定向验证、保护集回归和负控测试门控晋升。论文报告同一冻结技能注册在六个基准上取得最高 verdict-weighted correctness 与 reference consistency;增强内部基准正确性从 3.70 提升到 4.55,十二轮运行中监测非正确率从 20.0% 降至 12.5%。
核心速览
FINSKILLOPS 不是单纯增强 SEC filing QA 的检索或 agent 协作,而是把“部署后可靠性维护”形式化为技能补丁生命周期:系统先对失败答案做类型化诊断,再把重复出现的错误模式转成带触发条件、误触发保护和版本状态的自然语言技能;候选技能只有在目标验证集上提高正确率、在保护集上不引入回归、并在负控查询上不误触发时才能晋升。论文在六个金融问答基准上报告,使用同一冻结技能注册的 FINSKILLOPS 在 verdict-weighted correctness 和 reference consistency 上均领先所比较系统;增强内部基准的 W-Corr. 从 3.70 提升到 4.55,十二轮运维研究中 33 个候选技能只晋升 6 个,监测非正确率从 20.0% 降到 12.5%。
这项工作处在“自进化 agent”和“生产可靠性工程”的交叉点。它不像传统金融 RAG 工作那样把全部希望押在更强检索、更好辩论或更大模型上,而是把失败归因、补丁作用域和回归测试当作一等对象。论文的定位也不是刷榜型模型架构,而更像一套面向 SEC 文件问答的 skill registry 与门控发布流程;其价值判断主要来自六基准横向比较、组件消融和十二轮操作轨迹,而不是单一数学定理。
问题与动机
SEC 文件问答的难点并不止于“找不到证据”。论文在引言中指出,即使检索到相关 passage,系统也可能混用报告期、拼接不同实体的数字,或者计算出与引用金额不一致的份额。更麻烦的是,这类错误不是同一根因的不同表现:周期错配需要时间锚点规则,实体混淆需要公司或范围解析,证据冲突需要合并策略,计算错误需要重算分子分母和单位。把这些都压成同一个标量奖励,会让自动系统很难判断新行为到底该在哪里注入、会不会伤及原本正确的答案。
现有自改进方法可以从轨迹、反思或执行反馈中生成新行为,但其更新信号通常偏粗。论文 Related Work 段指出,SEC filing QA 需要在“哪条 claim 出错”的层面做归因,因为同一失败答案下可能同时存在 period、entity、evidence 和 calculation 错误;同时,准入决策必须考虑新行为可能破坏哪些已有正确答案。这一痛点判断非常具体:不是“模型不够聪明”,而是“修复没有作用域边界”。FINSKILLOPS 的动机正是把这种边界写进系统,让失败诊断、技能提出和发布门控形成闭环。
核心章节:把部署后改进形式化为门控技能维护
出发点:维护对象是技能注册,而不是重训模型
论文把任务形式化为:给定 SEC 文件语料 、自然语言问题 和检索到的证据 ,系统产生答案 ,参考答案为 。FINSKILLOPS 的核心更新对象是活跃技能集合 ,系统 与基础系统 在同一 serving 配置下只相差注入技能指令。由此,部署后改进被写成注册表更新:
其中 是离线演化轮次, 是当前注册表中可触发的技能集合, 是在失败反馈驱动下可能加入、修订、替换或退役后的集合。这个式子在论文中的作用不是定义一个 loss,而是划定优化边界:目标不是直接更新参数,而是在固定生成模型、检索索引和 agent 工作流的前提下,修改注入到 query decomposition 与 final synthesis 的自然语言行为。若把 置空,系统就退化为论文中的 multi-agent init.,也就是没有演化技能时的工作基底;若允许任意文本无门控进入 ,系统就变成常见的 self-editing agent,容易在目标错误上局部变好,却在全局回归上失控。
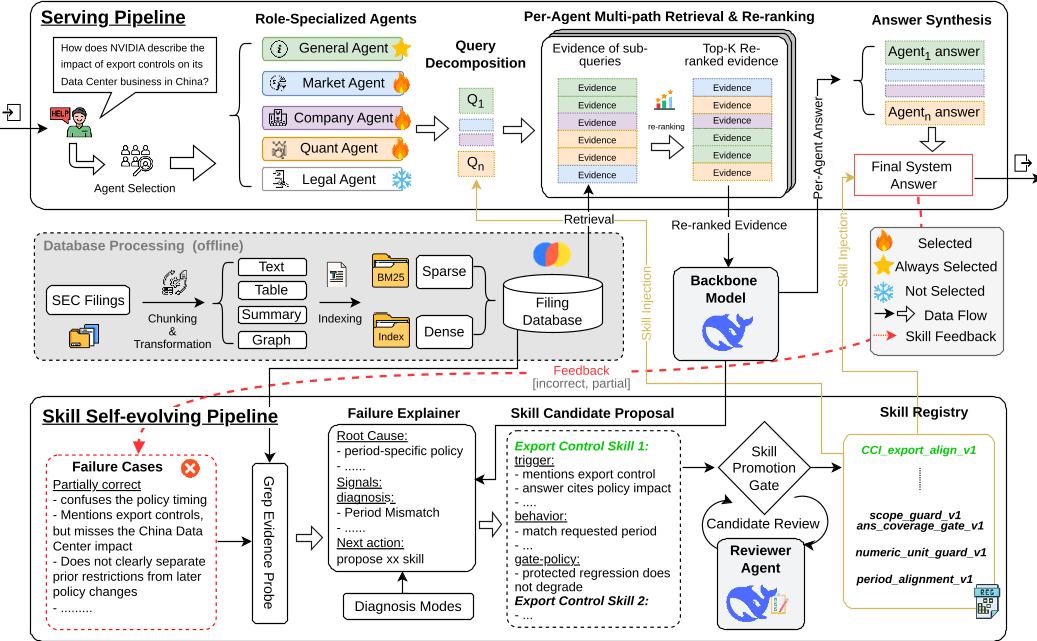
Figure 1 展示了两条路径:上方 serving pipeline 从经过 modality tagging 的文件索引中取证据,orchestrator 激活 general、quantitative、market、legal、company 五类 analyst agents,最终合成答案;下方 evolution loop 把失败答案送入诊断、技能提出和 Reviewer Agent,经过门控后写回 registry。这个结构的关键 Insight 是“修复要分阶段”:离线时可以使用 reference-derived feedback 和 judge 分析,但在线 serving 时不能使用参考答案或关键点评标,只能依赖 query、语料 metadata、证据特征和已冻结的技能条件。论文因此把技能触发设计为基于 applicability conditions 和 false-trigger guards 的运行时判断。
关键改动:从失败答案到带边界条件的技能补丁
FINSKILLOPS 的演化流程首先收集当前系统在一批演化问题上的失败实例。诊断分为两个 LLM 阶段:第一阶段读取问题、失败答案、judge 反馈和检索上下文,提出解释并生成针对 filing corpus 的检查计划;第二阶段读取计划执行后的文件片段,给出根因模式、支持证据,以及 propose、park 或 do-not-fix 的建议。中间使用 deterministic grep 执行检索计划,是为了让诊断不纯粹依赖模型自由联想,而是能定位到原文周期、实体、表格标签或指标别名。Appendix H 列出了十二轮记录中的八个 diagnosis modes,例如 Diag-C1 周期错配、Diag-C2 表格单位或行语义误读、Diag-B4 多证据融合失败等。
当某个错误模式的频率达到阈值 ,系统会起草或修订一个候选技能 。候选技能必须声明适用条件、需要执行的行为、排除情况,以及注入 serving pipeline 的具体位置。论文将晋升门控写成:
其中 是演化池中针对错误模式 的定向验证子集, 是轮内当前活跃集合, 是插入或修订候选 后的集合, 是 Correct verdict 的比例, 计算保护集 上从 Correct 变成非 Correct 的回归数, 计算在 no-op、multi-period、cross-company 等负控查询上的误触发数。这个门控是全文最本质的改动:它不再把“技能有没有用”简化为平均 reward 上升,而是把补丁效果拆成目标收益、回归破坏和错误激活三个维度。若只保留第一项,系统会退化为论文 5.2 节中的 w/o Protected Gate 设置;实验显示其定向验证增益可达 +0.78,但保护集回归数为 3。若去掉 FalseTrig 约束,技能可能只在目标样本上生效,却在范围外问题中错误改变检索或答案合成。
运行时注入点也有讲究。论文选择在 query decomposition 前注入一类技能,用于约束证据检索;在 final synthesis 前注入另一类技能,用于约束最终 claim。这是因为两个阶段可见的证据视图不同:前者主要能看到 section summaries,后者已经拿到检索到的 passages。若把同一行为粗暴塞入所有阶段,会放大误触发风险;若只在最终合成阶段修补,则检索污染或周期选择错误可能已经发生。FINSKILLOPS 的 skill registry 记录每个版本的来源失败、验证结果和保护集结果,晋升后的技能进入注册表,修订版本 supersede 旧版本,被其他技能吸收且不再触发的技能会在移除测试后退役。
依据与边界:生命周期不是堆技能,而是受控合并
论文十二轮研究给出了生命周期管理的直接证据。Section 5.3 说明,从 R5 到 R12 注册表始终保持 4 个活跃技能,而静态技能文本从 421 tokens 降到 347 tokens。R7 时,扩展后的 period/entity alignment v2 替换了较早版本;R12 时,fusion skill 吸收了 slot-coverage fallback 行为,使后者在移除测试通过后退役。Appendix I 的 Table 11 进一步列出六个晋升版本的证据:period errors 从 23 降到 7,unit errors 从 17 降到 5,slot errors 从 15 降到 6,calculation errors 从 11 降到 4,fusion errors 从 8 降到 2。这个轨迹说明技能演化并非单调增加 prompt 负担,而是会经历替换、冲突处理和退役。
论文也给出了两个候选失败案例,用来解释门控的必要性。Table 5 中,NVIDIA 导出管制问答的早期答案把 H20 后续限制和 FY2026 charges 混入 FY2025 叙述,被诊断为 period mismatch;Period Align 技能要求问题指定具体 fiscal year 或 policy period 且检索到时间冲突证据时,优先选择匹配期的披露。修复后答案从 PARTIAL 变为 CORRECT,4/4 key points matched。另一类 numerical 案例中,静态 prompt 已经要求周期锚定、明确分母和派生指标公式,但答案仍给出不一致的份额;multi-period alignment repair 技能要求把分子和分母对齐到同一期,重算 share,并替换与引用金额冲突的 draft percentages,最终从 60.7%、36.8%、2.5% 修正为 64.3%、30.8%、4.9%,4/4 key points matched。这里的价值在于,技能补丁不是泛泛“请仔细检查”,而是绑定到可检验的根因和可触发的条件。
实验与证据
主结果:冻结注册表带来正确性与引用一致性优势
论文用零样本 Qwen3-Max judge 对答案进行 verdict-weighted correctness(W-Corr.)和 reference consistency(Ref. Cons.)等维度评分。其 verdict 映射是 Correct 为 5、Partial 为 3、Incorrect 为 1、Failure 为 0,所有评估记录进入分母。论文用如下方式聚合分数:
其中 是纳入评估的答案数量, 是第 个答案经 judge 和评估后处理得到的分数。这个式子不同于“正确率比例”,因为它允许 Partial 获得中间分;它也更接近论文想衡量的对象:金融答案常常不是完全错或完全对,而是覆盖关键点的程度不同。FINSKILLOPS 的核心主张不是只优化某个单维分数,而是在正确性和引用一致性上同时领先所比较系统。
Section 5.1 指出,在同一冻结技能注册下,FINSKILLOPS 在全部六个基准上取得最高 W-Corr. 与 Ref. Cons.,且优势在 Zeekr 和增强内部基准上大于公开基准与 Lotus。公开基准中的 FinanceBench 上,FinGPT 在某些细粒度质量维度领先,FINSKILLOPS 与 FinDER 中最低 clarity 打平,这说明技能演化主要改善事实正确性与引用一致性,并不自动等同于所有表达维度最优。对工程系统而言,这个区分很重要:金融 analyst 最敏感的是周期、实体、数值和证据是否可查,而 clarity 与 style 只是辅助质量维度。
组件贡献:门控牺牲局部增益换取回归保护
Table 2 报告了组件消融,括号中的数值是 Full 减去 ablation 的 W-Corr. 差:
| 配置 | 目标验证正确率增益 | 增强内部基准 W-Corr. | FinanceBench W-Corr. | FinDER W-Corr. | 保护集回归数 |
|---|---|---|---|---|---|
| Full FINSKILLOPS | +0.62 | 4.55 | 3.49 | 2.88 | 0 |
| w/o Skill Evolution | +0.00 | 3.70 (+0.85) | 3.15 (+0.34) | 2.68 (+0.20) | 0 |
| w/o Protected Gate | +0.78 | 4.32 (+0.23) | 3.38 (+0.11) | 2.79 (+0.09) | 3 |
| w/o Failure Taxonomy | +0.31 | 4.08 (+0.47) | 3.28 (+0.21) | 2.70 (+0.18) | 0 |
这张表直接支撑了论文的中心论点:移除 Skill Evolution 造成所有三个基准上最大的 W-Corr. 下降,其中增强内部基准下降 0.85;移除 Failure Taxonomy 也导致 0.47 的下降,说明没有类型化归因时,技能提出容易把异质失败混在一起。最关键的反直觉证据是 w/o Protected Gate:它的 Target Val. ΔAcc 从 +0.62 提高到 +0.78,看似对目标错误更“有效”,但保护集出现 3 项回归,最终 W-Corr. 低于 Full。Appendix G 还给出 paired bootstrap intervals,FinanceBench 和 FinDER 上 Protected Gate 的区间包含零,这意味着门控收益在公开基准上可能不总是显著;它的主要作用更像生产风险控制,而不是无条件提升平均分。
Table 3 从单个技能移除角度提供第二层拆解:
| 技能 | 激活次数(内部 / FinanceBench / FinDER) | 去除后 W-Corr. | 下降量 |
|---|---|---|---|
| Period alignment v2 | 31 / 22 / 17 | 4.21 | +0.34 |
| Numeric unit guard v1 | 24 / 19 / 15 | 4.34 | +0.21 |
| Answer coverage gate v1 | 27 / 14 / 12 | 4.37 | +0.18 |
| Scope guard v1 | 19 / 6 / 5 | 4.43 | +0.12 |
表内下降量按 Full 的 4.55 减去去除后得分计算。Appendix G 给出 95% paired intervals:Period alignment v2 为 [0.18,0.50],Numeric unit guard v1 为 [0.06,0.36],Answer coverage gate v1 为 [0.03,0.33],Scope guard v1 为 [-0.02,0.26]。因此,周期对齐是最可归因于技能移除的组件,而 Scope guard 的贡献区间包含零,论文 5.2 也说明其区间包含零。这提示技能贡献并不均匀:SEC 文件中的时间锚定是最反复、也最容易被补丁改善的失败类型;实体范围守卫可能因为负控设计、触发频率或与其他机制重叠而难以单独验证。
十二轮运维轨迹:晋升稀少,但注册表持续收紧
论文在三个不相交集合上运行十二轮演化:300 题演化集用于失败诊断和定向验证,120 题保护集用于门控晋升,200 题监测集用于评估部署后效果。Figure 2 显示,演化集非正确率从 30.0% 降到 18.3%,监测集非正确率从 20.0% 降到 12.5%。更值得注意的是,33 个候选技能中只有 6 个被晋升,5 个候选因保护集检查被拒,暴露 7 项回归事件。这说明门控确实“慢”,但也说明技能库没有被失败样本淹没。
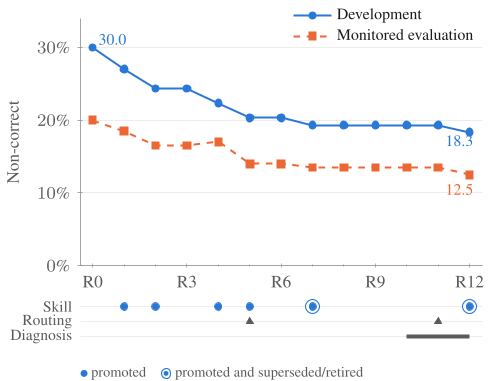
Table 4 进一步比较了论文适配的 AutoSkill 与 SkillOpt。四个基准为 Zeekr、Lotus、FinanceBench 和 FinDER,平均等权计算,Δ 是方法相对 multi-agent init. 的变化,Wins 表示高于初始状态的基准数:
| 方法 | 四个基准平均 W-Corr. | 相对初始平均的变化 | 高于初始的基准数 |
|---|---|---|---|
| AutoSkill | 2.00 | -1.22 | 0/4 |
| SkillOpt | 2.66 | -0.56 | 0/4 |
| Multi-agent init. | 3.22 | - | 0/4 |
| FINSKILLOPS | 3.66 | +0.44 | 4/4 |
这组数字支持 FINSKILLOPS 的核心假设:仅有自进化接口不够,更新是否被门控、是否带适用条件、是否有保护和负控测试,决定技能是帮助还是伤害系统。论文 Appendix K 也谨慎说明,这些结果是 filing-QA adapter 的结果,不同更新与注入接口使比较复杂,且未严格匹配演化预算。因此,Table 4 应理解为“在同一 filing substrate 上比较三类技能演化流程”的证据,而不是证明 gate 单独贡献所有增益的严格实验。
论文还做了六个公共基准演化 pilot。Section 5.3 与 Appendix L 报告,在 FinanceBench 和 SECQUE 上重复六轮演化后,监测集 W-Corr. 分别提升 0.40 和 0.25,最终各有 2 个 active skills。Appendix L 的 registry comparison 还显示,in-house registry 在两个 benchmark monitoring subsets 上高于本地演化 registry。这说明技能注册并非越本地化越好,但作者也承认这类 pilot 与十二轮主研究不同,不能替代对跨域泛化的系统证明。
深度洞察与总结
FINSKILLOPS 的贡献不是让 LLM 多学了几条 prompt,而是把 agent 的可靠性改进重写成软件工程里的 patch review:失败必须有类型,补丁必须有 scope,发布必须有回归测试,注册表必须有版本和退役机制。它把 financial QA 中常见的“检索到了还答错”拆解为可诊断的 period、entity、evidence、calculation 等模式,再用带触发条件的自然语言技能在两个注入点影响行为。相比 AutoSkill 与 SkillOpt,最本质的差别在于技能不是只要被提取或被优化就算成功,而是必须证明自己不会破坏过去已经正确的答案。
这个工作的工程启示很强:对于高风险文档问答,自改进系统的首要产物应该是可审计的 registry、promotion log 和 negative controls,而不是更大的技能数量。Table 10、Table 11、Table 12、Table 13 组成的十二轮记录展示了一种少见的运维式证据链:候选为什么被拒、冲突如何处理、版本为什么替换、技能为什么退役。对 SEC 文件这类错误代价高的任务,这种证据比单一 benchmark score 更能说明系统成熟度。
局限性也必须具体看。Section 7 指出,证据主要覆盖 SEC filing QA,Appendix K 的 AutoSkill 和 SkillOpt 比较没有严格匹配演化预算;十二轮研究同时修改了 routing 和 diagnosis,因此它测量的是部署改进轨迹,而不是技能文本的孤立因果效应。监测集每轮都评估,不能直接等同于 blind generalization。保守门控导致 33 个候选中 27 个被拒绝、延迟或撤回,说明系统适应性被显著牺牲。金融专家评审路线未配置,准入依赖自动检查;judge-human agreement 研究使用作者组标注者,而非独立金融领域专家。Appendix G 还承认可用 candidate artifacts、admission logs 和 split manifests 不完整,这会影响门控决策和演化输入与基准题之间分离的可验证性。
从后续研究看,最有技术含量的方向不是继续加技能数量,而是把 gate 设计得更可扩展:例如用多 judge 或独立专家样本降低自动准入偏差,用 matched-budget A/B 框架隔离 skill text 与 routing/diagnosis 的贡献,把 protected suite 从静态高难样本升级为对抗性漂移样本,并把 false-trigger guard 写成可学习的校准模型。若 FINSKILLOPS 的门控注册表能迁移到合规审计、财报电话会、监管备忘录问答等高噪声文档流,它可能更接近真正的 LLM agent 运维体系,而不是单场景金融 QA 技巧。