
FlashAttention:打破内存墙,实现 IO 感知的极致注意力优化
FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
本文提出了 FlashAttention,一种 IO 感知的精确注意力算法。通过在 GPU HBM 与 SRAM 之间使用平铺(Tiling)和重计算(Recomputation)技术,显著降低了内存读写频率,在保持数学精确性的同时实现了超越近似注意力方法的运行速度。
TL;DR
在深度学习领域,我们习惯于通过减少 FLOPs 来衡量算法的优劣。然而,由斯坦福大学 Tri Dao 等人提出的 FlashAttention 揭示了一个残酷的现实:对于注意力机制而言,制约速度的往往不是“算得慢”,而是“读写慢”。FlashAttention 通过 IO 感知 (IO-Aware) 的分块平铺技术,在不牺牲任何精度的前提下,实现了比近似注意力方法更快的运行速度和更低的内存消耗。
痛点深挖:被忽视的内存瓶颈
传统的 Transformer 注意力计算(Standard Attention)流程如下:
- 从 HBM(显存)读取 Q, K,计算注意力分数 ,写回 HBM。
- 从 HBM 读取 ,计算 Softmax 得到 ,写回 HBM。
- 从 HBM 读取 和 ,计算输出 ,写回 HBM。
在现代 GPU(如 A100)上,算力的增长远超带宽。上述流程中频繁的显存读写成为了绝对的性能杀手。虽然 的中间矩阵 在逻辑上必不可少,但将其反复在高速 SRAM(片上快取)和慢速 HBM 之间搬运,导致了严重的 内存受限 (Memory-bound) 问题。
核心机制:分块平铺与重计算
FlashAttention 的天才之处在于将两个经典技术引入了注意力算子:
1. 增量 Softmax 与平铺 (Tiling)
Softmax 通常需要看到整行数据才能确定归一化分母。FlashAttention 利用了 Softmax 的拆分性质,通过引入额外的统计量(最大值 和总和 ),实现了在不访问全行数据的情况下,逐块更新输出。
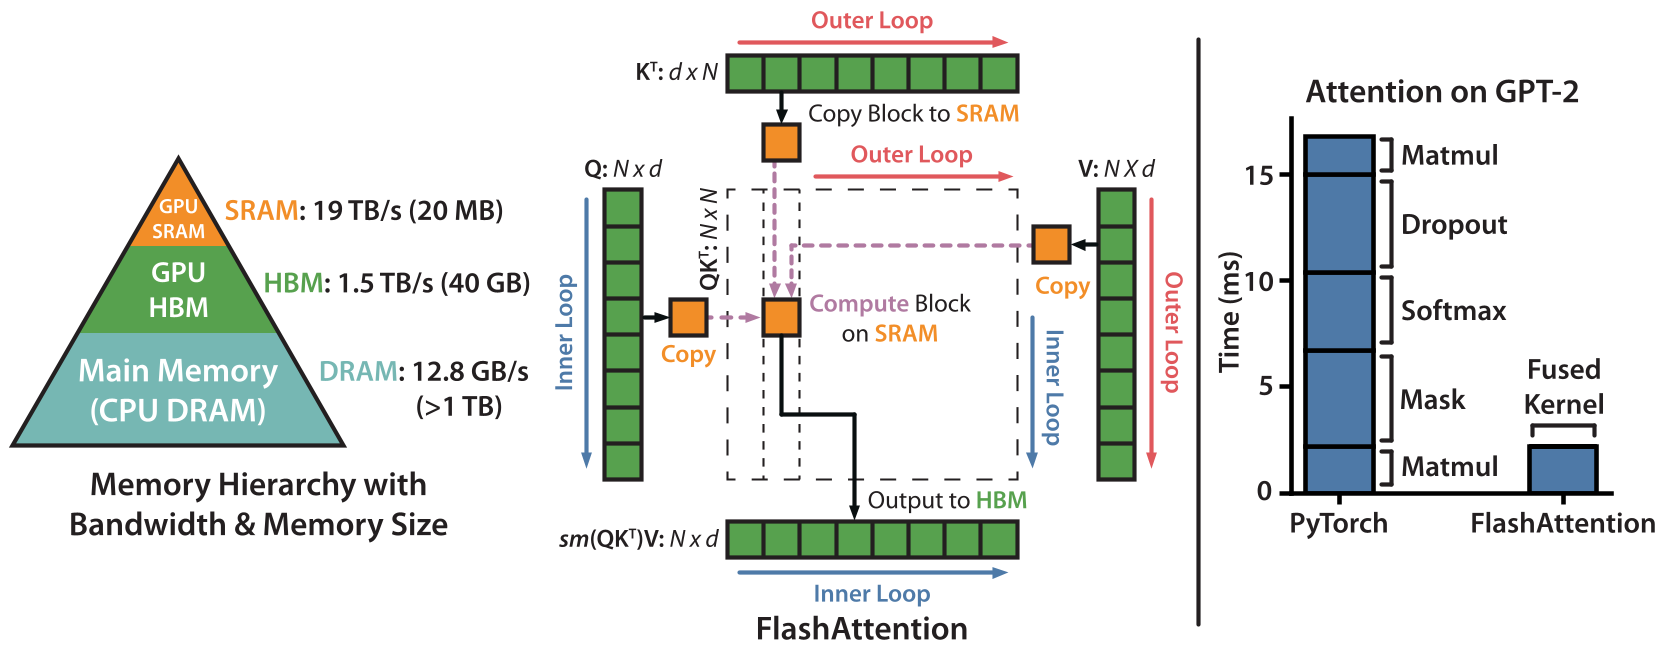 如上图左侧所示,算法通过嵌套循环遍历 Q, K, V 代码块,将计算完全限制在 SRAM 内部,最终只将压缩后的结果写回 HBM。
2. 反向传播中的重计算 (Recomputation)
为了执行链式法则,反向传播通常需要前向传播产生的所有中间矩阵。FlashAttention 并没有存储巨大的 矩阵,而是选择在反向传播时从 HBM 读取精简的统计量,动态重新计算必要的注意力块。虽然这增加了总计算量(FLOPs),但由于减少了海量的 HBM 读写,总耗时反而显著降低。
实验与结果:全方位碾压
FlashAttention 在多个维度展示了压倒性的优势:
- 训练速度:在相同的显卡上,GPT-2 的训练速度提升了 3 倍;BERT-large 的训练打破了当时的 MLPerf 记录。
- 内存效率:内存占用从序列长度的平方级 () 降至线性级 ()。这意味着在 40GB 的 A100 上,它可以处理长达 64K 的序列,而不会出现 Out of Memory (OOM)。
- 模型质量:更长的上下文带来了实质性的进步。它首次让 Transformer 解决了 Path-X (16K 像素序列) 分类任务,此前所有模型在此任务上都等同于随机猜测。
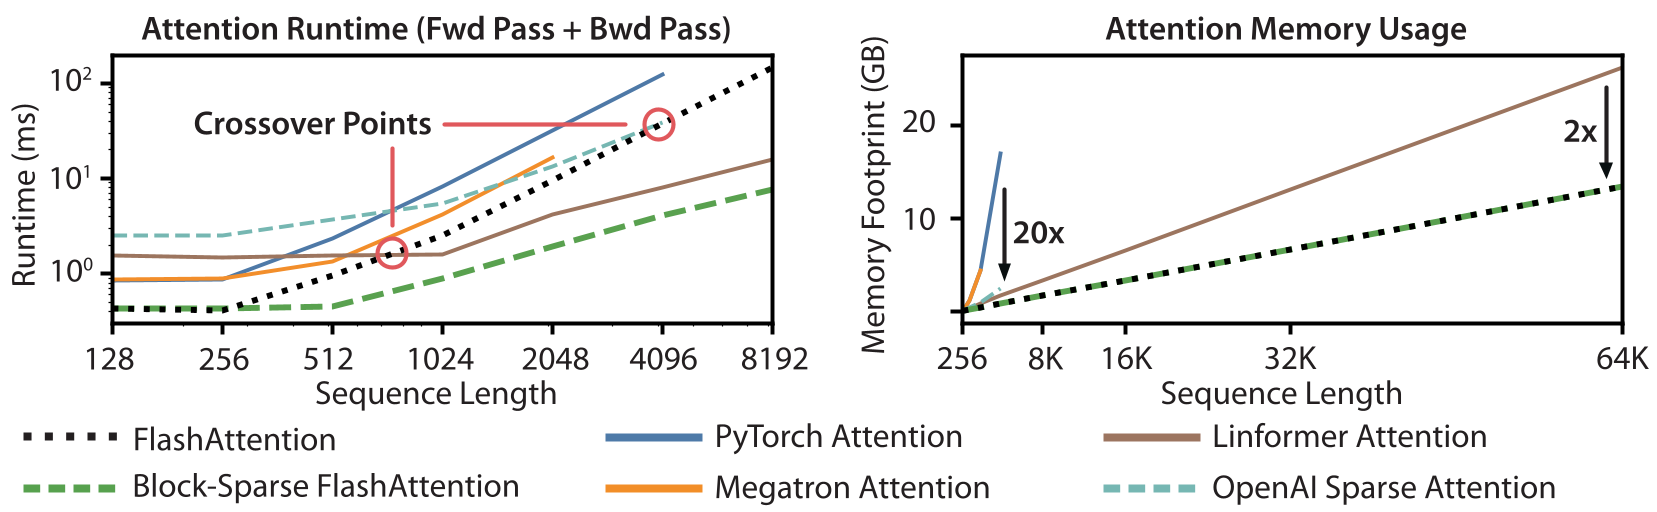 实验数据清晰显示,随着序列长度增加,FlashAttention 的耗时增长远比 PyTorch 原生实现平缓,展现了优异的扩展性。
深度洞察:IO 感知是未来的标准
FlashAttention 的成功证明了一个观点:算法设计不能脱离底层硬件特性。在“算力过剩、内存贫瘠”的 AI 芯片时代,关注如何最小化数据搬运将成为系统优化的核心。
此外,作者还提出了 Block-Sparse FlashAttention,将分块理念与稀疏性结合,进一步将 IO 复杂度降低了一个数量级。
局限性与挑战
尽管表现卓越,FlashAttention 目前仍面临一些挑战:
- 编写门槛高:其核心逻辑是用 CUDA 实现的高级内核,普通开发者难以根据自己的特殊需求(如新型激活函数)进行快速魔改。
- 硬件依赖:虽然目前支持 Turing 和 Ampere 架构,但针对不同架构(如不同 SRAM 大小)仍需精细的参数调优。
总结
FlashAttention 不仅仅是一个更快的算子,它是 Transformer 进入“超长上下文时代”的入场券。无论是现在的推理加速插件,还是各路 LLM 库(如 Megatron-LM),FlashAttention 已经成为了事实上的性能标配。