
FMA-Net:打破界限,视频超分与去模糊的逻辑重构
FMA-Net: Flow-Guided Dynamic Filtering and Iterative Feature Refinement with Multi-Attention for Joint Video Super-Resolution and Deblurring
本文提出了 FMA-Net,一种联合解决视频超分辨率(VSR)与去模糊(Deblurring)任务(合称 VSRDB)的深度学习框架。核心方法包括流引导动态过滤(FGDF)和带有多注意力机制的迭代特征精益(FRMAs),在 REDS4 数据集上达到了 SOTA 性能。
在视频增强领域,超分辨率(Super-Resolution)和去模糊(Deblurring)通常被视为两个独立的战场。然而,现实中的视频降质往往是“屋漏偏逢连夜雨”:模糊伴随着低分辨率。本文介绍的 FMA-Net(Flow-Guided Dynamic Filtering with Multi-Attention Network)向我们展示了:与其分而治之,不如合而为一。
TL;DR
FMA-Net 是一款专门为**联合视频超分与去模糊(VSRDB)**设计的深度学习框架。它通过流引导的动态滤波(FGDF)解决了大运动模糊建模难的问题,并利用多注意力迭代优化特征。在 REDS4 等权威榜单上,它以 PSNR 提升超过 1.0 dB 的巨大优势,刷新了视频恢复的 SOTA 记录。
痛点深挖:为什么 1+1 < 2?
传统的处理逻辑通常是“级联式”的:先超分再去模糊,或者反之。这种做法存在两个致命缺陷:
- 误差传播:前置任务产生的伪影会被后置任务放大。
- 感受野瓶颈:面对物体高速移动产生的模糊,传统固定位置的滤波器需要巨大的卷积核才能覆盖运动轨迹,这会导致参数量爆炸,且难以捕捉精细纹理。
核心逻辑:运动轨迹之上的动态预测
FMA-Net 的技术突破主要体现在以下两个核心组件:
1. 流引导动态过滤 (FGDF)
传统的动态滤波器(Dynamic Filtering)在计算每个像素时,其采样邻域是固定的方形区域。 FMA-Net 的直觉是:既然模糊是由运动产生的,那么滤波器的采样点也应该顺着运动轨迹走。如图所示,FGDF 结合了光流(Optical Flow)的信息,将滤波器的“触角”延伸到了物体运动的源头。
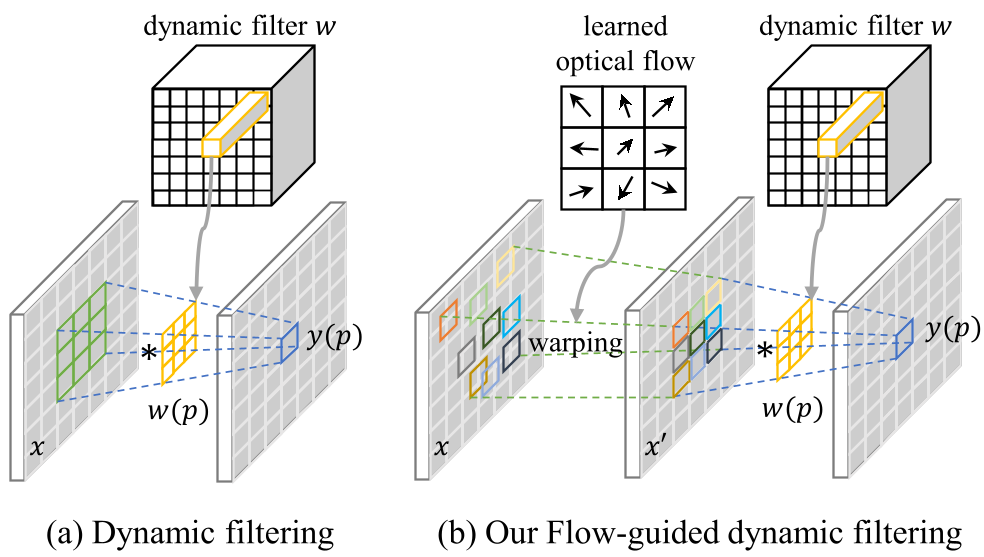 图 1:(a) 传统动态过滤 vs (b) 本文提出的 FGDF。FGDF 能够根据光流灵活采样邻域。
2. 多注意力迭代精益 (FRMA) 与时间锚定损失
为了处理复杂的降质,作者设计了 FRMA 块。它包含两种注意力:
- 中心导向注意力 (CO Attention):强制当前帧特征与中心参考帧对齐。
- 降质感知注意力 (DA Attention):将预测的降质核信息注入特征,使网络实现“全局自适应”。
此外,作者提出了 Temporal Anchor (TA) Loss。其物理直觉是,在对齐特征的同时,不能丢失每一帧本身的时空独立性。TA Loss 能有效抑制特征在迭代过程中的模糊化。
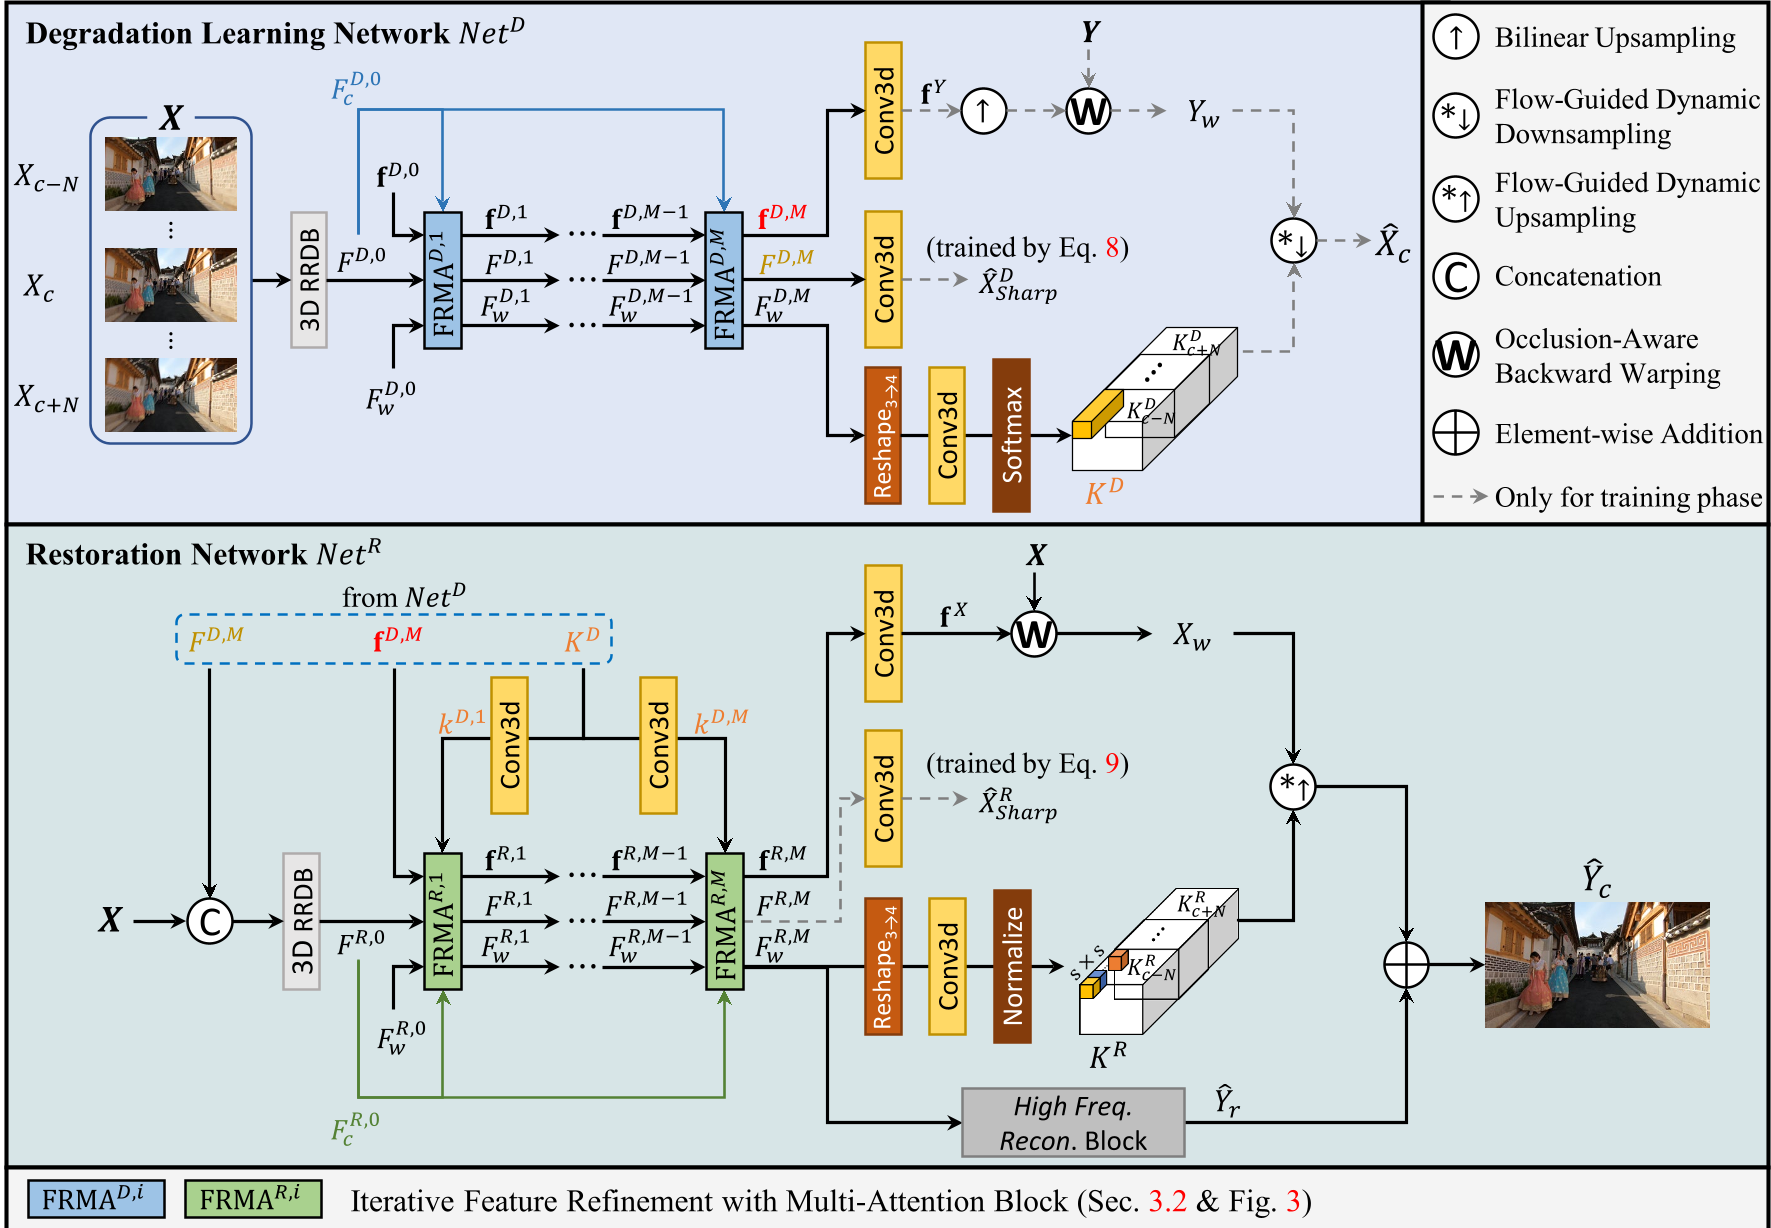 图 2:FMA-Net 总体架构,包含降质学习网络(NetD)和恢复网络(NetR)。
实验战果:降维打击
在实验对比中,FMA-Net 的表现可以用“碾压”来形容。
- 性能提升:在 REDS4 测试集上,FMA-Net 的 PSNR 达到了 28.83 dB,远超 BasicVSR++ (27.06 dB) 和 RVRT (27.80 dB)。
- 运动韧性:在运动幅度大于 40 像素的极端场景下,FGDF 带来的增益尤为明显,显示了其在处理“动态模糊”时的核心竞争力。
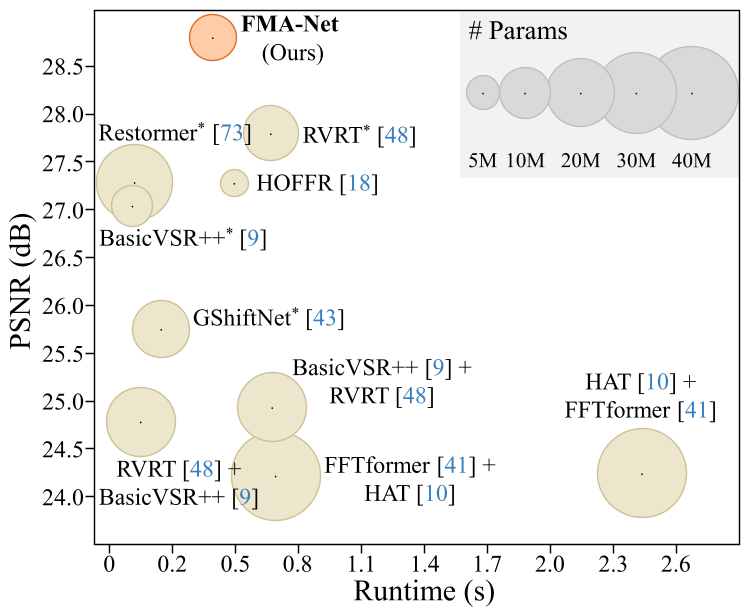 图 3:不同方法在 REDS4 上的视觉对比。可以看到 FMA-Net 恢复的文字和纹理明显更加清晰。
局限性与展望
尽管 FMA-Net 表现优异,但其基于光流的设计在面对极端物体旋转时仍有局限性(因为光流难以完美建模旋转)。未来的研究可能会引入可学习的单应性矩阵或四元数表示来增强旋转运动的建模能力。
总结
FMA-Net 的成功证明了:在视频恢复任务中,运动补偿不应该仅仅是一个预处理步骤(Alignment),而应该深度参与到滤波器权重的生成过程中。这种“轨迹敏感型”的动态卷积,为未来实时高清晰视频通信和老旧胶片修复开辟了新的技术路径。