
告别手动写脚本:Agentic AI 开启科学工作流自动化的新范式
From Research Question to Scientific Workflow: Leveraging Agentic AI for Science Automation
本文提出了一个名为技能驱动的智能架构(Skill-driven Agentic Architecture),旨在通过 LLM、确定性生成器和专家知识库联动的机制,自动将自然语言形式的研究问题转化为可在 Kubernetes 上运行的复杂科学工作流。该方法在 1000 Genomes 群体遗传学任务中实现了 83% 的意图提取准确率,并显著降低了资源损耗。
TL;DR
科学家只需要问一句:“对比欧洲和非洲人群在 1-5 号染色体上的突变模式”,AI 就能自动查找坐标、写好配置文件并在 Kubernetes 集群上跑起来?这篇来自波兰 AGH 理工大学的研究,通过 三层智能架构(语义-确定性-知识) 填补了科学意图与底层计算之间的空白,在保证科学严谨性的同时,让数据传输效率提升了 10 倍。
背景定位: 它是科学自动化(Science Automation)领域的一个重要进展,填补了传统工作流管理系统(WMS)与生成式 AI 之间的鸿沟,属于“AI for Science”中的架构创新工作。
痛点深挖:研究意图与计算逻辑的“语义鸿沟”
在目前的科研环境中,运行一个工作流已经很成熟(Nextflow, Pegasus 等),但定义一个工作流却是噩梦。科学家需要处理:
- 领域词汇转换:将“欧洲人群”映射为 1000 Genomes 项目中的
EUR代码。 - 基础设施适配:根据集群的 vCPU 数量手动计算并行任务数。
- 非确定性风险:直接让 ChatGPT 写工作流 DAG,今天跑出的结果可能和明天不一样,这对科学研究是致命的。
核心方法论:解耦语义理解与任务执行
为了解决这些问题,作者提出了一个“不让 LLM 直接碰执行逻辑”的架构:
1. 技能(Skills):领域专家的 Markdown 笔记
不同于传统的向量数据库(RAG),这里的“技能”是专家直接用 Markdown 写的表格。它定义了:
- 词汇映射:疾病名 → 基因坐标(如:乳腺癌 → BRCA1/2)。
- 优化策略:是在本地处理全量数据,还是只拉取部分片段?
2. 三层架构解析
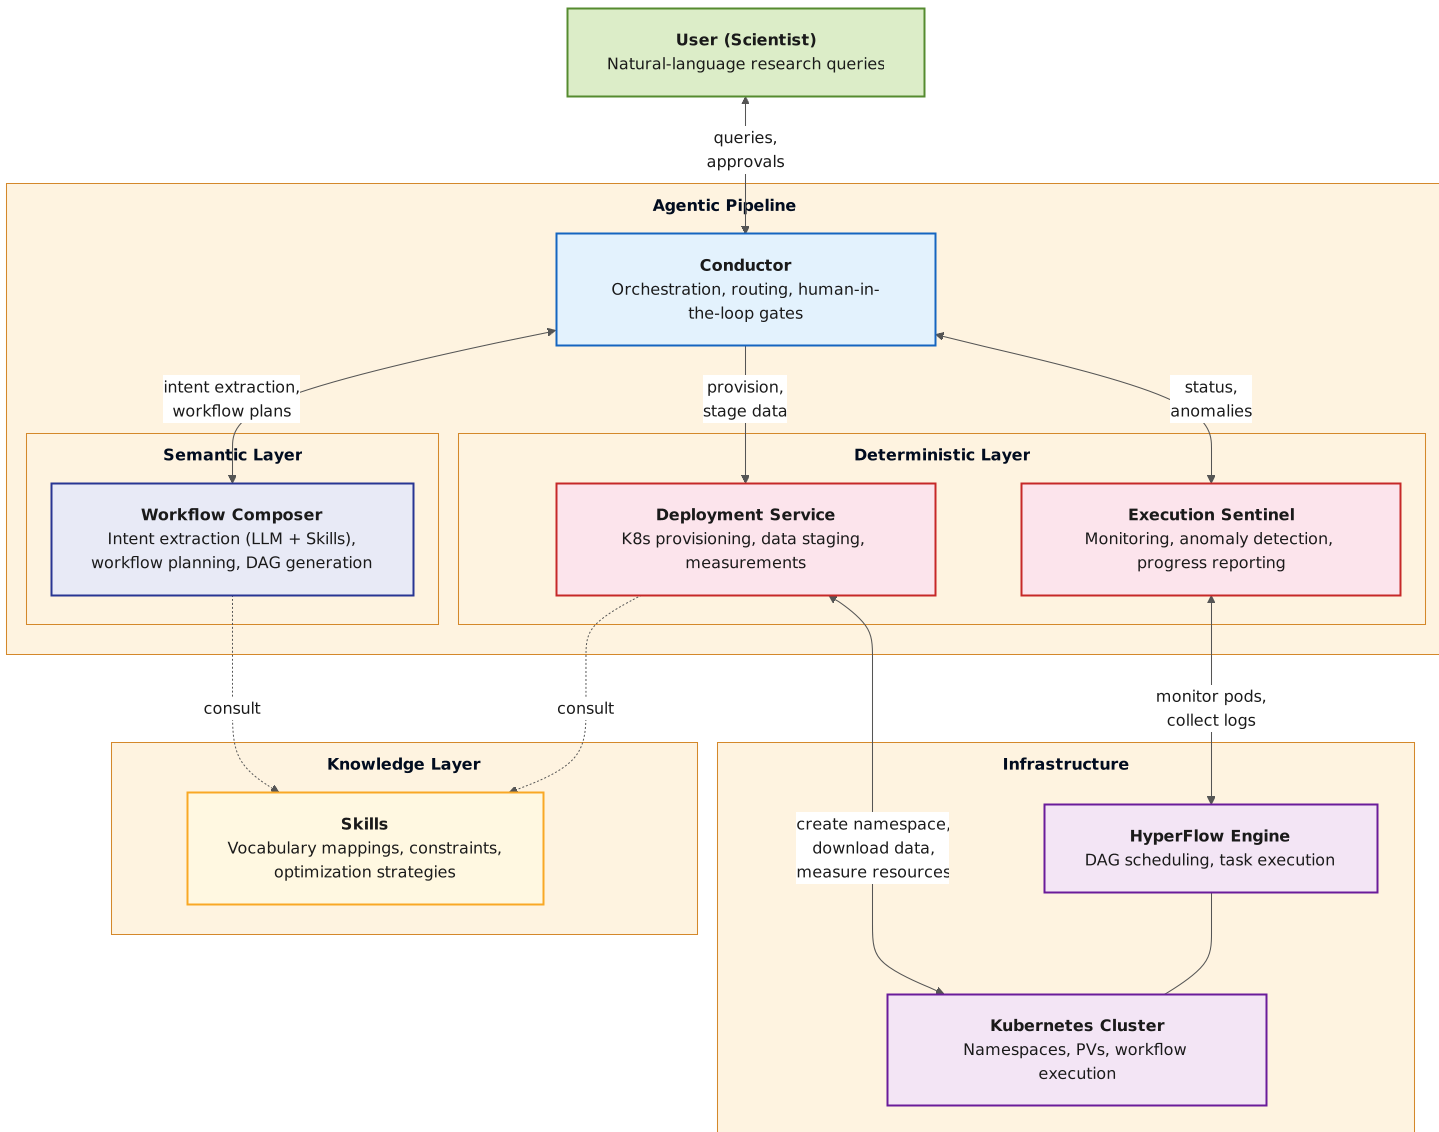
- 语义层:LLM 结合 Skills,把自然语言翻译成一个结构化的 JSON 意图(ResearchIntent)。
- 确定性层:一旦意图固定,由传统的代码生成器生成 DAG 图。同一个意图,永远生成同一个工作流。
- 知识层:作为外部权威源,为语义提取提供精确锚点。
实验战绩:精准且高效
研究人员在“1000 人类基因组计划”工作流上对该方案进行了严谨评估:
- 准确率飙升:在没有任何背景知识(S0)时,LLM 意图匹配率仅为 44%,但在挂载了 Skills(S3)后,准确率跃升至 83%。
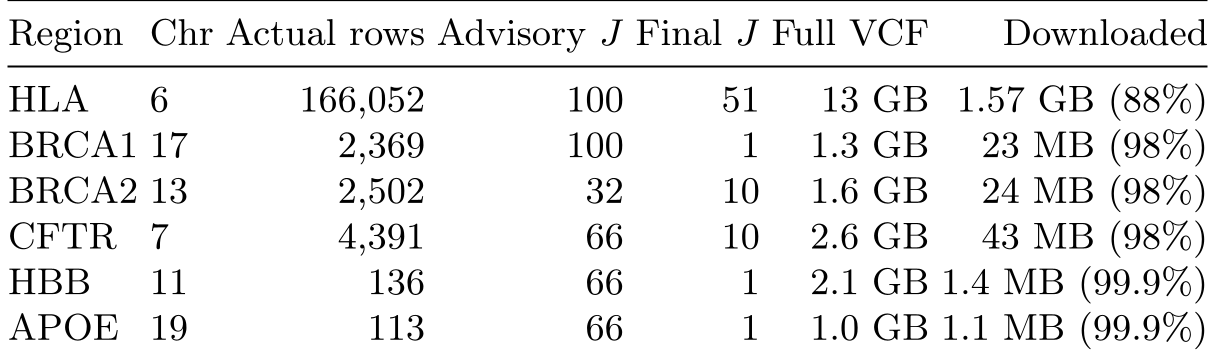
- 延迟生成 vs 提前预估:系统不是一开始就决定并行度。它先启动环境检查数据大小,再计算并行度。这种“延迟策略”使得小规模任务(如 HBB 基因)的并行任务数从 66 个优化到 1 个,避免了资源浪费。
- 数据节省:利用 Tabix 索引技术结合 Skills 中的提取策略,系统仅下载了 1.69 GB 数据,相比全量下载(21.6 GB)减少了 92%。
深度洞察:为什么这很重要?
这篇文章的本质贡献在于对 LLM 幻觉 的有效管控。它通过“意图提取 → 确定性映射”这条路径,把 LLM 关进了“只能做语义解析”的笼子里,而执行权交还给了经过验证的业务逻辑。
对于科学界来说,这意味着:
- 可审计性:Skills 是纯文本,专家可以随时修改和审查。
- 平民化科研:不懂 Kubernetes 的生物学家,只需说话就能调用昂贵的计算集群。
局限性与未来
目前系统的主要局限在于 Skills 的编写仍需人工。未来如果能自动化地从现有的科学文献中提取并生成 Skills,科学自动化的“最后一公里”将真正被打通。
总结:这一工作不仅是技术上的整合,更提供了一种在大语言模型时代保护“科学复现性”的模板。