
从 SFT 到 RL:解密漏洞检测 LLM 的后训练炼金术
From SFT to RL: Demystifying the Post-Training Pipeline for LLM-based Vulnerability Detection
2026-01-01
总结
问题
方法
结果
要点
摘要
本文提出了 OpenVul,这是第一个针对基于大语言模型(LLM)的漏洞检测(VD)后训练(Post-training)全流程的系统性研究。该工作涵盖了从冷启动 SFT 到离线偏好优化(DPO/ORPO),再到在线强化学习(GRPO)的完整路径,并发布了高质量的上下文感知漏洞数据集。
TL;DR
漏洞检测(Vulnerability Detection, VD)在安全领域至关重要。本文通过 OpenVul 项目,首次拆解了 LLM 在安全任务中的后训练全流程。核心发现是:在线强化学习(GRPO)结合“根因驱动”的细粒度奖励,能让 4B 小模型在该任务上的表现反超数百 B 的巨型模型。
现状剖析:为什么直接微调(SFT)行不通?
在通用的代码任务中,SFT(监督微调)通常能带来显著增益。但在漏洞检测中,研究者发现两个致命问题:
- 合理化幻觉 (Rationalization Hallucination):如果 SFT 训练数据是让老师模型看着补丁去写解释,学生模型会学会“脑补”一些不存在的 CVE 背景,而不是从逻辑上判断漏洞。
- 判别力缺失:漏洞与其补丁(Patch)之间可能只有一行代码之差。只练正面教材(Correct Answers),会让模型在面对极其相似的干扰项时束手无策。
核心贡献:OpenVul 的后训练流水线
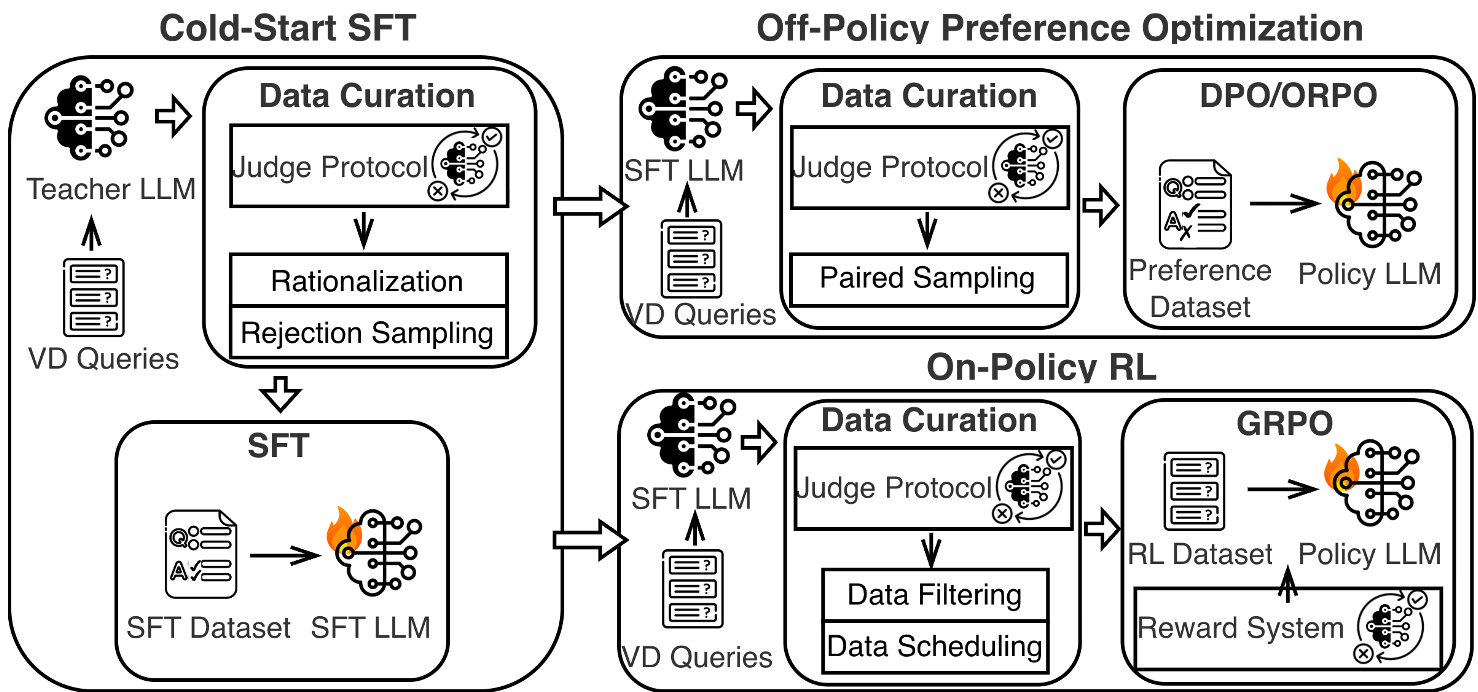
作者系统性地对比了多种后训练策略,架构图如下:
1. 数据策展 (Data Curation)
- 拒绝采样 vs 合理化:实验证明,通过拒绝采样筛选出的纯净推理链,比带着“已知答案”生成的合理化数据效果好得多(P-Pass@1 提升 201.7%)。
- 上下文感知:为了避免模型“因语义失明而产生幻觉”,作者构建了包含全局变量、宏定义和被调用函数的丰富上下文数据集。
2. 交互式强化学习 (On-policy RL)
这是本文的“重头戏”。作者采用了 GRPO (Group Relative Policy Optimization),通过以下改进解决了 VD 任务的特殊性:
- 配对调度 (Pairwise Scheduling):强制将漏洞版本和补丁版本放在同一个训练 Batch 中,通过对比学习增强模型对“安全/不安全”界限的锚定。
- 细粒度奖励 (Fine-grained Rewards):不再简单地根据对错给 +1/-1。系统会评估模型的根因分析(Root-cause)是否与事实相符。
实验战绩:四两拨千斤
在 OpenVul 框架的加持下,仅有 4B 参数的 Qwen3 模型展现出了惊人的战斗力:
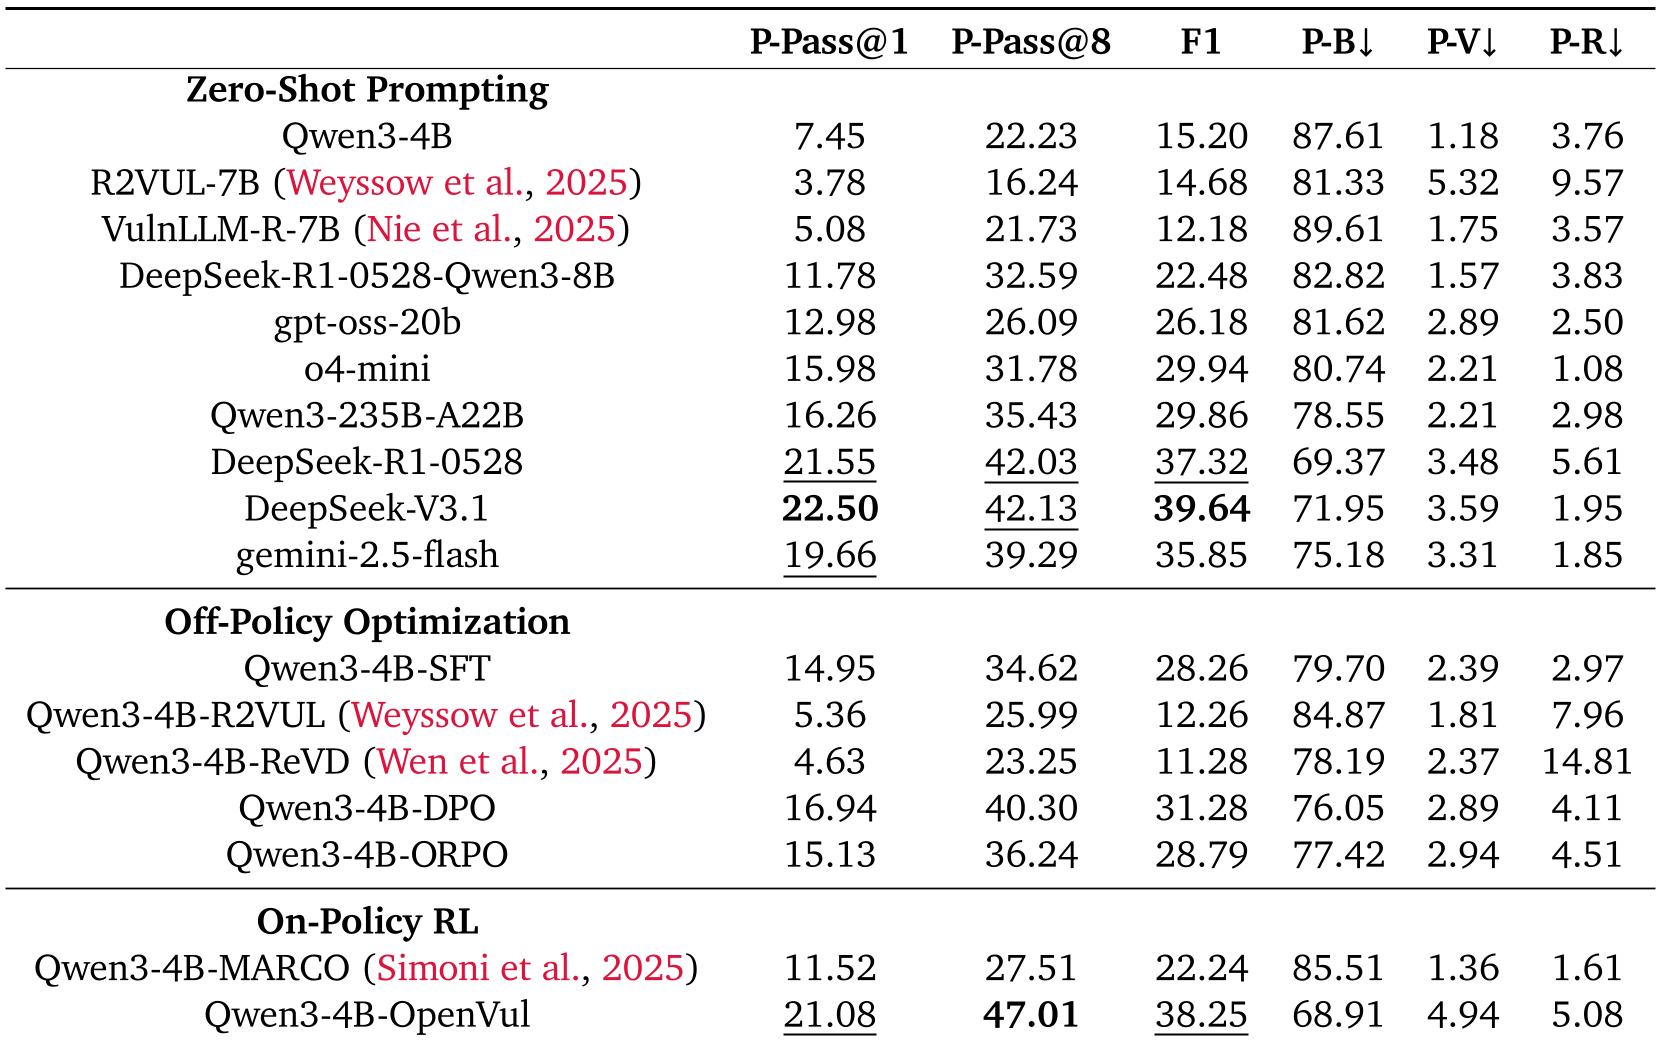
- 越级挑战:Qwen3-4B-OpenVul 在 P-Pass@1 上达到了 21.08,不仅远超专门的 VD 模型(如 R2VUL, ReVD),还击败了 Qwen3-235B 大模型。
- 推理深度:通过 P-Pass@8 的大幅提升可以看出,RL 激发了模型的自我探索能力,使其能从多个维度寻找潜在漏洞。
深度洞察:给开发者的三条金律
- 不要过度 SFT:研究发现,极致的 SFT 会抑制模型的探索欲,导致随后的 RL 训练效果变差。保持模型的“好奇心”对复杂任务很重要。
- 远离二元奖励:在安全领域,瞎猫碰死耗子的概率很高。如果只用对错标签做 Reward,模型会学会“猜标签”的 Reward Hacking 技巧。
- 重新定义评估:传统的 Binary Matching 会虚标模型能力。真正的 VD 评估必须深入到“逻辑链”层面。
结论与展望
OpenVul 的开源为安全社区提供了一个标准化基准。它证明了:在专业垂直领域,精细化的在线 RL 路径比单纯堆参数量更具性价比。 未来的安全 LLM 将不再只是一个简单的分类器,而是能够真正理解漏洞成因并给出修复建议的“数字安全专家”。
OpenVul 代码仓库已开源:https://github.com/youpengl/OpenVul