
FutureSim:在真实世界演进中重炼 AI Agent 的“预言”与适应力
FutureSim: Replaying World Events to Evaluate Adaptive Agents
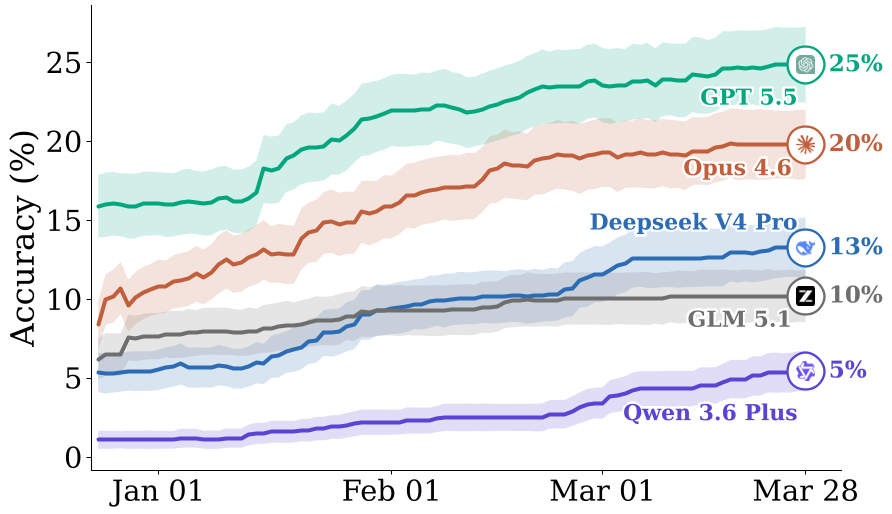
本文推出了 FutureSim,这是一个通过重放真实世界事件流来评估 AI Agent 长期适应能力的基准测试。该环境模拟了从 2026 年 1 月至 3 月的真实新闻演进,Agent 需在不断变化的上下文中对复杂世界事件做出预测,GPT 5.5 在此任务中以 25% 的准确率位居榜首。
TL;DR
AI Agent 是否真的具备像人类专家那样的适应性?本文提出了 FutureSim,一个基于真实世界时间轴(2026年Q1)重放的新型基准测试。它要求 Agent 在完全陌生的新闻流中,通过每日搜索、记忆更新,对长达三个月的全球事件做出精准预测。实验揭示了一个残酷的现实:即便是顶级模型,在面对动态演变的世界时,其适应效率与概率校准度仍有巨大提升空间。
背景定位:从“静态考卷”到“动态战场”
目前的 Agent 评测(如 GAIA 或 SWE-bench)大多是静态的:问题是死的,知识库是封存的。但在真实经济场景中,Agent 必须处理**随时间偏移(Distribution Shift)**的信息。FutureSim 的出现填补了这一空白,它通过“预测未来”这一极具挑战的任务,迫使 Agent 走出训练语境的“舒适区”,进入一个知识截止日期后的“黑盒”环境中进行存量知识与增量信息的博弈。
痛点与动机:为什么 Agent 总是“自以为是”?
作者指出,现有模型在面对新信息时存在两个核心局限:
- 锚定效应 (Anchoring Effect):一旦产生初始判断,即便后续有反向证据,Agent 也难以修正先前的错误预测(见下文消融实验)。
- 缺乏校准 (Calibration Loss):模型往往对错误答案过度自信。在多月跨度的预测中,如果不能合理分配概率分布,模型的 BSS 分数甚至会低于“完全弃权”。
方法论详解:FutureSim 的环境设计
FutureSim 并不提供标准化的多选题,而是采用自由格式预测(Free-form Forecasting)。
1. 架构流程
- Tasks (任务态):Agent 需对 330 个真实世界问题(如“谁将成为尼泊尔总理?”)提交概率分布。
- Context (上下文态):基于 CCNews 每日更新数千篇真实新闻。为了防止信息泄露,环境严格沙箱化,禁止访问外部实时互联网,仅开放截止到当前模拟日期的语料。
- Actions (动作集):仅有两个动作 ——
submit_forecast()和next_day()。这赋予了模型极大的自由度来决定何时搜索、何时反思、何时更新预测。
2. 数学核心:Brier Skill Score (BSS)
不同于传统的 Accuracy,BSS 惩罚了“错误的自信”。 这意味着,如果一个 Agent 将 100% 的概率分配给错误选项,它将得到 -1 的惨烈分数,这比什么都不做的 0 分更糟糕。
实验与结果:能力的阶梯化差距
推理深度决定预测精度
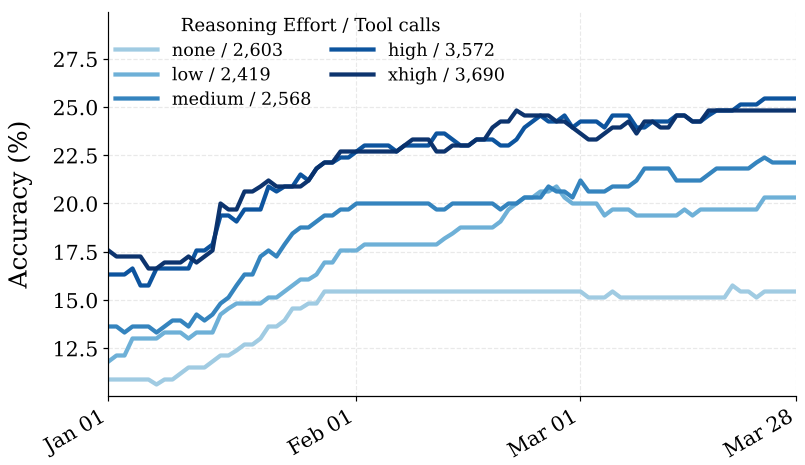
通过对 GPT 5.5 进行五个等级的推理努力度(Reasoning Effort)测试,作者发现随着 Inference Compute 的增加,准确率呈现出清晰的上升曲线。这印证了当前“推理缩放定律”(Inference Scaling Laws)在复杂动态推理中的有效性。
关键发现:
- GPT 5.5 遥遥领先:它是唯一能在初始阶段和演进阶段都保持高水平校准度的模型。
- Harness 的魔力:通过引入自定义的 Harness(增加结构化记忆工具、强制总结阶段等),DeepSeek V4 Pro 和 Qwen 3.6 Plus 等开源模型的 BSS 得分从负数转为正数。这说明并非模型完全没有能力,而是其内部的原生 Harness 无法有效驱动长期记忆。
- 记忆与搜索的必要性:消融实验显示,剥离记忆能力会导致性能大幅滑坡。Agent 需要利用记忆来抵御搜索结果中的噪声(Stale Evidence),防止其“随波逐流”。
深度洞察与总结
1. 适应性的局限
论文中最令人深思的实验是 固定起点实验:如果强行让 GPT 5.5 从一个错误的初始预测(Qwen 的预测)开始运行,即便是强大的 GPT 5.5 也难以完全扭转乾坤达到其最佳水平。这揭示了当前 Agent 在长程 Test-time Adaptation 上的脆弱性——它们极度依赖“先入为主”的第一印象。
2. 局限性分析
- 预测的静态性:FutureSim 目前关注的是“预测”而非“行动”。Agent 的决策不会改变新闻的走向,这虽然保证了可复现性(Reproducibility),但也避开了复杂的因果闭环。
- 数据依赖:基准测试的质量高度依赖于新闻语料的清洗和判题模型(Answer Matcher)的准确性。
3. 未来展望
FutureSim 为研究 Agent 的世界模型 (World Model) 提供了一面镜子。它向我们展示了:真正的智能不仅在于掌握已有的知识,更在于如何利用有限的搜索次数,在不确定的海洋中通过持续的贝叶斯式的信念更新(Bayesian Updating)来逼近真相。
Takeaway:未来的 Agent 优化方向不应仅仅是增加训练数据,更在于提升其在推理阶段的“纠错”与“概率对齐”能力。