
GAVEL:用图世界模型让长程 LLM 机器人规划可验证、可修复、可在线重排
GAVEL: Graph World Models for Verified and Efficient Long-Horizon LLM Task Planning
本文提出 GAVEL,一种围绕显式图世界模型展开的长程大语言模型机器人规划框架。它用图模型验证 LLM 生成计划、修复可由动作语义推出的错误,并在部分可观测多任务场景下维护对象位置分布以在线重排任务。在 BEHAVIOR-1K 上,GAVEL 将 Qwen3-8B 的单任务成功率从 41.2% 提升到 91.8%,多任务成功率从 19.9% 提升到 92.6%。
核心速览
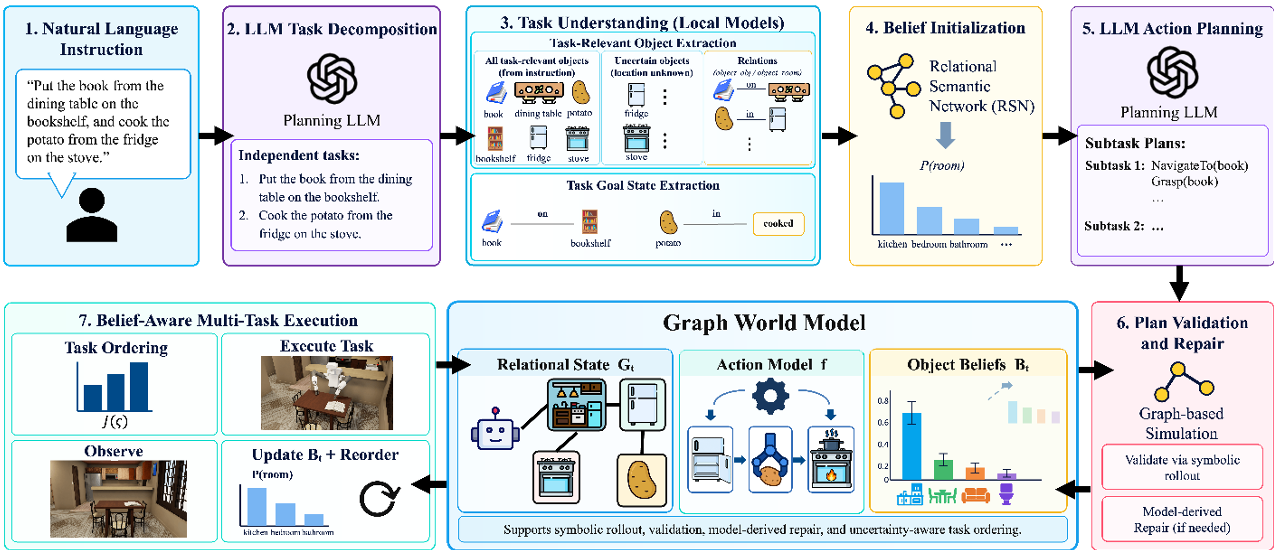
GAVEL 解决的不是“让 LLM 更会写计划”,而是“让 LLM 的计划在执行前可被检查、错误可被低成本修复、未知对象位置可被信念分布驱动地调度”。它将自然语言任务分解后交给 LLM 生成动作序列,同时用显式图世界模型模拟每个动作对对象关系、容器状态、电器状态和安全约束的影响。可模型自证的错误由图修复,真正需要语义推理的错误才反馈给 LLM;在多任务和部分可观测场景中,GAVEL 不将对象位置压缩为最可能房间,而是保留分布,并在每个任务完成后在线重排剩余任务。论文报告 Qwen3-8B 单任务成功率从 41.2% 提升到 91.8%,多任务成功率从 19.9% 提升到 92.6%,并通过分布信念与在线重排节省约 5.4% 的行驶距离。
这篇工作可定位为方法改进与实证评测结合的系统型论文。它不是单纯提出新基准,也不是纯理论结果,而是在 BEHAVIOR-1K 的家务场景上,将 LLM 规划、场景图验证、信念空间搜索和多任务排序连接成一个可评估闭环。与 SayPlan 相比,它的关键推进在于把验证后的失败分成“模型可修复”和“需要语义重规划”两类;与 EPoG 相比,它的关键推进在于不让图编辑独自生成复杂语义程序,而是保留 LLM 作为高层语义规划器。
问题与动机
LLM 作为具身任务规划器的失败并不是随机的。论文在 Introduction 中指出,生成计划可能遗漏前置动作、违反具身约束,或执行结束时仍未达到目标状态;而且规划 horizon 越长,失败率越高,小模型更明显。这里的关键失效机制是语言模型输出的是文本序列,而不是对物理状态转移的封闭推演。模型可能知道“打开冰箱再拿土豆”的常见顺序,却不一定能在每个动作前检查机器人是否已位于容器附近、是否已持有对象、容器是否打开、电器是否需要恢复关闭状态。
SayPlan 一类场景图方法采用 propose-and-check:用结构化环境模型符号执行候选计划,再把不可行动作返回 LLM 重试。这个思路提高了可靠性,但作者进一步追问:所有错误都必须回到 LLM 吗?论文给出直觉例子:如果抓取失败是因为距离不足,正确修复直接来自违反的前置条件,即先导航再抓取。如果错误来自目标未达成或安全约束缺失,而这些条件已经编码在图模型中,那么修复也可以由模型推出。把这类局部修复重新交给 LLM,不仅增加调用成本,还可能引入新的语言生成错误。
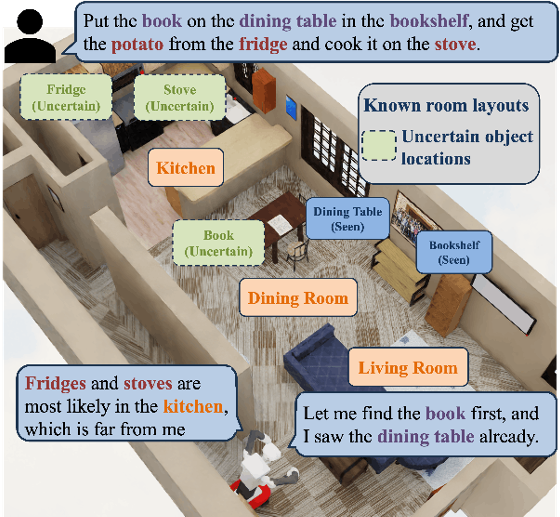
与此同时,部分可观测多任务调度暴露了另一类问题。机器人可能知道房间布局,却不知道任务对象在哪个房间。若每个子任务需要先搜索对象,那么当前子任务中的观察会更新其他对象的位置信念,进而改变后续任务顺序的成本。论文指出,将信念压缩为最可能结果并初始化时固定任务顺序,会浪费这类在线信息。GAVEL 的研究直觉由此形成:一个图模型既能验证动作是否适用,也能承载不确定性;前者决定执行可行性,后者决定执行效率。
核心章节
从场景图升级为可前向推演的世界模型
论文首先将环境表示为 typed scene graph。其出发点不是简单列出对象,而是用图来承载机器人可操作关系、状态标志和动作后果。文中给出:
其中 由房间集合、任务相关对象集合和机器人节点 组成, 表示空间与包含关系,例如接近、在下方、房间相连、对象在容器内、对象在支撑面上、机器人持有对象等, 保存一元状态标志,例如打开、已开启、已烹饪、已清洗、已干燥。这个式子在论证链中的作用是把“世界”形式化成可推理的结构:目标不是一段自然语言,而是图上必须满足的谓词集合。需要注意的是,论文区分真实物理状态 与机器人信念图 。当图只表示最可能状态时,它退化为普通符号世界模型;GAVEL 的贡献是把图同时用作信念载体,让未观测对象的位置不再被强行二值化。
动作层面,GAVEL 使用九类 grounded primitives,并为每个动作定义前提与效果。论文给出符号转移:
其中 由动作类型和参数组成, 检查四类可执行性:接近目标、对象支持该操作、夹爪状态满足、封闭容器已打开; 更新图上的关系和状态。这个式子是 GAVEL 的核心预测机制:在真实执行前,机器人先在 belief graph 上“模拟”动作序列,若某个动作前提不成立,rollout 就停止并产生结构化失败。若将 去掉,图只能记录静态关系,无法判断动作是否可在当前状态执行;若将 去掉,验证器只能检查起点,不能检查中间动作对目标和安全约束的影响。
把模型可证错误交给图修复,把语义错误交给 LLM
GAVEL 对任务计划做验证,判断标准同时包括目标达成与安全恢复。论文给出有效计划条件:
其中 是第 个子任务的部分图目标, 是 rollout 结束后的信念图, 返回未被满足的谓词集合, 是动作序列, 是 trace 级约束,例如打开过的容器必须关闭、开启过的安全关键电器必须关闭。这个条件的作用是定义“计划不是语法上可读,而是语义上可执行且可交付”。如果只检查动作前提而不检查 ,机器人可能执行了合法动作却没有完成任务;如果只检查目标而不检查 ,可能达成任务却留下危险状态。论文没有用单个损失函数优化这些约束,而是用符号验证把它们变成可修复的失败结构。
REPAIR 过程会递归应用可由动作模型推出的编辑。例如抓取失败缺接近性就插入导航,对象在封闭容器内就插入到容器的导航与开启,安全违规就插入恢复动作。当没有模型可派生的编辑时,验证结果才以结构化失败反馈给 LLM,且最多 次调用,论文示例中 可为 5。这里的关键设计是职责分离:图模型负责“动作语义决定的错误”,LLM 负责“需要重新组织高层语义程序的错误”。
为了处理修复不单调的问题,论文定义候选计划排名:
其中 是验证返回的结构化判定, 表示动作适用性, 表示执行成本,一元函数 将布尔条件转成 0 或 1,负号表示成本越低排名越高。这个 ranking 在论证链中的作用不是学习目标,而是搜索控制:因为编辑后的计划可能暂时变差,GAVEL 保留历史最佳候选;当编辑进入已访问集合 时停止,避免循环修复。若去掉 ranking 而只接受第一个无错计划,系统可能在局部编辑中振荡;若去掉 visited set,重复编辑会消耗时间而不改善质量。论文未给出 ranking 各字段权重的超参搜索,但从算法目标看,它是词典序式的结构约束优先于成本。
保留完整位置分布并用期望成本在线排序
部分可观测性在论文中体现为机器人知道房间布局,却不确定未观察对象位于哪个房间。GAVEL 为此维护信念:
其中 是对象 在房间 的概率, 是到 步为止的动作和观察历史。这个式子的作用是把“未知位置”从离散搜索问题变成成本估计问题。相比把对象压缩到最可能房间,保留 允许机器人在搜索中更新其他任务对象的不确定性。论文使用 Relational Semantic Network 初始化信念,但强调后续规划不丢弃完整分布。若观察发现对象,信念变局域化;若搜索某房间但未发现对象,该房间从支持集中剔除。边界条件是:这种信念只在房间粒度上成立,不覆盖对象在房间内的具体位姿,也不直接处理视觉遮挡。
对于未定位对象,论文进一步把信念转化为期望搜索成本。候选房间按 降序排列,若第 个房间找到对象,成本为:
其中 是房间之间的最短路径距离, 是房间搜索成本,论文用可通行面积除以传感器覆盖宽度近似, 表示检测到对象前平均搜索房间的比例。随后期望成本为:
其中 在可达房间上归一化概率。这个式子承上启下:它说明 GAVEL 为什么需要保留分布,因为搜索成本不是对象真实位置决定,而是由信念加权的路径和探索成本决定。若信念高度集中,期望成本接近 MAP 搜索;若信念分散,机器人会倾向优先执行能减少不确定性且顺路成本低的任务。论文给出实验证据,见后文表中的距离差异。
多任务执行顺序的评估进一步使用:
其中 是剩余任务的一个排列, 是从当前状态先执行任务 的期望成本, 是任务 在任务 后执行的期望成本。构造 和 需要 次 belief-conditioned rollout,论文说明实验中 不超过 5,因此可直接枚举所有排列并精确最小化 。这个式子的意义是把多任务顺序从 LLM 输出的一部分,变成图世界模型上的成本优化问题。若固定顺序,则无法利用任务间共享的位置不确定性;若为每个排列都做完整 rollout,则会显著增加计算,因此论文依赖 pairwise cost model 与高拟合度的距离预测来近似。
实验与证据
论文评测分为单任务、多任务部分可观测执行、模型缩放三类。实验设置中,单任务包含 100 个长程任务、10 个场景,参考计划平均 12.2 个 primitives,范围 8 到 17,共包含 240 个 goal predicates。多任务包含 500 条指令,每条有 2 到 5 个任务,平均 18.8 个 primitives、跨 4.66 个房间,其中 199 条需要电器产生语义状态。GAVEL 使用轻量 2-D executor 模拟 BEHAVIOR-1K 动作转移,保留 floor plan、对象属性、任务谓词和导航几何;导航用 A* 规划,未知对象用 frontier exploration 搜索。论文还报告所有 100 个单任务指令在 OmniGibson 上的成功结果与 executor 一致,而 executor 将单个计划评估时间从约 17 分钟降到约 1 秒,从而支撑 5500 次评估。
Table I 报告了单长任务规划中不同 LLM 与不同方法的成功率、平均尝试次数和规划时间:
| Model | Method | Success (%) | Average Attempt | Time (s) |
|---|---|---|---|---|
| Qwen3-4B | llm-only | 21.8 ± 1.5 | 1.00 ± 0.0 | 9.2 ± 1.0 |
| Qwen3-4B | sayplan | 55.4 ± 1.9 | 3.4 ± 1.7 | 27.6 ± 12.0 |
| Qwen3-4B | gavel-basic | 67.7 ± 1.6 | 1.00 ± 0.0 | 9.2 ± 1.0 |
| Qwen3-4B | gavel | 88.8 ± 1.6 | 1.7 ± 1.3 | 15.0 ± 11.1 |
| Qwen3-8B | llm-only | 41.2 ± 1.2 | 1.00 ± 0.0 | 13.3 ± 6.4 |
| Qwen3-8B | sayplan | 76.4 ± 1.5 | 2.7 ± 1.7 | 24.6 ± 15.8 |
| Qwen3-8B | gavel-basic | 76.2 ± 1.2 | 1.00 ± 0.0 | 13.5 ± 6.4 |
| Qwen3-8B | gavel | 91.8 ± 1.3 | 1.5 ± 1.1 | 15.5 ± 9.4 |
这组数字支持了核心主张。对 Qwen3-4B 而言,单纯 LLM-only 成功率只有 21.8%,而 gavel-basic 在不重新调用 LLM 的情况下达到 67.7%,说明相当一部分失败不是语义理解缺失,而是动作适用性不一致。SayPlan 风格反馈将成功率提高到 55.4%,但平均需要 3.4 次调用和 27.6 秒;GAVEL 用 1.7 次调用达到 88.8%,并把时间降到 15.0 秒。对 Qwen3-8B,gavel-basic 与 sayplan 接近,但完整 GAVEL 达到 91.8% 且平均只有 1.5 次调用,说明图修复与语义反馈的分工在小模型和更大模型上都有效。这里的拆解性证据是 gavel-basic 与 sayplan 的对照:前者隔离“无反馈的图修复”,后者隔离“有反馈但无图修复”。
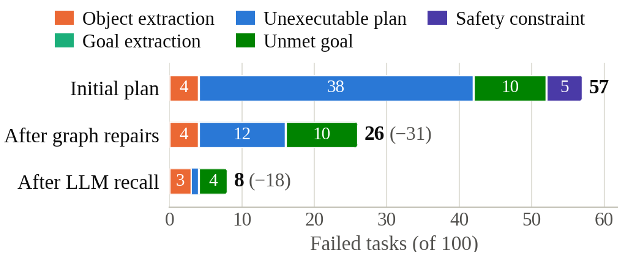
图 3 展示了 Qwen3-8B 下 GAVEL 失败在流水线各阶段被去除的情况。结合 Table I,可以更清楚地看到失败不是单一来源:一部分来自 LLM 初始生成,一部分来自验证与修复,剩余部分才进入 LLM replanning。论文未给出图 3 的精确数值刻度,因此不能从图中读出额外定量结论,但它作为定性诊断,支撑了“图模型先承担确定性修复”的设计。
Experiment 2 的多任务结果更直接考察分布信念和在线排序。下表报告成功率、行驶距离和规划时间:
| Method | Success (%) | Distance (m) | Time (s) |
|---|---|---|---|
| llm-only | 19.9 ± 0.7 | 86.69 ± 0.37 | 31.8 ± 10.5 |
| sayplan | 75.6 ± 2.1 | 83.01 ± 0.42 | 51.4 ± 27.6 |
| epog | 60.2 ± 0.0 | 84.51 ± 0.00 | 13.9 ± 3.9 |
| gavel-map | 92.6 ± 1.0 | 82.45 ± 0.23 | 39.3 ± 22.6 |
| gavel-static | 92.6 ± 1.0 | 79.69 ± 0.45 | 39.3 ± 22.6 |
| gavel | 92.6 ± 1.0 | 78.01 ± 0.71 | 39.3 ± 22.6 |
| oracle | 100.0 ± 0.0 | 56.17 ± 0.00 | — |
成功率方面,GAVEL 达到 92.6%,相比 LLM-only 的 19.9% 和 SayPlan 的 75.6% 有明显提升。距离方面,gavel-map 将每个不确定对象压缩到最可能房间并固定顺序,gavel-static 保留完整分布但仍固定顺序,gavel 在线重排。三者成功率相同,但距离从 82.45 米到 79.69 米再到 78.01 米,论文据此报告相比静态变体总节省约 4.45 米或 5.4%。这说明分布信念和在线重排主要改变执行成本而非任务可行性。EPoG 风格 baseline 达到 60.2%,失败集中于需要电器诱导语义状态的任务,论文说明这类任务要求推断“必须运行洗碗机”之类的程序,图状态差值本身无法表达。这反向验证了 GAVEL 保留 LLM 作为语义规划器的必要性。
Experiment 3 询问模型缩放是否能替代 GAVEL。下表报告 100 条多任务子集上的结果:
| Planner | LLM Only Success (%) | GAVEL Success (%) | LLM Only Time (s) | GAVEL Time (s) |
|---|---|---|---|---|
| Qwen3-4B | 2.4 ± 1.5 | 75.2 ± 2.1 | 23.0 ± 7.4 | 35.0 ± 31.2 |
| Qwen3-8B | 23.6 ± 1.5 | 89.2 ± 1.3 | 31.8 ± 10.5 | 39.3 ± 22.6 |
| GPT-5.6 Sol | 24.6 ± 3.9 | 99.2 ± 0.8 | 16.5 ± 3.9 | 16.5 ± 4.0 |
| Claude Sonnet 5 | 38.6 ± 2.2 | 99.4 ± 0.5 | 18.0 ± 4.4 | 18.2 ± 4.4 |
这组结果比单任务更清楚地说明 scaling 与 GAVEL 的互补关系。Qwen3-4B 单独使用几乎不可靠,只有 2.4% 成功率,但加上 GAVEL 达到 75.2%,甚至高于 GPT-5.6 Sol 单独使用的 24.6%。反过来,前沿模型单独使用也远未达到完美:GPT-5.6 Sol 为 24.6%,Claude Sonnet 5 为 38.6%。这说明即使模型能产生高层语义程序,长 horizon 下的动作适用性、安全恢复和跨任务执行成本仍需要显式世界模型处理。对前沿模型,GAVEL 的成本几乎可忽略:GPT-5.6 Sol 时间保持 16.5 秒,Claude Sonnet 5 从 18.0 秒变为 18.2 秒。因此,额外成本主要来自紧凑模型仍需更多 LLM 规划尝试,而非图验证和修复本身。
论文还报告了 belief 与 cost model 质量。RSN 在 11218 个对象放置、51 个场景、197 个对象类别、37 个房间类型上训练,达到 AUC 0.904 和 Brier score 0.057。但在 832 个 held-out queries 上,真实房间排名第一的比例只有 47%,说明 MAP 摘要会丢失大量信息,从而支持保留完整分布。成对成本模型与真实行驶距离高度相关,四任务和五任务指令的 分别为 0.93 和 0.89。这为 rollout 估计 和 提供了合理性:如果成本预测不可靠,在线排序可能引入不稳定调度。
深度洞察与总结
GAVEL 的主要贡献不是让 LLM 一次性生成完美计划,而是建立一条“语义生成、符号推演、模型修复、信念调度”的闭环。它的机制价值体现在三层:第一,用动作前提和效果把 LLM 输出从文本变成可执行前的状态模拟;第二,用 ranking 和结构化失败区分哪些错误可自动修复、哪些错误需要语义重规划;第三,用未观测对象的房间级分布把多任务顺序从预设 schedule 变成在线成本优化。论文实验对这三层都有对应证据:gavel-basic 证明图修复本身能提升小模型可靠性,Experiment 2 证明 LLM 语义与图编辑各有不可替代之处,Experiment 3 证明图世界模型与模型缩放互补。
局限也相对具体。首先,验证发生在 symbolic manipulation level,图能表达逻辑动作后果,但不能充分表达几何可达性、碰撞和抓取失败。论文在 Conclusion 中明确建议未来加入 motion-level reachability 和 collision constraints。其次,信念只在房间粒度上建模,不保留对象在房间内的具体位姿;RSN 初始化依赖房间类型先验,论文也未说明该先验是否能根据重复观察充分适应环境特定规律。第三,多任务 benchmark 假设任务目标对象集互不相交,因此任意顺序在 goal feasibility 上可接受,顺序主要影响成本;如果子任务共享中间对象或改变共同状态, 与 pairwise cost 的假设可能需要重新设计。最后,残差失败已从 planning 部分转移到 grounding:论文报告 Experiment 2 中 38 个 GAVEL 残差失败里,21 个来自对象抽取,5 个是不可执行计划,9 个是未达成目标。这说明下一瓶颈可能不是规划搜索,而是从自然语言到图谓词的映射质量。
从工程角度看,GAVEL 给出了一条在边端部署中很有价值的路线:与其等待更大模型完全内化具身约束,不如用显式世界模型承担可验证、可解释、可修复的中间层。未来如果将动作模型扩展到运动规划层,或将对象信念扩展到 pose-level 和 affordance-level,这一框架可能进一步连接高层任务规划与低层控制执行。