
Arbor:赋予 AI 持续研究能力——从孤立尝试到假设树的累积进化
Toward Generalist Autonomous Research via Hypothesis-Tree Refinement
本文提出了 Arbor,一个通用的自主研究(Autonomous Research)框架。它通过核心机制 Hypothesis-Tree Refinement (HTR) 将研究过程组织为持久的假设树,结合长期协作器(Coordinator)和短期执行器(Executor),在多项任务中达到测试集 SOTA。
TL;DR
在传统的自主 Agent 领域,我们不仅需要 Agent “动起来”,更需要它“记入脑子”。本文介绍的 Arbor 框架通过引入假设树细化(Hypothesis-Tree Refinement, HTR),将 AI 从一个只会写代码的“打字员”提升为能够管理复杂研究路线的“科学家”。它在 MLE-Bench Lite 上刷出了 86.36% 的惊人胜率。
背景定位:这是自主研究(Autonomous Research)领域的一项里程碑工作,它不仅关注任务完成率,更关注研究过程的逻辑一致性和长期记忆性。
1. 痛点:为什么 AI 搞科研总是“狗熊掰棒子”?
在目前的研究型 Agent 中,主要存在两个瓶颈:
- 状态丢失:长程任务中,Agent 的 Context 可能被大量零碎的工具调用记录填满,导致最初的研究目标和中间的失败教训被淹没。
- 缺乏分支管理:真实科研需要同时验证多个猜想。现有的 Agent 往往是单线性(Single-trajectory)工作,一旦某个猜想死掉,它很难优雅地回溯并利用失败的经验。
作者的直觉(Insight)是:科研的本质是假设的不断证伪与细化。因此,系统应该维护一个持久的、可审计的“假设树”,而不是杂乱的长对话。
2. 核心架构:Coordinator 与 Executor 的二元制
Arbor 采用了一种类似“导师-研究生”的架构:
- Coordinator(长期协作器):负责全局战略,盯着假设树,决定下一步该扩展哪个节点,哪个方向该减枝(Prune),哪个方向该合并(Merge)。
- Executor(短期执行器):负责当下的代码修改与实验运行。它在隔离的空间工作,完成后只返回结构化的结果和“洞察”。
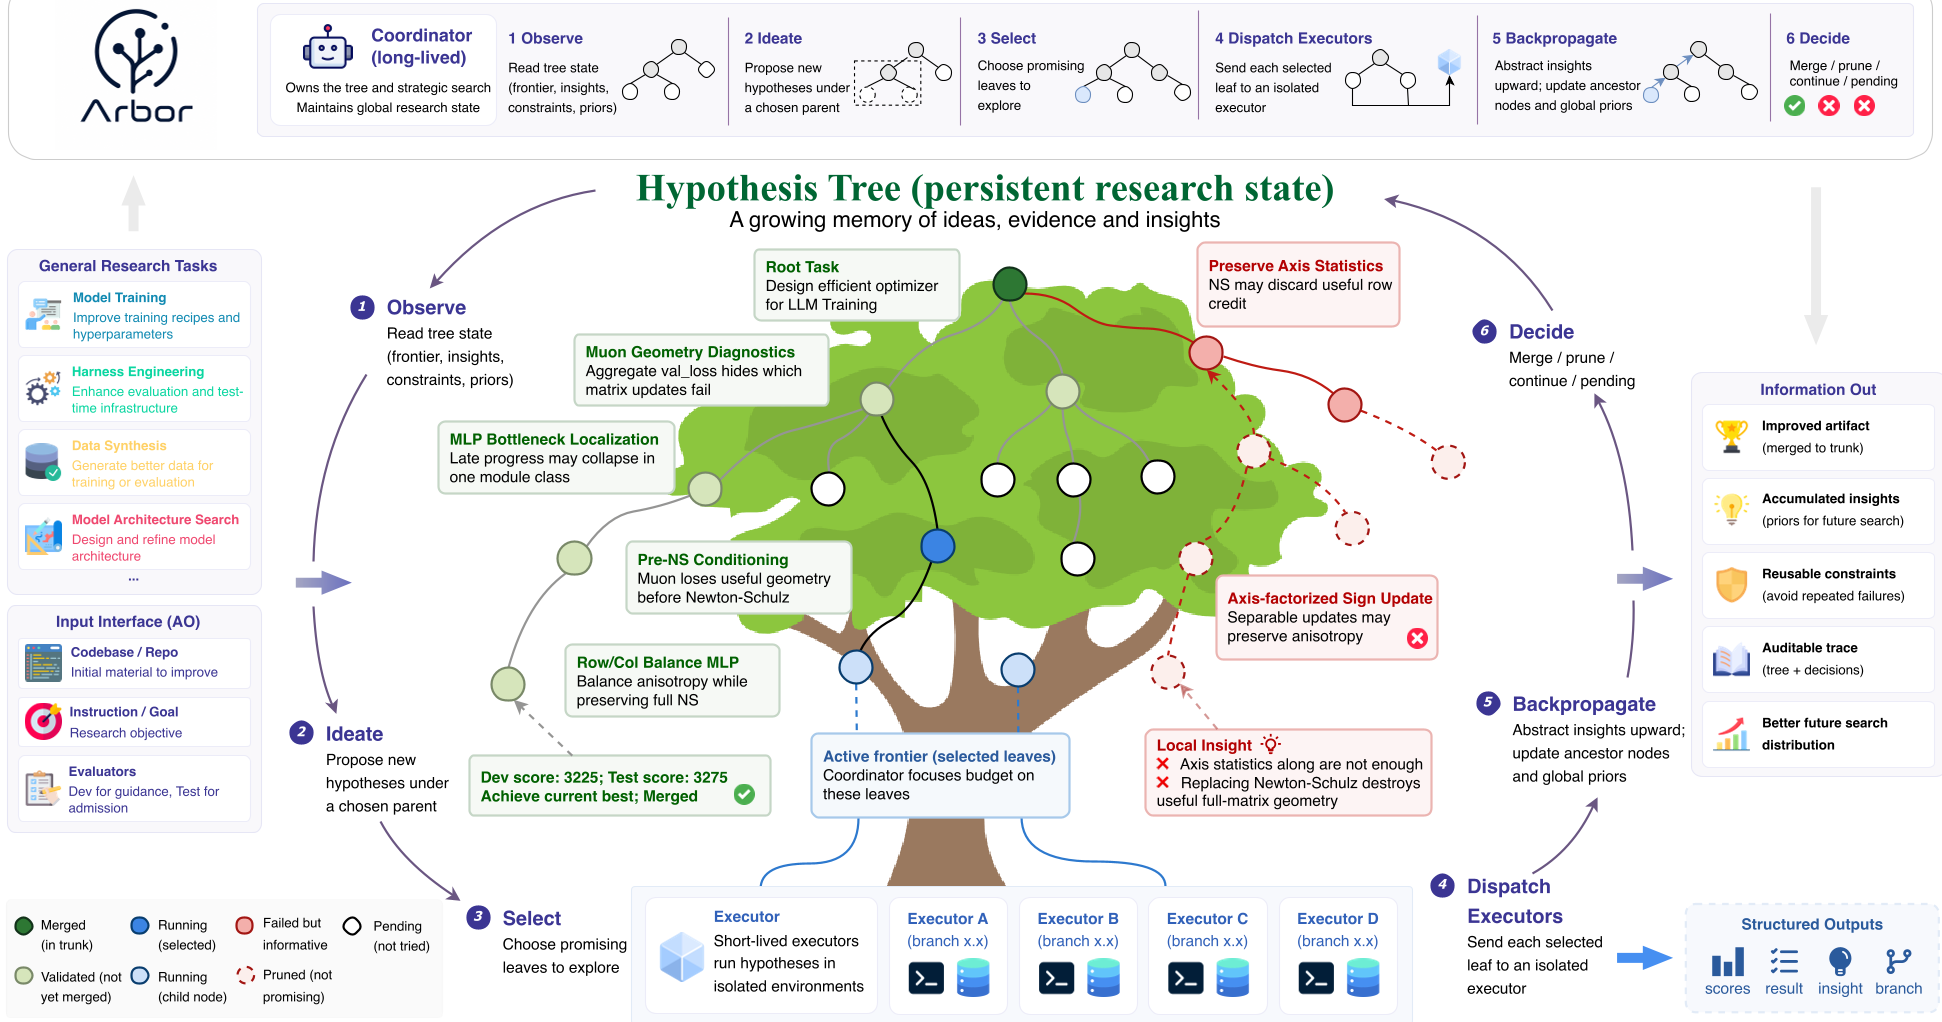 图 1: Arbor 整体框架,展示了假设树如何连接导师的策略与学生的执行。
假设树细化(HTR)的数学直觉
每个节点 可表示为一个元组:。
- :假设(可验证的主张)。
- :洞察(基于实验证据的经验总结)。
- :元数据(关联的代码 Commit、分数等)。
当一个叶子节点实验结束,洞察 会向上递归更新父节点,这个过程被称为 Backpropagation of Insights,确保了局部失败能转化为全局先验。
3. 持久的研究状态:Hypothesis Tree
与传统的搜索算法不同,Arbor 的树不仅是搜索空间,更是语义记忆堆栈。
- Observe: 协作器阅读当前的树结构。
- Ideate: 基于树中已有的验证/失败记录,提出新的子假设。
- Decide: 引入 Held-out Merge Gate(留出集验证门)。只有在开发集(Dev)上提升,且在完全独立的测试集(Test)上也提升的方案,才允许合并到主干。这极大地缓解了 Agent 的“过拟合”问题。
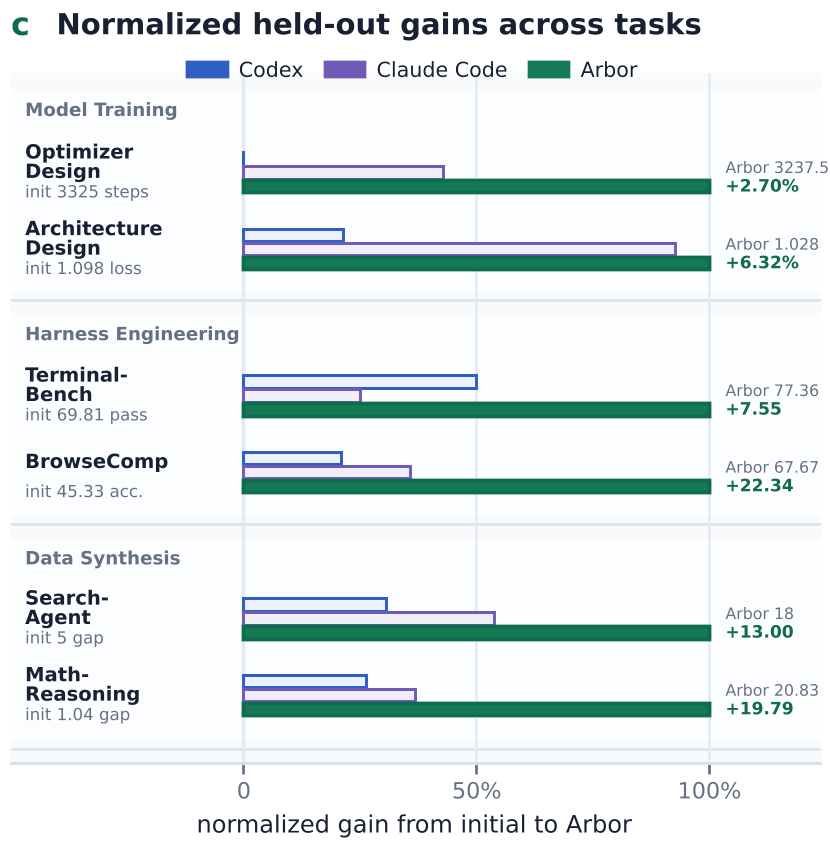 图 2: 一个关于数学合成想法的演化树。
4. 实验:碾压级表现
Arbor 在 Model Training(模型优化)、Harness Engineering(Agent 框架工程)和 Data Synthesis(数据合成)三个维度的 6 项任务中均取得了第一。
关键战绩:
- MLE-Bench Lite: 在这个公认的高难度 ML 工程基准测试中,Arbor 配合 GPT-5.5 拿到了 86.36% 的 Any Medal 比例,而在 Gold Medal(金牌)上表现尤为出色。
- 效率对比: 如图 3 所示,相比传统的 Codex 和 Claude Code,Arbor 在相同的 Token 预算下,由于其“假设-验证”的高效搜索,获得了更高的留出集收益。
 图 3: 在 6 项研究任务中,Arbor 与基线模型的性能对比。
消融实验发现
如果没有“假设树”结构(w/o tree),Agent 表现大幅下降;如果虽然有树但禁用了“洞察传播”(w/o insight feedback),表现甚至比没有树更差。这说明:科研 Agent 的价值不仅在于结构,更在于对经验的深层总结与复用。
5. 深度洞察与展望
解析科研进化的三个阶段
通过对 BrowseComp 等任务的分析,作者发现科研通常经历三个阶段:
- 初期:测试宏观机制是否成立。
- 中期:定位瓶颈,探寻机制边界。
- 后期:根据累积的约束(Constraints)生成高度定制的优化方案。
局限性分析
尽管表现卓越,Arbor 目前仍面临一些挑战:
- 目标单一性:目前主要针对单一标量指标进行优化,而真实科研往往是多目标的(性能、成本、安全性等)。
- 计算成本:虽然 Token 效率更高,但维护长程分支依然是一笔不小的开销。
总结
Arbor 的成功预示着 AI Research Agent 的一个新方向:从“暴力搜索代码”转向“系统化管理思维”。假设树不仅是数据的存储,更是 AI 自主逻辑的实体化。
Takeaway: 如果你正在开发复杂任务的 Agent,不要只关注它的 Tool-call,去为它建立一个可以不断回溯和吸收教训的“思想骨架”吧。