
走出标准英语的围城:用生成式 AI 构建全球英语教学新生态
Generative AI and English language teaching: A global Englishes perspective
本文探讨了如何通过提示工程(Prompt Engineering)和外部数据集成来优化 ChatGPT,以支持全球英语(Global Englishes, GE)背景下的英语教学(ELT)。研究提出了一个包含三种迭代模型(Basic, Refined 1, Refined 2)的框架,旨在打破生成式 AI 对标准英语规范的过度依赖,实现更具包容性的多语言教学。
TL;DR
生成式 AI(GenAI)正在重塑英语教学,但它也带来了一个隐匿的威胁:语言霸权。目前的 AI 模型往往默认遵循母语者规范(NES),而忽略了英语作为全球通用语的多样性。本文通过一项深度研究,展示了如何通过提示工程和语料库集成(RAG),将“刻板”的 ChatGPT 改造为能够理解韩国英语、芬兰英语等多元变体的全球英语(GE)教学助手。
痛点深挖:AI 的“语言偏见”与单色调教学
在全球化背景下,英语不再仅仅属于英美,而是属于全球数亿非母语使用者。然而,主流 LLM 的训练数据中,标准英语占据了统治地位。这导致了两个核心痛点:
- 算法标准化:AI 往往将具有地方特色的表达(如韩国习惯语 Borrowings)判定为“错误”。
- 身份抹杀:学习者在与 AI 互动时,被动地被修约为母语者的口吻,失去了本民族的文化印记和语言身份。
方法论:三阶段模型迭代
作者并没有试图从底层重训模型,而是通过“教师友好”的提示工程(Prompt Engineering)进行外围干预。
模型架构演进
研究设计了三个层次的模型进行对比对比:
- Basic Model:单步提示,完全依赖 AI 内部知识。
- Refined Model 1:多步提示。先让 AI 生成评估准则,再进行作业批改。
- Refined Model 2:这是最强大的版本,引入了 RAG (检索增强生成) 技术。它将真实的《Gachon 学习者语料库》和《ELFA 语料库》作为“外部大脑”,强制 AI 参考真实世界中的非母语者交流数据。
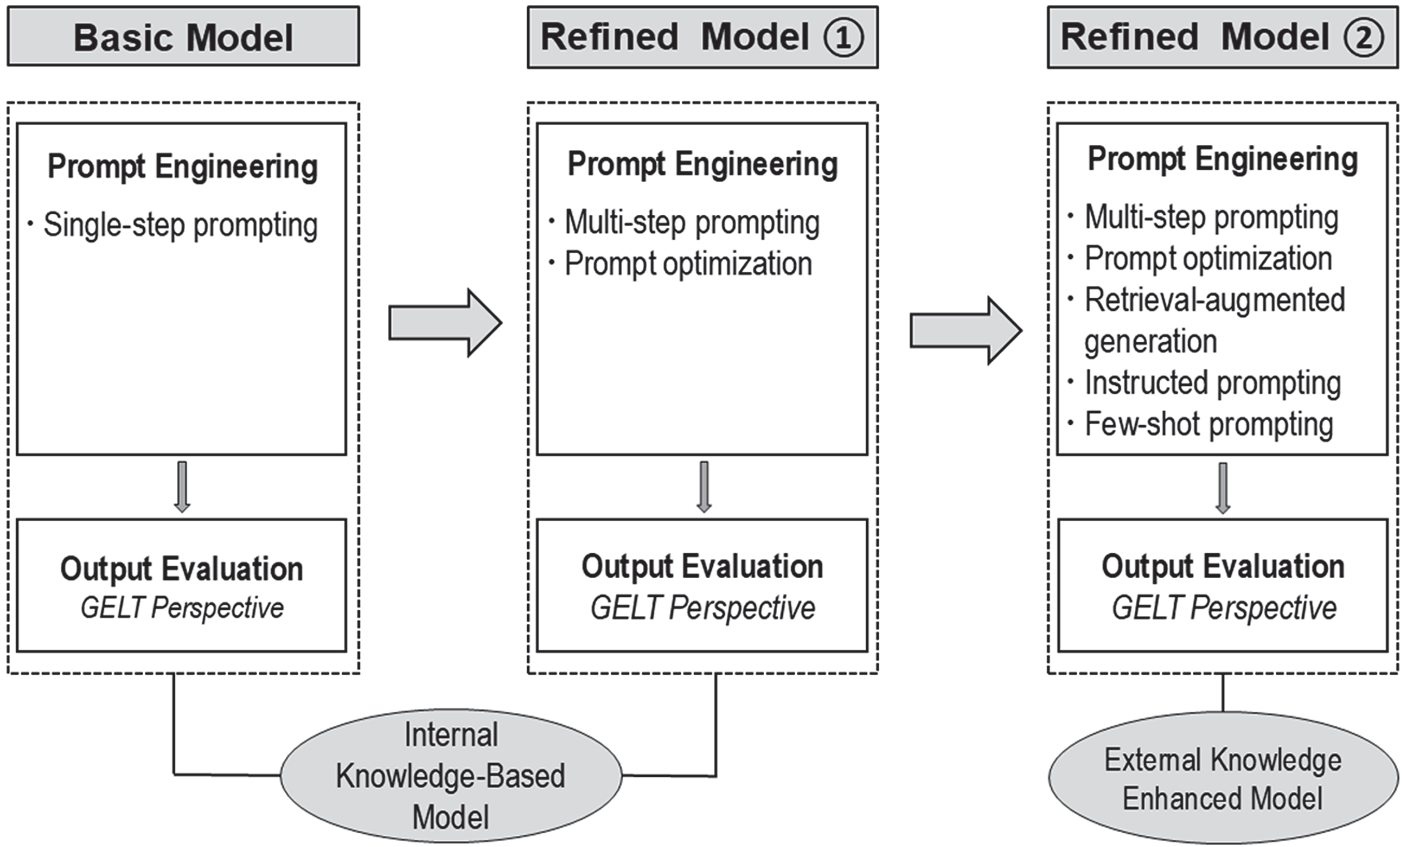 图 1:基于 DDR 方法的模型迭代架构,展示了从基础提示到数据增强的演进过程。
核心洞察:当 AI 开始理解“变体”
实验任务涵盖了内容策划、评估反馈和对话练习三个维度。
1. 突破判分歧视
在基础模型中,AI 会将 hand phone(韩国常用的手机表达)纠正为 mobile phone。但在 Refined Model 2 中,结合了 GE 评估准则后,AI 能够识别这种表达在特定文化背景下的地道性与交际有效性,不再一味纠错。
2. 模拟真实的 ELF 对话
真实的跨文化交际并非每个人都讲着完美的考尔德英语。Refined Model 2 通过集成 ELFA 语料库,在对话中模拟了芬兰英语的特征,如使用犹豫标记(Hesitation markers)和简化句法。
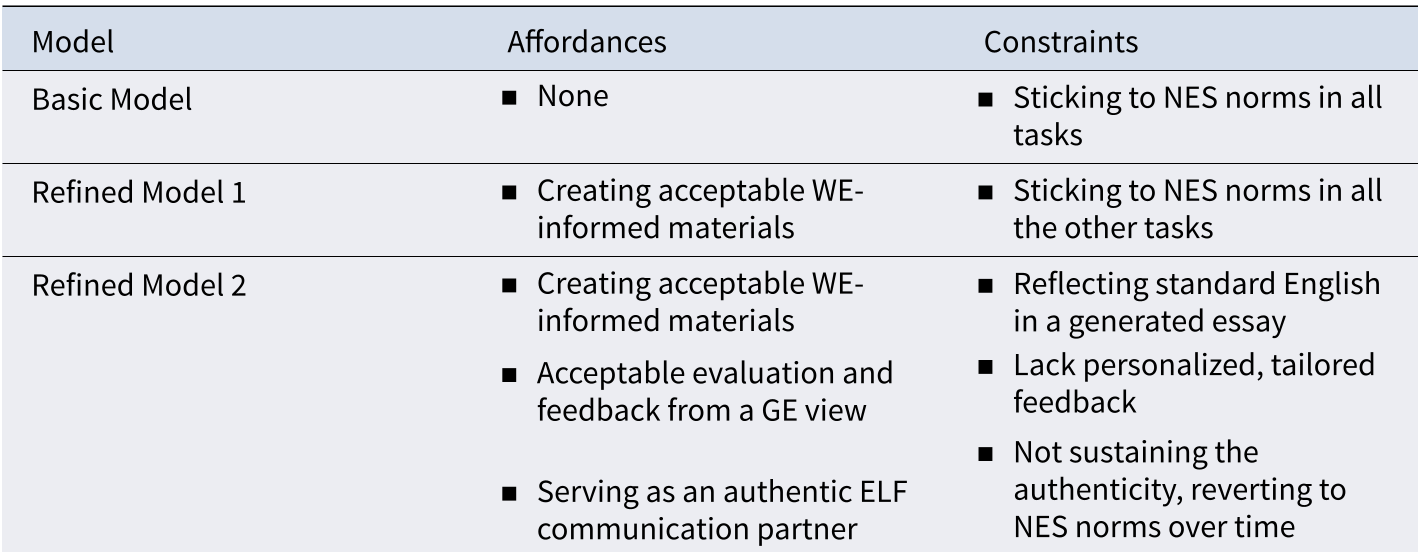 图 2:三种模型在 GE 教学任务中的表现对比。可以看到 Refined 2 在真实性和包容性上取得了质的飞跃。
实验总结与挑战
尽管 Refined 2 表现出色,但研究也发现了一个有趣的现象:AI 的“回归本能”。在长对话中,即便有外部数据干预,AI 的输出也会逐渐向标准英语“漂移”。这意味着 AI 内部的统计概率在长时间序列下仍倾向于主流规范。
深度思考:教师的能动性
本论文最重要的结论在于:GenAI 的成功不取决于算法,而取决于教师。
- 设计者角色:教师需要具备“提示工程”能力,通过多步指令引导 AI。
- 资源策展人:教师需要筛选像 ELFA 这样高质量的外部语料库来修正 AI 的偏见。
- 批判性评估:教师必须意识到 AI 的局限性,将其作为协作伙伴而非绝对权威。
总结
本文为 AI 时代的语言教学提供了一个极具价值的范式:通过技术手段(RAG + Prompting)赋能社会语言学理论(GELT)。它告诉我们,AI 可以成为通往语言多元主义的桥梁,前提是我们需要有一位懂得“调教” AI 的专业导师在旁指引。