
GCL:打破标签枷锁,实现真正的无监督视频异常检测
Generative Cooperative Learning for Unsupervised Video Anomaly Detection
本文提出了生成式协同学习 (Generative Cooperative Learning, GCL),这是一种用于视频异常检测的纯无监督框架。该方法通过生成器 (Generator) 和判别器 (Discriminator) 之间的交叉监督机制,在无需任何标签的情况下实现了 SOTA 性能,甚至超越了许多需预知正常样本的一类分类 (OCC) 方法。
TL;DR
传统的视频异常检测往往假设训练集是“纯净”的正常视频(One-Class Classification, OCC),但在现实中,海量的原始监控录像总是混杂着各种突发状况。本文提出的 Generative Cooperative Learning (GCL) 抛弃了所有标注依赖,通过生成器与判别器的“协同进化”,在混乱的无标注数据中精准锁定异常,性能不仅吊打同类无监督方法,甚至超越了需要“纯净数据”的 OCC 模型。
视角定位:这是该领域首个严谨探讨完全无监督模式(Fully Unsupervised Mode)的工作,成功将异常检测从“实验室预设”推向了“工业界自动部署”。
核心痛点:为什么“无监督”这么难?
在视频监控领域,获取标注不仅费时(需要看完几千小时视频),而且异常的定义极具主观性。
- OCC 的局限:一类分类器(如 Autoencoder)假设训练样本全是正常的。如果训练集里混进了一个爆炸镜头,模型也会学会重建它,导致测试时无法识别异常。
- 弱监督的成本:即便只给视频打“有/无异常”的标签,依然需要大量人工审查。
- 零标签挑战:在完全无标注的情况下,模型如何知道哪些是占绝大多数的“背景噪音(正常)”,哪些是极少数的“信号(异常)”?
方法论详解:G 与 D 的博弈与协同
GCL 架构的核心直觉在于利用异常事件的低频性。它由一个 Autoencoder (生成器 G) 和一个全连接分类器 (判别器 D) 组成。
1. 协同训练流程 (Iterative Cross-Supervision)
- G 产生伪标签推给 D:生成器计算重建误差,误差大的被标记为“疑似异常”。
- D 学习并精炼标签:判别器接受这些带有噪声的标签进行训练。由于分类器通常对随机噪音具有一定的抵抗力力,它能从 G 的“烂教案”中总结出更稳健的特征。
- D 产生伪标签反馈给 G:训练后的 D 对数据进行打分,告诉 G 哪些视频段绝对不能好好重建。
2. 负学习 (Negative Learning, NL)
这是本文的独创 Insight。作者不再是让生成器死磕“重建所有东西”,而是引入了 Pseudo Reconstruction Targets (PRT)。如果 D 认为某个样本是异常,G 就会被强迫将其重建为全 1 向量或高斯噪声。
- 直觉含义:既然异常不可预测,那我们就主动让它“扭曲”,从而在重建误差的空间里拉大正常与异常的间距。
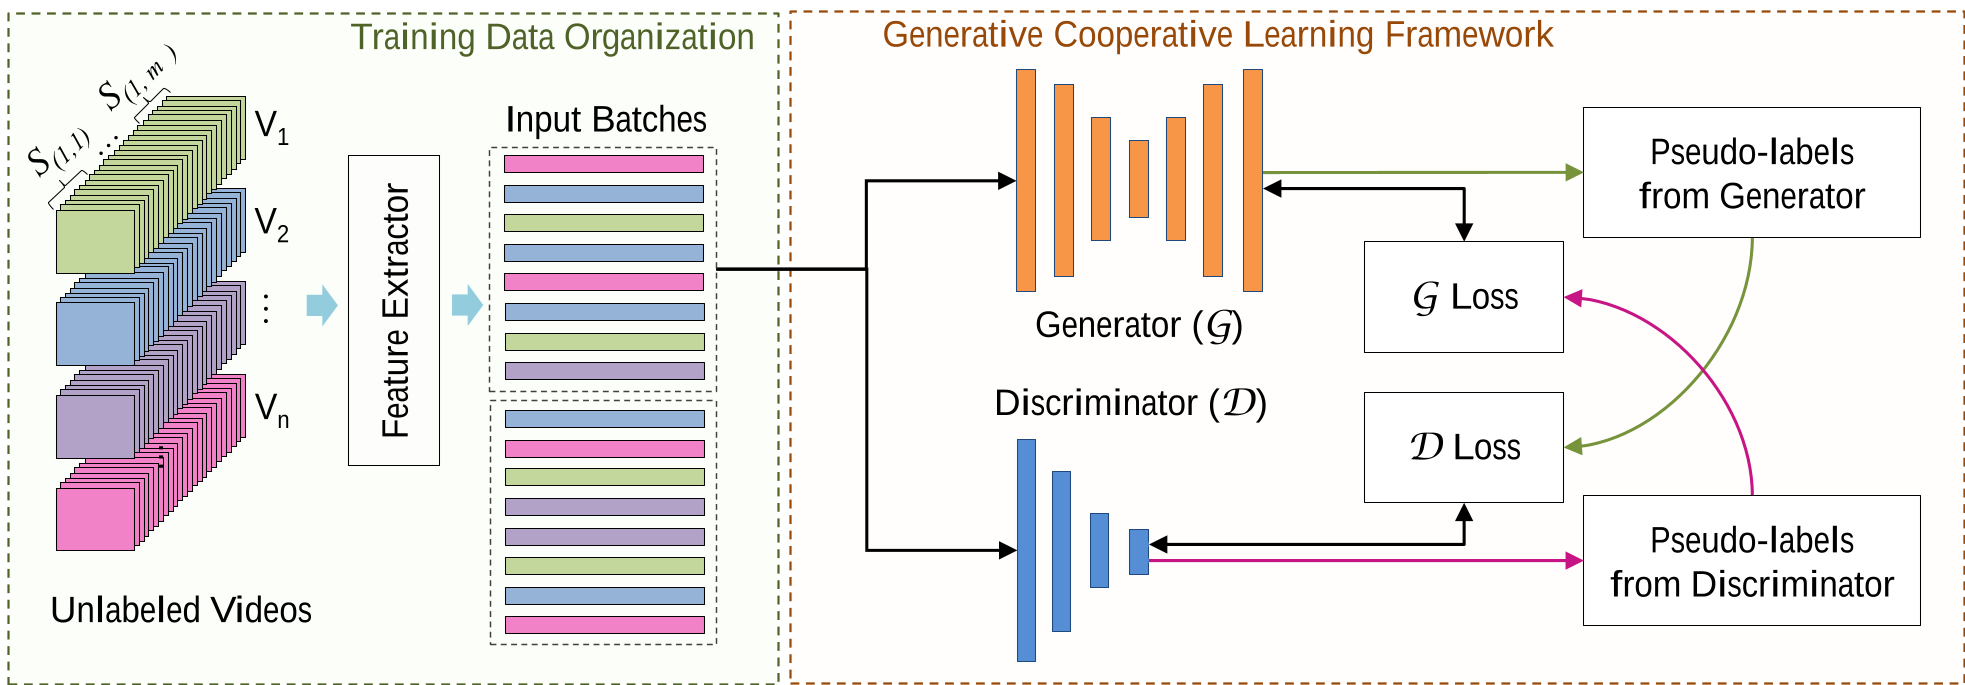 图 1:GCL 总体架构,展示了 G 与 D 之间的双向交叉监督机制。
实验与结果:无缝超越有监督方法
作者在 UCF-Crime 和 ShanghaiTech 两个重量级数据集上进行了验证。
- 关键战绩:在 UCF-Crime 上,GCLP (带预训练版本) 达到了 71.04% AUC。相比之下,传统的 AEAllData(直接用所有数据训练 AE)只有 56.32%。
- 越级打击:值得注意的是,GCL 在不使用任何标签的情况下,性能超过了诸如 MemAE 等经典 OCC 方法,说明协同学习挖掘出的边界比单纯学习正样本更具辨别力。
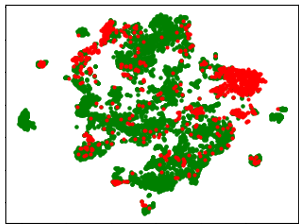 图 2:消融实验显示,采用 "Ones" 负学习目标的 G 和 D 收敛速度最快且性能最稳。
此外,t-SNE 可视化(图 6,详见原文)清晰地显示,在加入 Negative Learning 后,异常样本的特征被成功推离了正常样本簇,形成了明显的孤岛。
深度洞察:为什么这行得通?
- 互补性:生成器擅长捕捉全局分布,但容易“泛化”到异常;判别器擅长分类,但需要标签。两者相遇,G 提供了初始信号,D 过滤了信号中的噪声。
- 伪标签阈值策略:作者并没有使用静态阈值,而是根据每批次误差的均值和标准差动态调整,这适配了视频数据的流式特征。
- 时间一致性:预训练阶段利用相邻帧的差值进行简单过滤,虽然粗糙,但为后续的协同迭代提供了一个良好的“启动点(Jump-start)”。
总结与局限
GCL 的成功标志着视频异常检测可以进入高度自动化阶段。 局限性:该方法依然依赖于“异常是少数派”这个假设。如果在训练数据中,某种异常(如由于摄像头故障导致的雪花屏)频繁出现,GCL 可能会将其误判为正常。
展望未来,将这种协同学习机制与当前火爆的 多模态大模型 (MLLM) 结合,利用语言的逻辑先验来辅助判别器清理伪标签,将是一个极具潜力的研究方向。