
生成式推荐真的更擅长泛化吗?揭秘 Token 级记忆的底层逻辑
How Well Does Generative Recommendation Generalize?
本文系统研究了生成式推荐(GR)模型对比传统 ID 推荐模型的泛化能力,提出了基于“项目转移路径”的评测框架。研究发现 GR 模型在需要泛化的场景下表现占优,而 ID 模型在记忆场景下更强,且 GR 的泛化本质上源于 Token 级的记忆。
TL;DR
生成式推荐(Generative Recommendation, GR)在近年来大火,其核心优势被归结为“泛化能力强”。然而,CMU、UCSD 和 Meta 的最新研究给出了更深刻的答案:GR 确实更擅长处理未见的转移路径(泛化),但在处理已见路径(记忆)时反而不如传统的 SASRec 等 ID 模型。 更本质的是,GR 表现出的所谓“泛化”,其实是由于其在更细粒度的 Token 级别进行了极致的记忆。
背景定位
这篇文章在推荐系统领域坐标系中属于深度诊断与理论建模之作。它没有单纯刷榜,而是通过实验拆解了基于语义 ID(Semantic ID)的 GR 模型(如 TIGER)与基于唯一 ID 的常规模型(如 SASRec)的行为差异,并给出了一个极具启发性的结论:泛化与记忆并非对立,而是观察粒度的问题。
痛点深挖:泛化还是记忆?
传统的推荐系统将每个项目视为独立的 ID,逻辑简单但缺乏语义关联。GR 模型将项目拆解成 Token 序列(如 [12, 45, 8]),天然具有层次结构。
作者发现,现有的评估方式无法区分模型到底是靠“死记硬背”训练集中的路径中奖的,还是靠“举一反三”推理出来的。为此,作者定义了项目转移(Item Transition):
- 记忆(Memorization):目标转移路径
[A -> B]在训练集中出现过。 - 泛化(Generalization):路径没见过,但可以通过对称性、传递性(
A->C, C->B)推导出来。
方法论详解:从项目泛化到 Token 记忆
为了揭示 GR 的魔力,作者通过一个精妙的实验视角切换,将分析从项目级下沉到了 Token 级。
1. 架构解析:语义 ID 的本质
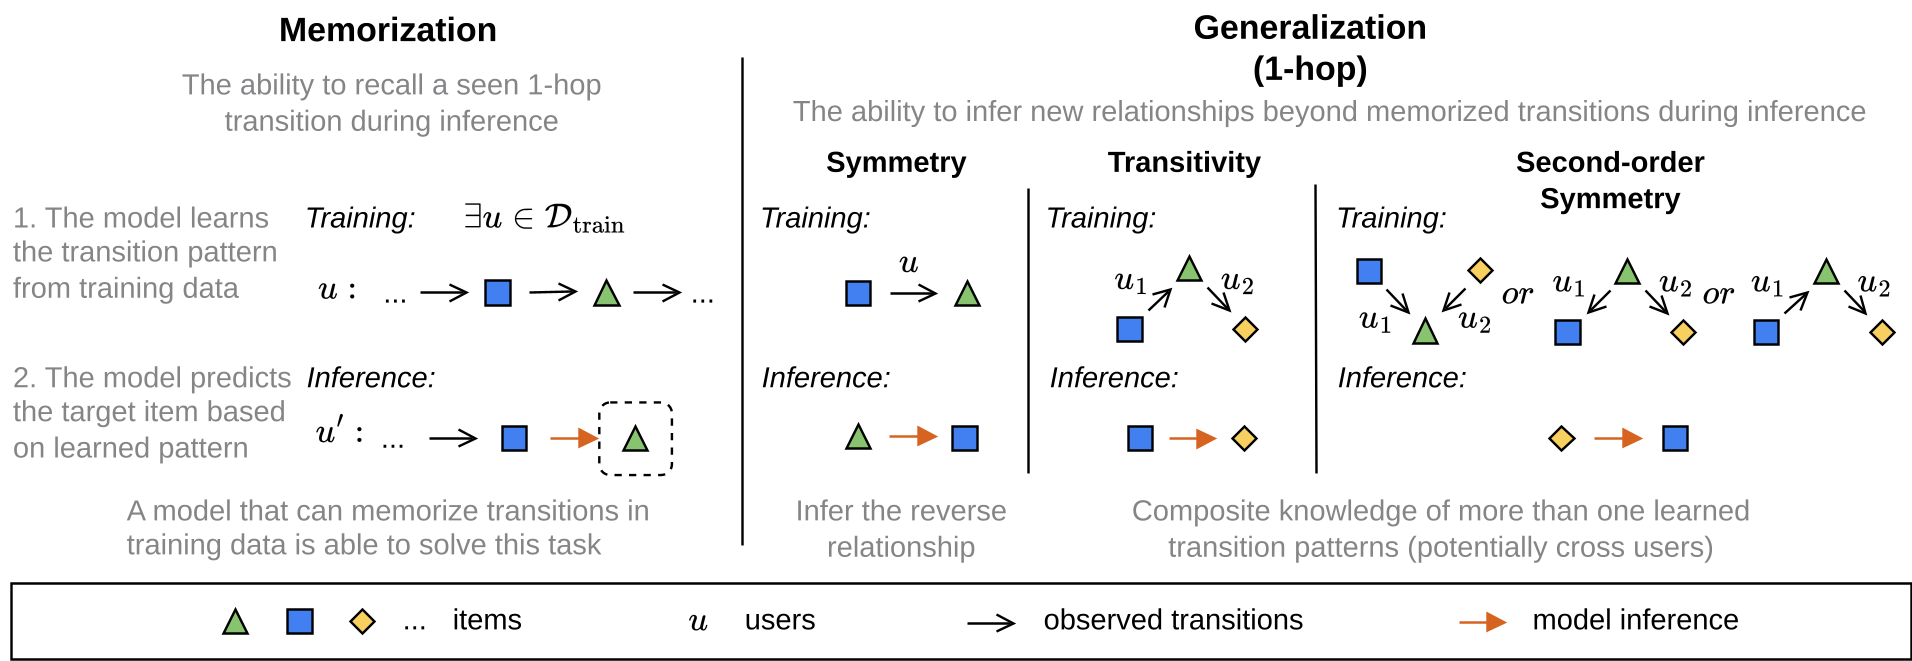 (图 1:记忆与不同子类泛化的定义,基于训练集中观测到的模式)
2. 核心直觉:Token 级前缀记忆
作者提出了 Prefix N-Gram Memorization。对于 GR 模型来说,即使项目 A -> B 的转移没见过,但如果 A 的前缀 Token 和 B 的前缀 Token 在训练集其他项目的组合中出现过,模型就能预测。
深度洞察: 这意味着 GR 模型的“泛化”实际上是在语义空间内,利用大量共享的 Token 前缀进行“重组式记忆”。这种机制让 GR 在处理长尾、冷启动转移时异常强大,但也导致其在处理特定的、唯一的 ID 对应关系时,由于 Token 共享产生了**“稀释效应(Dilution Effect)”**,导致记忆准确度下降。
实验与结果:证据确凿
作者在 Sports, Beauty, Steam 等 7 个数据集上横跳对比,结果非常直观:
- SASRec (ID模型):在记忆型任务上王者,但在需要多跳推理(Transitivity)的情况下性能断崖式下跌。
- TIGER (GR模型):泛化得分极高,尤其是在跳数(Hop)增加时,鲁棒性远超 ID 模型。
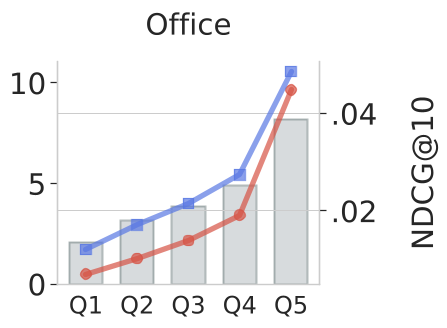 (图 8:利用 MSP 指标观察到的性能交叉现象。当置信度高时,SASRec 更强;低时,TIGER 占优。)
这种洞察有什么商业价值?
既然两者优劣互补,作者提出了自适应集成(Memorization-Aware Adaptive Ensemble)。
- 逻辑:利用 ID 模型的预测置信度(MSP)作为切换开关。
- 效果:如果 ID 模型很笃定(置信度高),说明大概率是记忆场景,赋予其更高权重;反之则信任 GR 模型的泛化能力。实验证明,这种简单的动态加权就达成了 SOTA 性能。
总结与局限性
Takeaway: 生成式推荐不是万灵药。它的强项在于通过语义 Token 的细粒度记忆实现对未见组合的精准预测,但在需要“死记硬背”特定规律的场景下,它可能会受困于词表的冲突。
局限性: 目前的 Token 级记忆分析仅基于固定的语义 ID 编码。如果未来的编码器(Tokenizer)是全动态、端到端学习的,这种“记忆变泛化”的界限可能会更加模糊,值得进一步探索。
作者预测: 未来的推荐系统架构将不再是纯 ID 或纯 Generative,而是一个能自动感知当前样本“难度”和“新颖度”的混合专家系统。