
GRAM:让递归推理从确定性走向生成式演化
Generative Recursive Reasoning
本文提出了生成式递归推理模型 (GRAM),这是一个将递归推理(RRM)转化为概率生成过程的框架。通过引入随机潜变量轨迹和摊销变分推理 (Amortized Variational Inference),GRAM 在 Sudoku-Extreme 和 ARC-AGI 等任务上超越了确定性递归基准(如 HRM, TRM),实现了 SOTA 性能。
1. 核心速览
TL;DR:传统的递归推理模型(RRMs)像是在一条漆黑的窄路上摸黑前行,一旦选错方向便无法回头。本文提出的 GRAM (Generative Recursive reAsoning Models) 为这条路打开了无数个平行宇宙:它通过将递归过程转变为随机概率轨迹,让模型能够同时探索多种推理假设。
背景定位:在当前 AI 热衷于通过增加参数量(Scaling Law)或拉长思路由(CoT)来提升性能的背景下,GRAM 另辟蹊径,探索了“计算组织形式”的变革。它证明了:一个更小(10M 参数)但具备生成式能力的递归模型,能打败更大、更深的确定性模型。
2. 痛点:确定性递归的“死胡同”
现有的递归架构(如 Looped Transformer, HRM, TRM)虽然能通过共享权重反复迭代来节省参数,但它们本质上是确定性系统。
- 单向性陷阱:一旦初始推理出现偏差,后续的“精炼(Refinement)”往往只是在错误的方向上越走越远。
- 模式坍缩:对于像 N-Queens 或图着色这样存在多个合法解的问题,确定性模型只能给出一个解,无法感知解空间的多样性。
3. 方法论:Stochastic Guidance(随机引导)
GRAM 的核心直觉是:推理即采样。
3.1 架构拆解
作者引入了一个分层递归结构(Hierarchical Instantiation):
- 低层 (Low-level):负责细粒度的确定性计算。
- 高层 (High-level):负责抽象推理状态的更新,并在此处引入随机引导 。
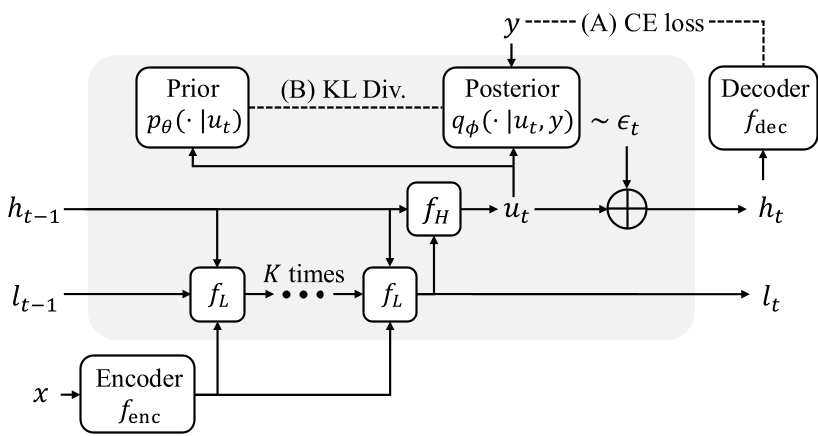
数学上,每一步的潜状态 不再是计算得出的死值,而是从一个高斯分布中采样出的: 这里的 确保了推理的方向性,而 则提供了探索的厚度。
3.2 变分训练与推理扩展
GRAM 使用摊销变分推理 (Amortized Variational Inference) 进行训练。在推理阶段,它支持两个维度的 Scaling:
- 深度 (Depth):增加循环次数(类似 CoT)。
- 宽度 (Width):并行采样 条轨迹,通过 LPRM (潜过程奖励模型) 挑选分数最高的解。
4. 实验:当推理拥有了“想象力”
4.1 复杂逻辑攻克
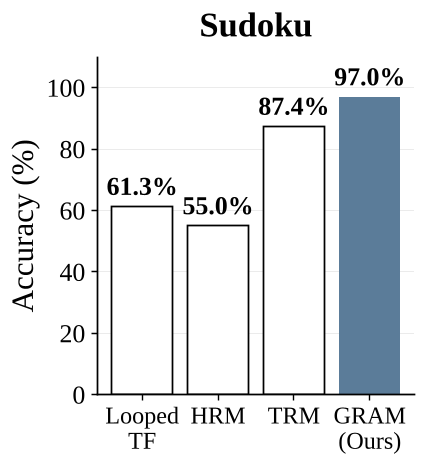
在极其困难的 Sudoku-Extreme 和 ARC-AGI 任务中,GRAM 表现出了显著的优越性。尤其是在推理预算相同的情况下,GRAM 的“宽度扩展”比单纯刷迭代次数(深度)更有效。
4.2 多解空间覆盖
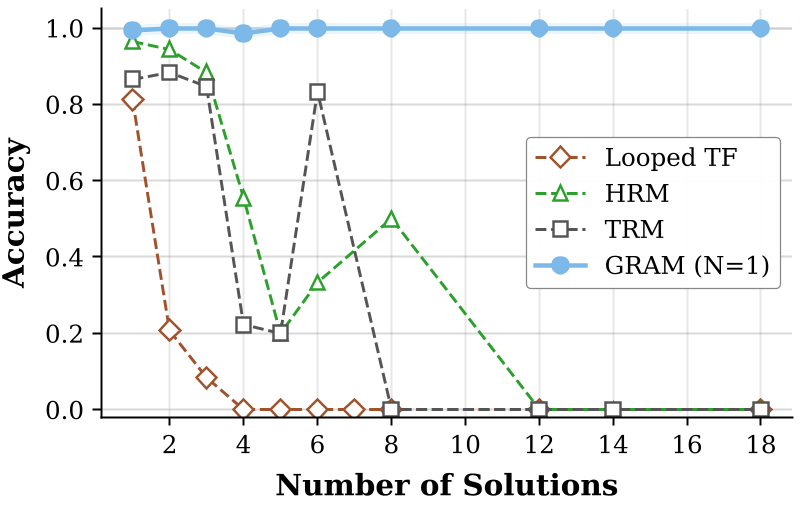
在 N-Queens 任务中,随着可行解数量的增加,确定性基准模型(TRM/HRM)的准确率发生断崖式下跌,而 GRAM 凭借其生成式特性,维持了稳定的高准确率和极高的解覆盖率度。
5. 深度洞察:推理的物理轨迹
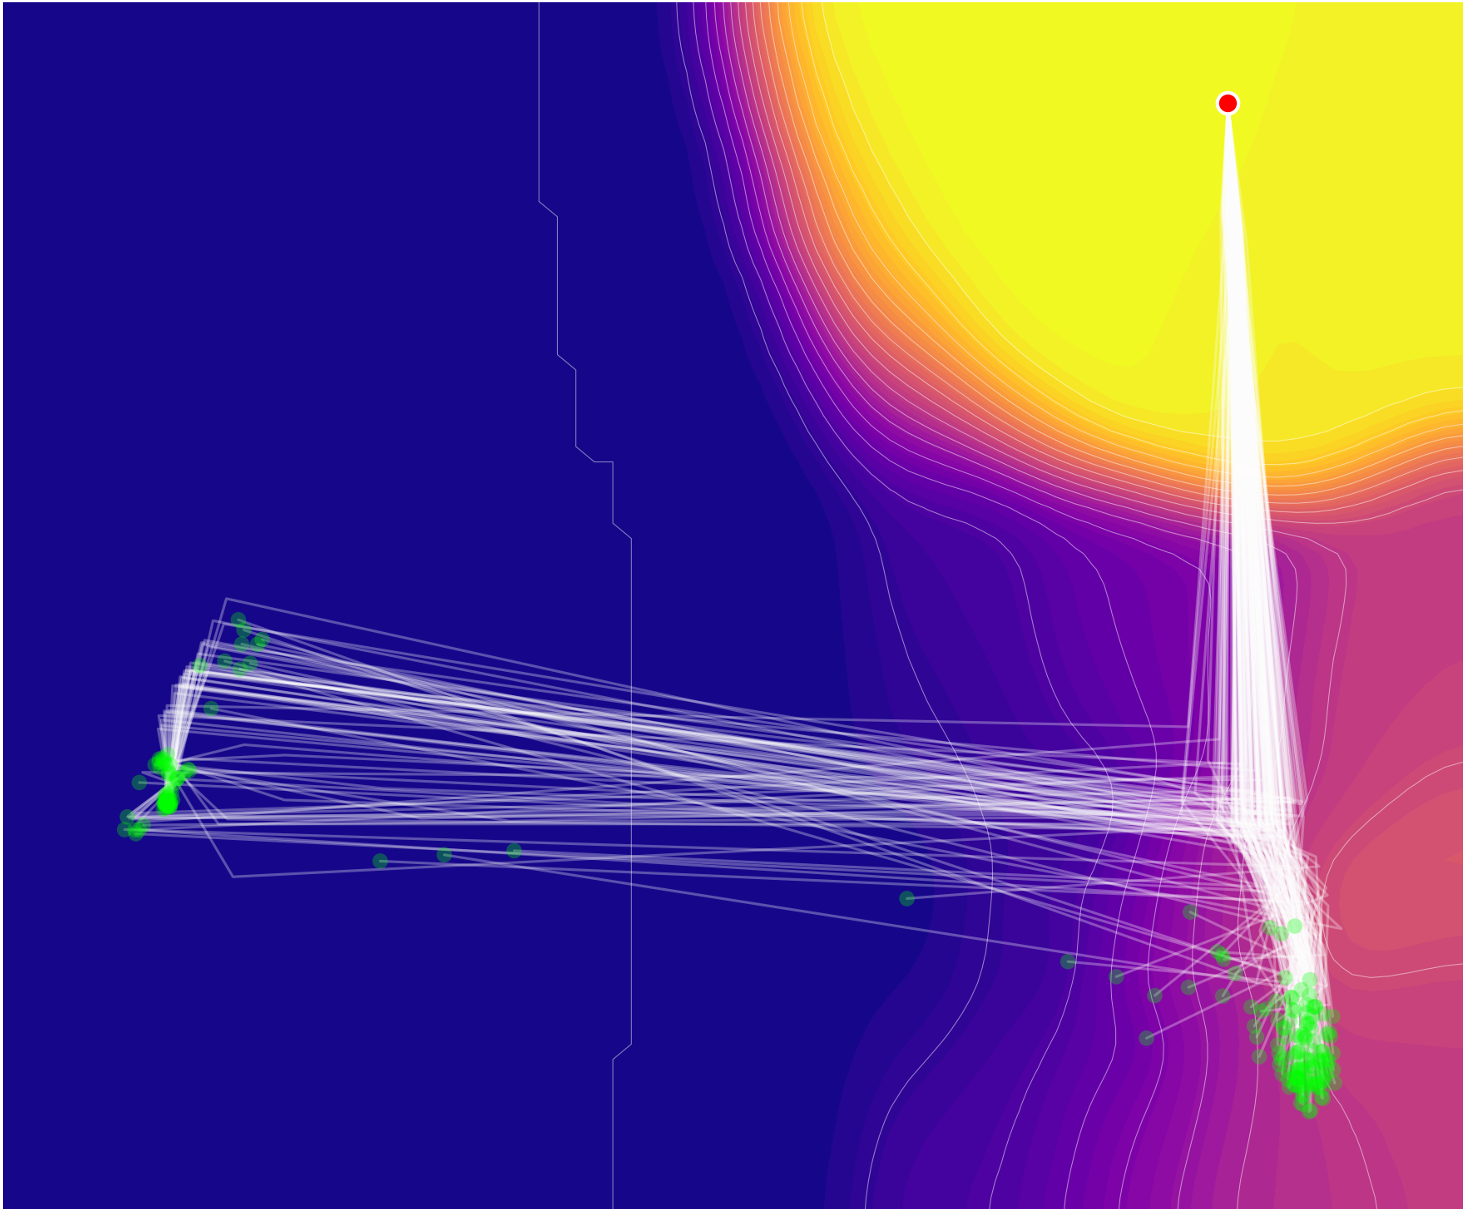
作者通过 PCA 降维可视化了潜状态的轨迹(如下图所示)。
- TRM 只有一条路走到黑(左图)。
- GRAM 则像是一群探索者,有些陷入了局部最优(亮色区域),但总有样本能成功穿过复杂的 Loss 地貌,到达全局最优的深蓝中心。
6. 总结与反思
核心价值:GRAM 证明了在递归推理中引入“不确定性”不仅不会造成混乱,反而是通往鲁棒逻辑推理的关键。它将推理从“结果预测”转变为“路径寻找”。
局限性:尽管效果惊人,但其深监督(Deep Supervision)的序列训练特性导致训练效率低于目前主流的非递归 Transformer。如何将这种生成式递归思想在大规模预训练模型上“平替”现有的预测逻辑,是未来最值得探索的方向。