
Cotton2035:棉花育种下一步不是更多位点,而是给基因组装上调控注释层
基因组学+遗传学.pdf
Cotton2035 是一篇 Molecular Plant 上的 Perspective,由 Wang Kun、He Shoupu 和 Zhu Yuxian 共同提出,核心主张是从棉花基因组资源积累走向 Cotton ENCODE 与 genomics-to-breeding(G2B)的精准育种框架。论文认为,棉花育种下一步的关键不是继续堆叠 QTL 或 GWAS 位点,而是系统解码表观、转录、三维基因组、单细胞与空间调控网络。其价值在于把棉花功能基因组学的长期缺项明确为“调控元件与时空网络注释”。
核心速览
TL;DR:这篇 Perspective 系统回顾了过去十余年棉花基因组学进展,指出棉花已经拥有从野生二倍体、四倍体到栽培种的高质量基因组和群体资源,但这些资源仍不足以解释纤维长度、品质、抗性和产量等复杂性状的形成机制。作者提出 Cotton ENCODE 项目,主张把育种重心从单纯挖掘 QTL 或 GWAS 位点,转向绘制调控元件、表观景观、三维基因组、单细胞与空间调控网络,并将它们接入 genomics-to-breeding(G2B)流程。论文的量化锚点包括:基于长读测序已有 15 个二倍体和 7 个四倍体棉种高质量基因组,全球基因库保存约 1 万份种质,标准棉花编辑周期接近 8 个月,而棉花产业年经济影响估计约 5000 亿美元。
从学术坐标系看,Cotton2035 不是刷榜型方法论文,也不是数据集基准论文,而是一份面向未来十年的战略路线图。它的判断依据不是新实验结果,而是对大量已有文献的整合:棉花基因组学已经解决了“序列坐标”问题,但育种真正卡脖子的位置已经转移到“功能解释”问题。换句话说,当前社区已经能够定位很多与性状相关的变异,却仍不能充分说明这些变异在哪一个细胞、哪一个发育阶段、通过哪一个调控层级影响最终表型。
问题与动机:基因型清单已经足够长,功能解释仍然不足
棉花的复杂性首先来自其演化与驯化史。论文 Introduction 指出,棉属约 1250 万年前出现,随后旧大陆 AA 基因组与美洲 DD 基因组祖先经过跨洋杂交与多倍化,在约 100 万至 200 万年前形成四倍体棉种;陆地棉和海岛棉又在约 8000 年前被人类独立驯化。更直接地看,栽培陆地棉中的 upland cotton 已成为全球主栽类群,贡献超过 95% 的棉纤维产量。这样的产业基础决定了棉花育种不能只追求单个性状,而必须在产量、纤维品质、抗逆性、抗性代谢物和种子可利用性之间进行系统权衡。
过去十年的主要进展集中在参考基因组和群体变异图谱。论文 Progress 章节回顾道,自 2012 年 Gossypium raimondii 草图基因组发布以来,D 基因组、A 基因组、K 和 G 基因组物种,以及 G. hirsutum、G. barbadense 和多个野生四倍体种相继被组装或升级;到论文写作时,已有 15 个二倍体和 7 个四倍体棉种基于长读测序获得高质量基因组。这些组装为构建高密度变异图谱、定位关键位点和开展 pan-genome 分析提供了基础。但作者同时强调,纤维如何从祖先型稀疏、短、带色的结构演化为今天密集、长、可纺白的纤维,LTR 逆转录转座子为何大规模扩张,异源四倍化究竟如何发生等核心问题仍未解决。
真正的瓶颈出现在“定位”之后。论文指出,许多重要农艺性状由大量小效应基因和环境互作共同控制,尤其纤维产量和抗逆性状高度敏感;同时,当前群体基因组和表型组研究表明,大量 GWAS 位点或 QTL 位于基因组间隔区,而棉花中增强子、抑制子与启动子之间的长程互作仍缺乏成熟实验体系。也就是说,现有方法可以把变异与表型联系到统计显著性层面,却不能稳定地把变异映射到生物学机制层面。作者提出的直觉是:要完成 G2B,必须先回答“这些变异影响什么生物过程、如何影响、为什么最终造成表型差异”。这一判断主要由文献整合提示得到支持,而非由新的实验数据证明。
核心章节:从位点清单到棉花功能操作系统
出发点:高质量基因组已经能“定位”,但还不足以“归因”
论文的出发点是,棉花基因组资源已经足以支撑从野生种、地方品种到栽培种的系统比较,但育种仍受限于功能解释不足。D 基因组中包括 14 个来自墨西哥西部的野生种,G. raimondii 不仅是最早获得草图基因组的物种,也后来成为棉属中首个发表端粒到端粒基因组的物种。A 基因组的分析进一步显示,A 与 D 基因组大小差异并非主要源于全基因组复制,而是大量 LTR 插入。此类发现说明,棉花基因组学的重心已经从“有没有参考序列”转移到“序列变异如何改变调控结构”。
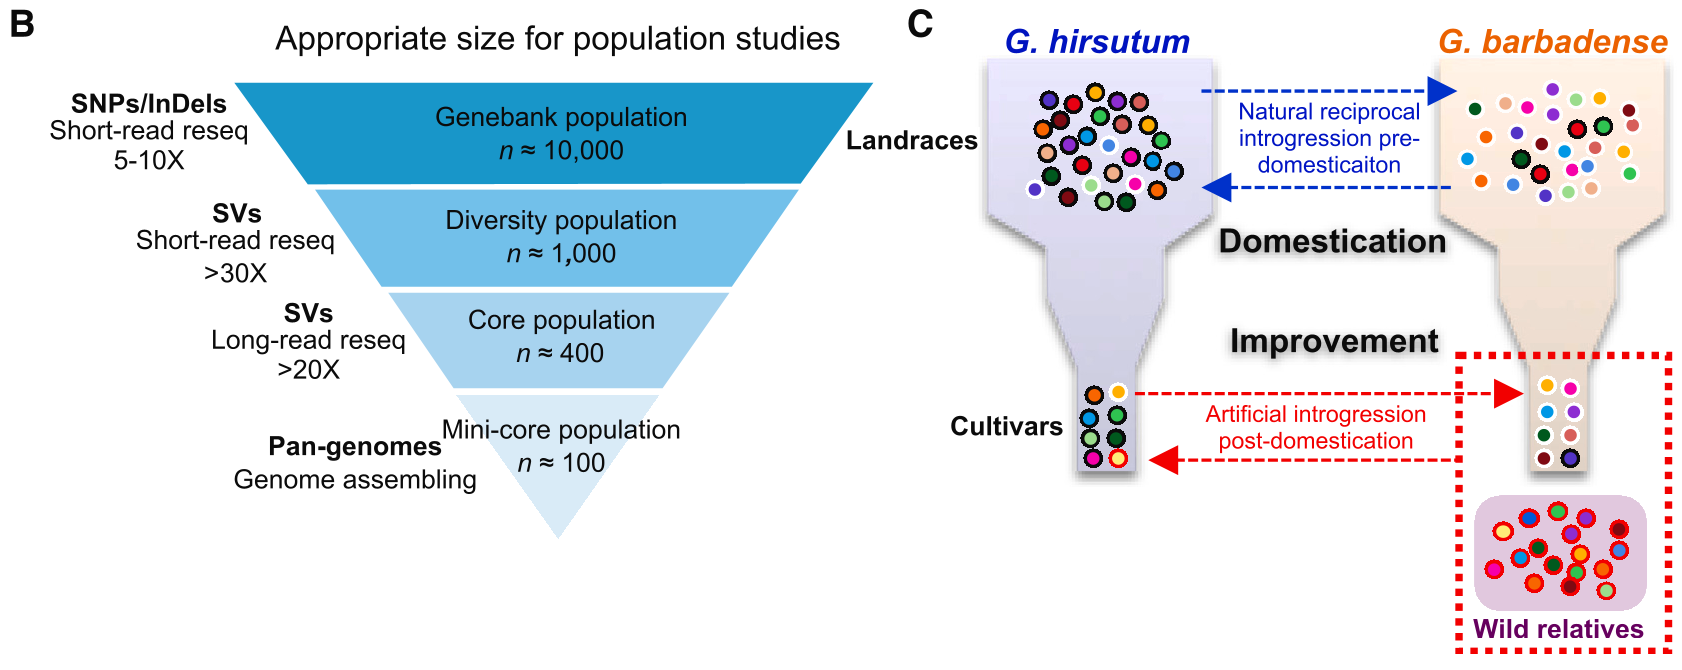
把 Introduction、Progress、germplasm evaluation 和 Perspectives 中分散给出的数字合并起来,可以看到论文依赖的资源基线:
| 维度 | 数字或事实 | 对 G2B 的含义 |
|---|---|---|
| 产业规模 | 棉花支撑约 1.5 亿从业者、分布 75 个国家;2024 年棉纤维产值约 420 亿美元,国际贸易额约 140 亿美元;年经济影响约 5000 亿美元 | 育种目标不是单点优化,而需同时服务纤维、油脂、蛋白饲料和工业副产物等多重用途 |
| 基因组资源 | 已有 15 个二倍体和 7 个四倍体棉种高质量基因组,主要基于长读测序 | 群体变异、结构变异和 pan-genome 分析的物理坐标已经可用 |
| 种质评估 | 基因库约 1 万份种质;样本缩到 1000 份以下时可结合短读与长读重测序研究结构变异;种内 mini-core 约 100 份可做高深度长读组装 | 从 SNP 到 SV 的分层解码已有规模基础,但功能注释仍滞后 |
| 编辑瓶颈 | 标准棉花编辑周期接近 8 个月 | 即使找到关键位点,去驯化和精准编辑仍受田间周转时间限制 |
这张表揭示的不是“资源不足”,而是资源结构失衡:参考基因组、群体规模和产业需求都很强,功能解释与育种决策之间的桥接层很弱。论文中 Figure 2A 展示的棉属进化树和基因组发布状态说明,物种覆盖已足够广泛;Figure 2B 所对应的测序策略图说明,群体评估路径也已经从低深度重测序推进到核心种质高深度组装。问题在于,这些图呈现的更多是“能测什么”,而不是“测到的变异如何转化为可设计性状的机制”。
Cotton ENCODE 的核心设计:把功能元素从静态序列拆成时空网络
论文提出的 Cotton ENCODE 并非简单扩展 ENCODE 概念,而是围绕棉花育种需求给出五项任务:建立高分辨率调控元件图谱;绘制 DNA 甲基化、组蛋白修饰和染色质可及性等表观景观;用 Micro-C 等技术解码三维染色质结构;整合单细胞与空间转录组,获得细胞和空间分辨率下的染色质状态与表达模式;建立统一协议、分析工具和公共数据库,推动全球协作。其设计逻辑是:如果多数表型相关变异位于非编码区,那么必须把它们放回一个包含染色质状态、调控互作、细胞类型和环境响应的多层网络中,才可能解释其效应。
这一框架之所以必要,是因为棉花已有零散证据显示不同调控层都能影响农艺性状。论文举例称,高温条件下棉花花粉中 H3K27me3 修饰水平升高,导致 Jasmonic acid 合成相关基因 GhAOS 和 GhAOC2 下调并引起雄性不育,而抑制组蛋白甲基转移酶活性可部分恢复育性。染色质可及性方面,ATAC-seq、DNase I 敏感性和微球菌核酸酶测序在棉花叶片或纤维中发现了显著一致性,并揭示长距离顺式调控元件。DNA 甲基化也与抗寒、耐热、开花、再生和纤维伸长有关,例如论文提到 upland cotton 中 GhATL68b 甲基化水平下降会促进其表达并推动纤维伸长。RNA 层面,论文指出 lncRNA、小 RNA、m6A 修饰以及翻译调控都存在关键作用;其中 miR156/157s 通过小 RNA 干扰路径促进纤维细胞伸长,GhALKBH5 介导的 m6A 去甲基化调控光周期敏感,GhALKBH10B 影响 ABA 与 Ca2+ 信号相关 mRNA 衰减和干旱反应。
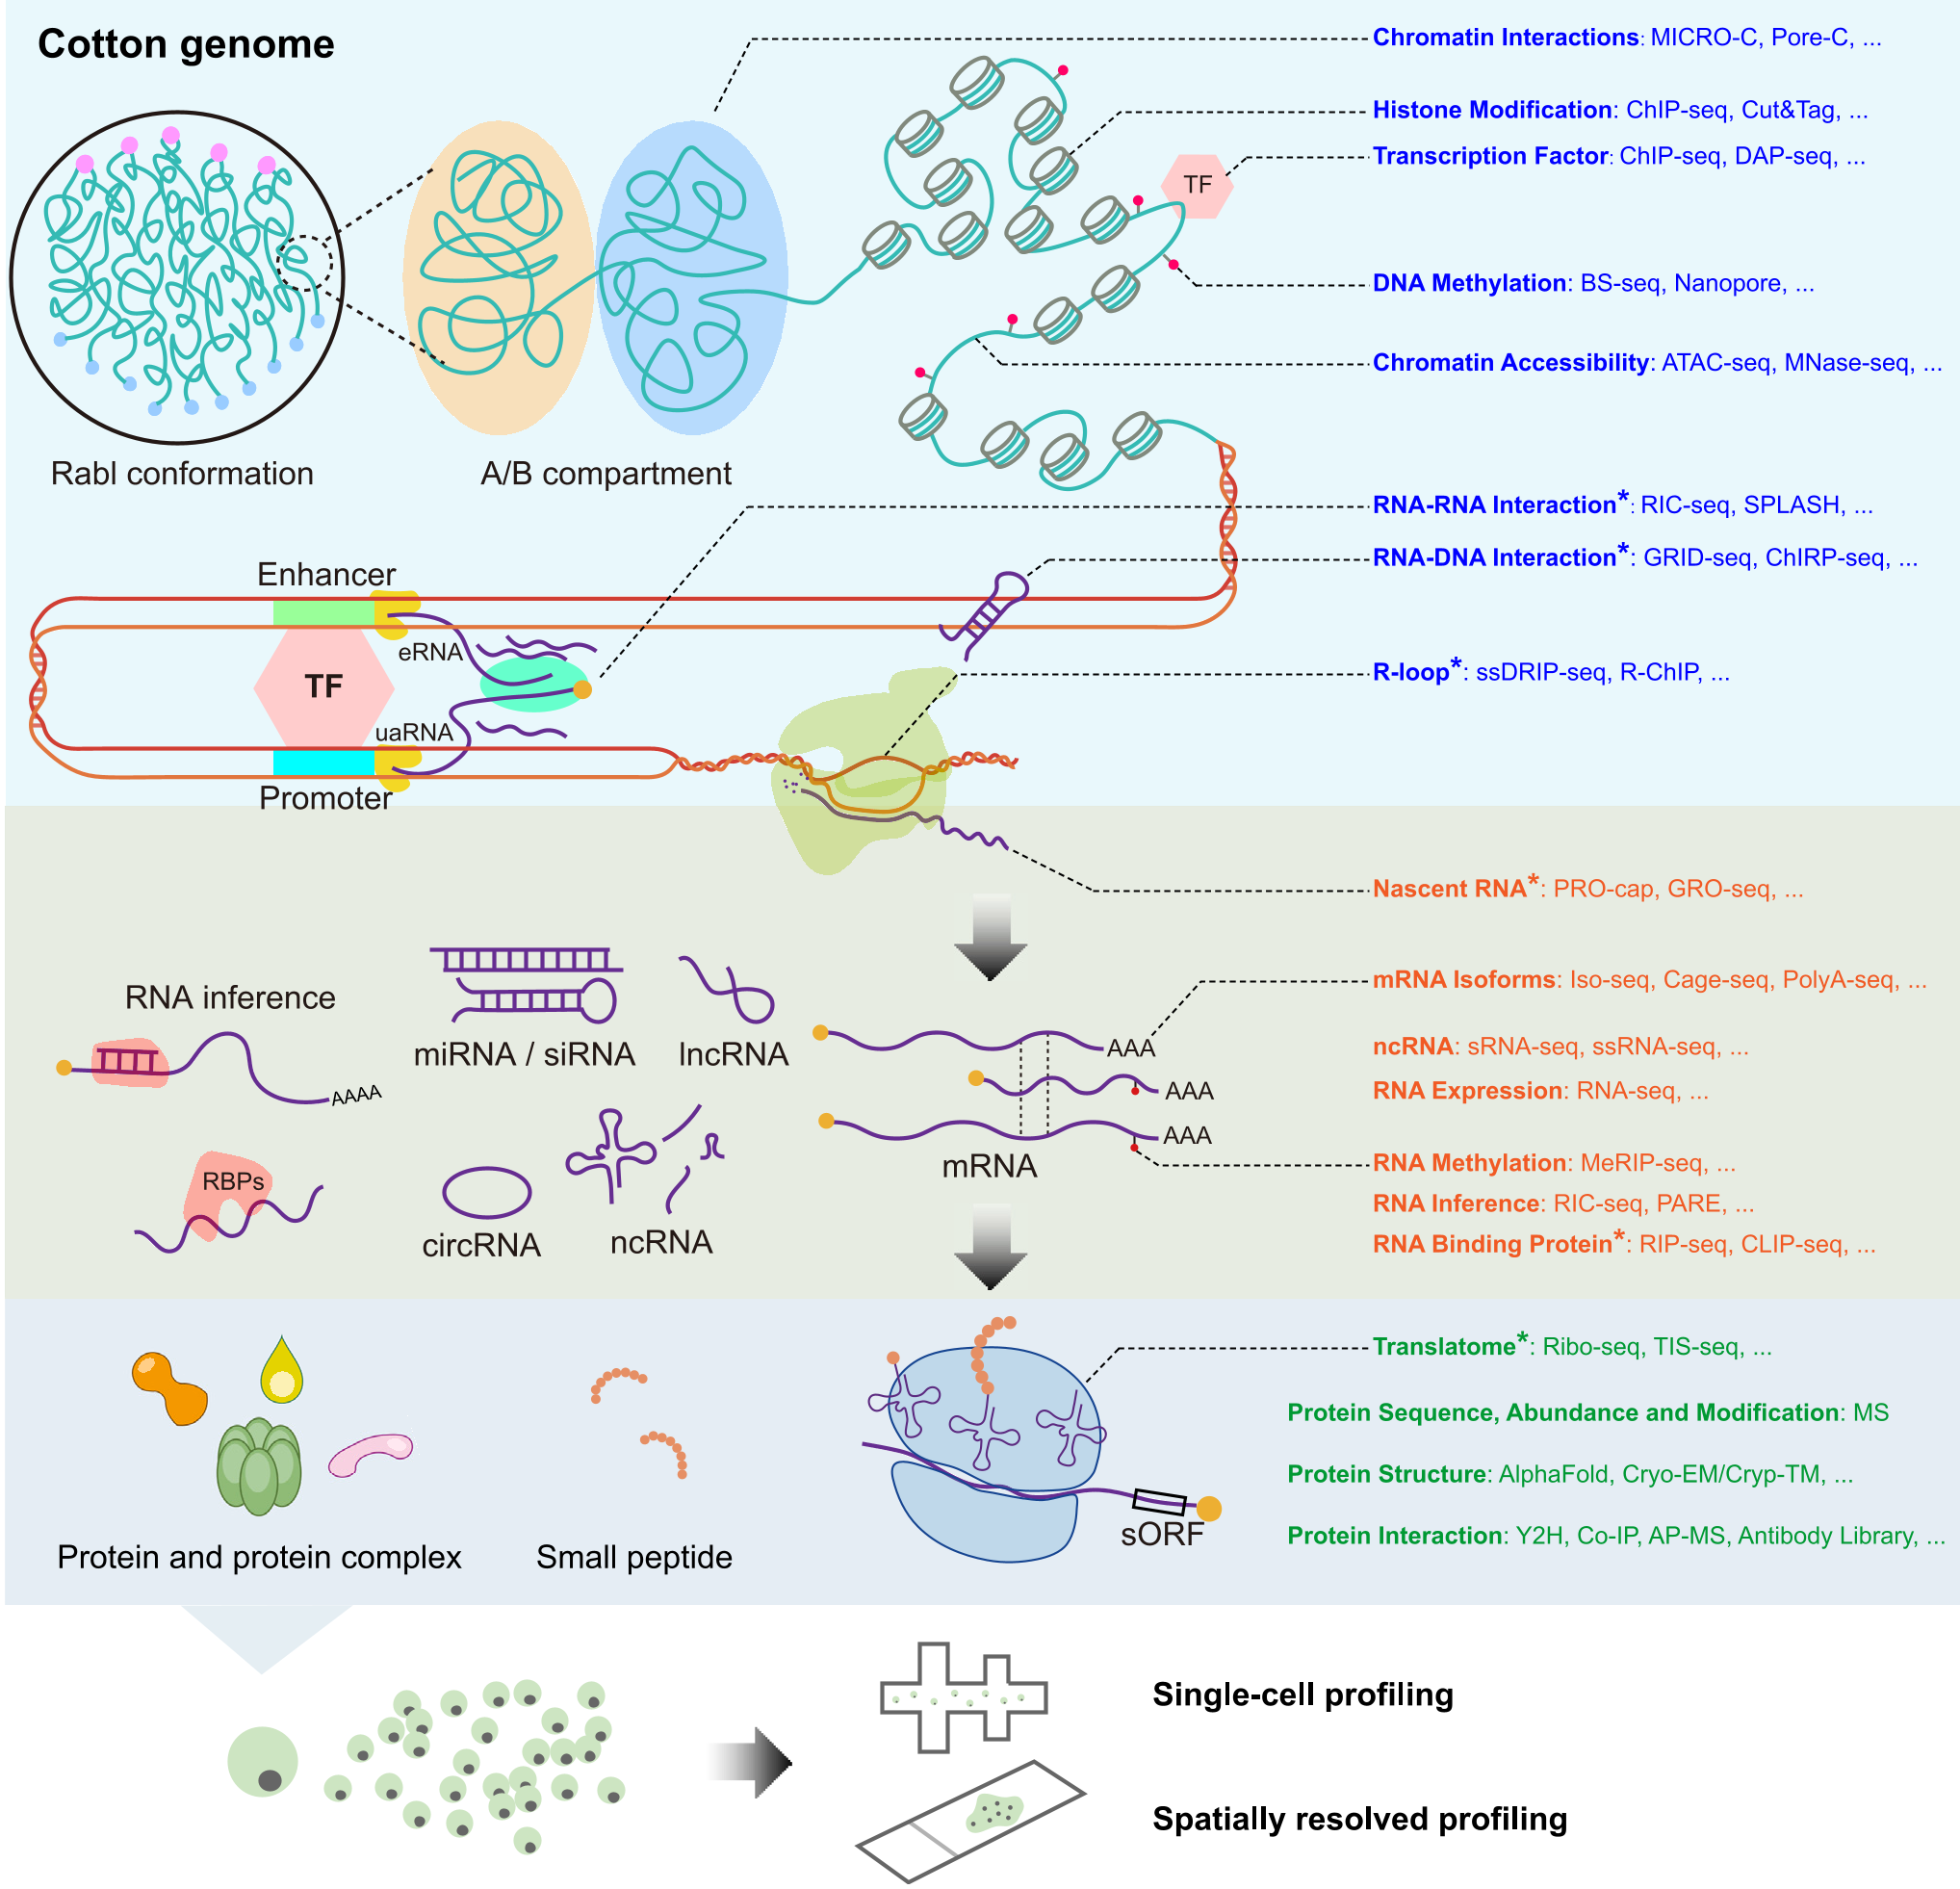
Figure 3 把这些分散案例组织成一张多层调控地图:左侧是表观、转录、翻译等细胞过程,右侧是对应测序技术,并用星号标出棉花中研究最少的方向。对 G2B 而言,这张图的重点不是展示技术清单,而是暴露一个结构性空白:棉花已经有很多“过程证据”,但还没有把这些过程组织成可用于预测和编辑的“系统图谱”。例如,单细胞 RNA-seq 已在棉花胚珠中帮助构建纤维细胞发育轨迹,发现纤维生长节律和小肽 GhRALF1 的调控作用;单细胞 ATAC-seq 追踪到 TCP 及其类似 motif 在纤维细胞中的开放状态,并连接 GhTCP14s 和线粒体代谢、蛋白翻译相关基因表达;空间转录组则在棉花茎尖揭示 GHCU 通过影响叶片生长素运输改变叶形。这些例子共同说明,性状调控具有细胞和空间维度,若只做 bulk 测序或只做 GWAS,信息会在平均化过程中丢失。
从设计理由看,论文没有解释为何优先采用这五项任务而不是其他组合,但其文本隐含一个合理排序:先解决非编码区功能注释,再解决调控互作,再解决细胞类型和空间定位,最后通过数据库和统一协议支撑 AI 预测。若缺少第一步,GWAS 位点只能给出区间;若缺少第二步,增强子和启动子关系无法确认;若缺少第三步,单细胞分化过程仍会被组织平均掩盖;若缺少标准化和公共库,跨团队、跨组学数据很难进入同一育种模型。论文未给出具体的样本量、组织覆盖、分辨率指标或验收阈值,这使该设计在战略层面成立,但在工程执行层面仍偏概念化。
依据与边界:这是路线图,不是已验证闭环
Cotton ENCODE 的依据主要来自已有文献案例的组合:染色质可及性、组蛋白修饰、DNA 甲基化、lncRNA、小 RNA、m6A、单细胞和空间组学都已经在棉花中零散出现,说明多层调控并非空想。论文进一步指出,RNA 互作研究在棉花中尚缺乏成熟体系,翻译调控、RNA binding protein 与 RNA 互作关系、nascent RNA 检测等方向明显薄弱。这种“已有证据提示机制存在,但系统工具仍缺”的结构,正是 ENCODE 计划的合理动机。
边界也很明显。论文不是实验研究,没有提出可量化成功的目标,例如覆盖多少组织、多少发育阶段、多少环境条件,增强子到靶基因注释达到何种精度,或者对基因组选择模型预测误差产生多大改善。它也未给出成本估计、数据治理方案或跨实验室标准。Perspectives 中提到的 AI 模型、GS 芯片、超级优良品种和 de novo domestication 都是方向性描述,而非已验证路径。尤其标准编辑周期接近 8 个月这一问题,说明即使 Cotton ENCODE 提供了位点,棉花育种仍可能被转化和筛选周期拖住;论文指出需要突破基因编辑工具和培养体系,但没有给出具体技术路线。
实验与证据:这篇论文的证据链是什么
主结果:没有性能指标,只有资源基线
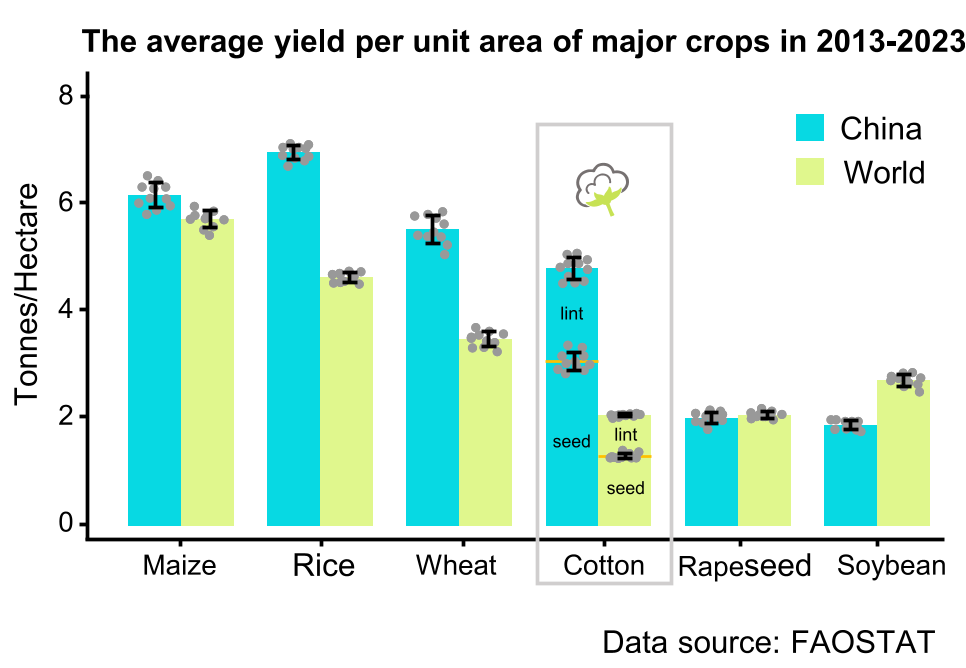
Cotton2035 的“主结果”并非模型精度或育种增益,而是对领域状态的总览。论文用 Introduction 和 Progress 中数字说明,棉花已经具备产业重要性、物种多样性、基因组资源和群体评估基础。Figure 1 显示,棉花不仅是纤维作物,还提供可食用油、高蛋白动物饲料、工业副产物和潜在药用代谢物;论文同时说明中国 2013 至 2023 年主要作物单位面积产量数据中,棉花籽在油脂和饲料来源上具有竞争力,但 Figure 1B 未给出具产量数值。这样的证据链适合支持“为什么要做”,不直接支持“做完后能提升多少”。
拆解性证据:论文使用层级案例,而非消融实验
由于没有新实验,论文无法提供传统意义的消融或控制变量。它采用的是另一种拆解方式:把 G2B 的缺口拆成表观调控、转录调控、RNA 互作、三维结构、单细胞和空间组学等层级,并给出一级实例。H3K27me3 与高温雄性不育说明表观层能连接环境响应和育性;ATAC-seq 与 Hi-C 联用提示顺式调控元件和染色质互作可能解释部分 GWAS 信号;GhATL68b 甲基化案例说明 DNA 甲基化可影响纤维伸长;m6A 相关研究说明 RNA 修饰可连接环境适应;单细胞和空间转录组则说明细胞类型差异会改变基因调控解释。
这些案例彼此相关,但尚未构成统一验证体系。它们证明棉花中存在多层调控,却不能证明 Cotton ENCODE 一定能在预定时间、预定成本和预定精度内解释关键农艺位点。换句话说,论文的论证方式更像“拼图式综述”,而不是“证据式基准”。
证据质量:哪些结论稳,哪些结论仍偏乐观
从证据强度看,最稳的是资源层结论:棉花物种数、基因组发布状态、种质规模、产业数字和编辑周期都直接来自论文文本或其所引资料,可信度较高。次一级稳的是机制层判断:已有独立研究显示棉花存在组蛋白修饰、DNA 甲基化、lncRNA、小 RNA、m6A 和单细胞调控,说明多层调控并非假想。相对脆弱的是系统层判断:如何把这些零散组学图谱整合成可指导基因组编辑和 GS 的网络,以及这种网络是否能在产量、纤维品质和抗性之间形成可预测的权衡,论文没有给出量化证据。
这也解释了为什么 Cotton2035 应被读作“问题定义论文”,而不是“方法证明论文”。它把领域共同感觉到的问题说清楚了:位点越来越多,解释越来越难;但清楚定义问题之后,真正困难的是建立可重复、可评估、可迁移的功能注释基础设施。论文未给出这些基础设施的验收标准,这是其核心局限,也是后续研究必须补足的部分。
深度洞察与总结
这篇论文的核心贡献可以概括为三点。第一,它指出棉花基因组学已经从“序列获取”进入“解释压力”阶段,高质量基因组和 pan-genome 解决了坐标问题,但非编码区、结构变异和调控网络仍未充分打开。第二,它把 Cotton ENCODE 定义为棉花育种基础设施,强调功能元素注释必须同时包含细胞类型、发育阶段和环境条件。第三,它给出了 G2B 的三段式策略:强化基础研究、扩展和整合遗传资源、创新育种策略;其中超级优良品种、de novo domestication、功能位点字典、GS 芯片和基因组编辑被放在同一闭环中讨论。
论文的局限同样具体。它没有提出 Cotton ENCODE 的技术验收指标,例如至少覆盖哪些组织、哪些发育窗口、哪些环境处理,也没有说明增强子与靶基因关联如何被验证。它指出翻译调控和 RNA binding protein 研究缺失,但没有给出具棉花专用的实验方案。它强调 AI 与 GS 是 G2B 的关键,但没有说明训练数据、表型采集频率、模型评价指标或跨环境稳健性检验。对于约 1 万份种质和少于 1000 份的分层测序策略,论文只提出思路,没有说明如何避免批次效应、如何统一表型测量,以及如何让结构变异数据真正进入育种模型。
面向未来,这篇论文最值得推进的不是继续增加基因组数量,而是建立“棉花性状可解释性”的最小闭环。优先对象应包括纤维发育的胚珠和纤维细胞、高温胁迫下的花药、抗逆相关的根和叶片,以及 gossypol 代谢和品质性状涉及的腺体组织。技术路线上,需要把 GRID-seq、RIC-seq 等 RNA 与 DNA 或 RNA 与 RNA 互作方法移植进棉花体系,结合 Micro-C 和单细胞 ATAC/RNA 数据构建增强子网络,再用 GWAS、GS 或近等基因系验证关键调控元件。若三年后 Cotton ENCODE 仍能停留在多组学热图层面,而没有在至少一个复杂性状上实现“调控元件识别、细胞类型定位、网络扰动、表型变化”的完整闭环,那么论文提出的 G2B 主张仍需更强证据。