
GeoChat:首个具备视觉定位能力的遥感大模型,突破卫星影像对话边界
Geochat: Grounded large vision-language model for remote sensing
本文推出了 GeoChat,这是首个具备视觉定位(Grounding)能力的遥感领域多模态大模型。该模型基于 LLaVA-1.5 架构,通过在涵盖 31.8万 条指令的专用遥感数据集上进行微调,实现了从图像级描述到区域级对话及坐标定位的跨尺度任务统一。
TL;DR
在通用视觉多模态领域(VLM)如火如荼之际,遥感(Remote Sensing, RS)领域却因其“小目标多、分辨率高、专业性强”等特点,面临通用模型表现乏力的尴尬。本文提出的 GeoChat 填补了这一空白,它是首个能够对遥感影像进行视觉定位(Grounding)并开展多轮区域对话的大模型。
痛点深挖:为什么 ChatGPT/LLaVA 玩不转遥感影像?
尽管 LLaVA 或 GPT-4V 在日常照片上的表现惊艳,但在面对俯瞰、俯视且包含成百上千个微小目标的卫星地图时,它们往往会“迷路”:
- 空间感知力缺失:通用模型无法理解经纬度坐标或像素坐标体系,导致无法精确定位。
- 尺度不匹配:遥感影像通常是超高分辨率,简单的缩放会导致小目标(如油罐、小型飞机)丢失。
- 行业语料匮乏:现有的指令对数据集大多关于猫狗或室内场景,缺乏如“油库布局”、“洪水浸没区分析”等专业语料。
方法论详解:如何打造“遥感专家”?
1. 统一的任务框架与 Token 设计
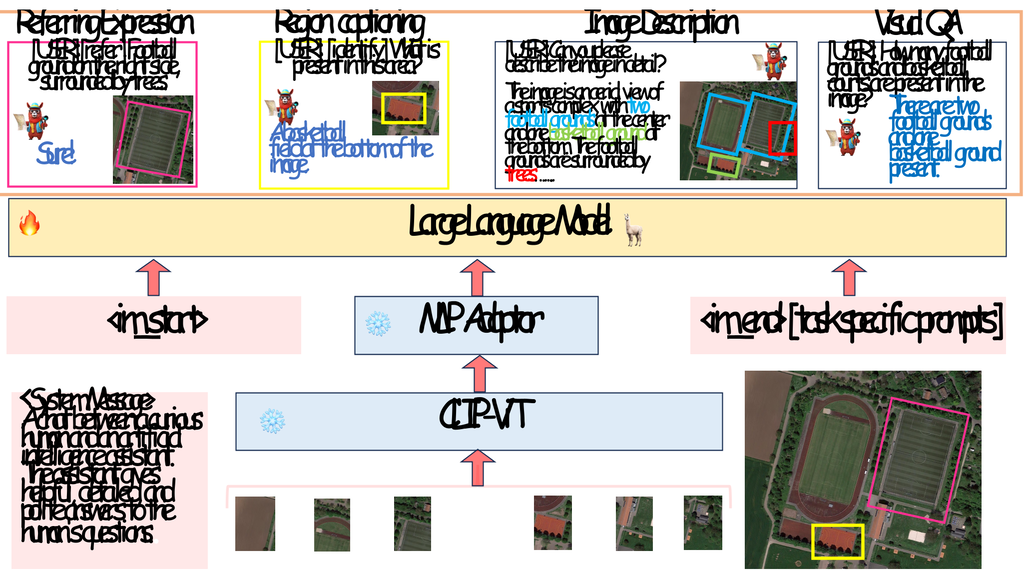
GeoChat 不仅能泛泛而谈,还能执行多重任务。作者通过引入 Task Specification Tokens 进行引导:
[grounding]:引导模型生成带有具体坐标 [x, y] 的描述。[identify]:针对用户框选的区域(RoI)进行特定描述。[refer]:执行指代消解任务(Referring Expression)。
2. 跨模态对齐与分辨率进化
为了看清“芝麻绿豆”大的目标,GeoChat 将视觉编码器(CLIP-ViT-L/14)的输入分辨率从 336 提升至 504。这一步并非生硬拉伸,而是通过位置编码插值(Positional Encoding Interpolation)实现的,这让模型在保持预训练权重的逻辑一致性的同时,显著增加了特征图的感受野颗粒度。
3. 海量遥感指令数据集 (318k)
这是本文最大的贡献之一。作者利用已有的目标检测数据集(如 SAMRS, DOTA),将其结构化标签通过 Vicuna 转换为自然对话指令。
- 逻辑链:[标注框 -> 属性提取 -> 模版转换 -> LLM 润色] = 高质量遥感对话对。
实验与结果:全方位吊打通用模型
在实验中,GeoChat 展示了极强的 Zero-shot(零样本) 迁移能力。即使模型从未在特定的场景数据集(如 UCMerced)上进行全量训练,其表现依旧出色。
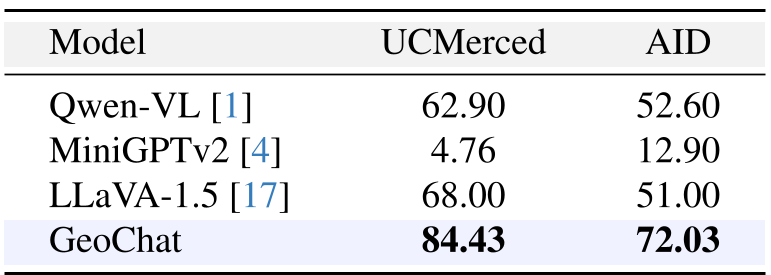
- 场景分类:在 UCMerced 数据集上,GeoChat 达到了 84.43% 的准确率,远超 Qwen-VL 和 MiniGPT-v2。
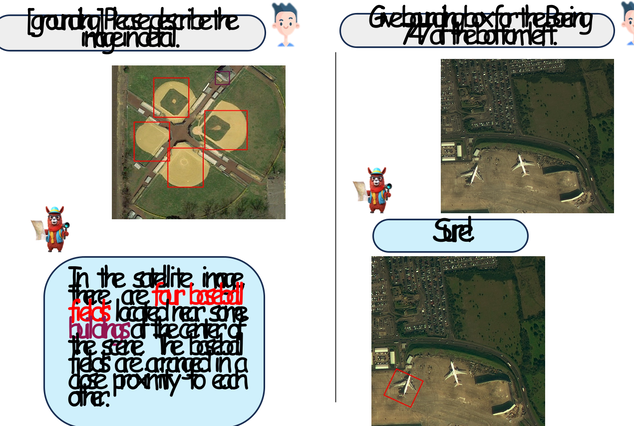
- 视觉定位能力:如下图所示,当用户询问“跑道上的波音 747 在哪”时,模型不仅能识别出飞机,还能直接给出包围盒坐标。
深度洞察与总结
GeoChat 的核心价值在于它证明了“领域适应”并非简单的微调。 通过引入空间坐标表示和针对遥感特性(如旋转框、极小目标)的重构,原本在普通照片上运行的 VLM 成功飞向了“太空视野”。
局限性与展望
虽然 GeoChat 在 504x504 分辨率下表现优异,但面对真正的超大比例尺卫星图(如数万像素的长图),仍然面临显存爆炸或物体畸变的挑战。未来的研究可能会更多地关注滑窗注意力机制或多尺度特征金字塔在大模型中的集成。
Takeaway: 如果你想开发一个能听懂“那里有多少辆坦克”并将其标出来的卫星 AI 助手,GeoChat 提供的这套指令微调方案就是目前的行业金标准。