
揭示闪电注意力的几何本色:代数几何视角的深度解析
Geometry of Lightning Self-Attention: Identifiability and Dimension
本文通过代数几何工具系统分析了闪电自注意力(Lightning Self-Attention)网络定义的功能空间的几何性质。研究确定了深层注意力网络参数化的通用纤维(Generic Fibers)结构,并据此给出了该网络 neuromanifold 的降维计算公式,揭示了其在表达能力和样本复杂度上的理论极限。
TL;DR
本文深入探讨了 闪电自注意力 (Lightning Self-Attention) 网络背后的“神经流形”(Neuromanifold)。通过代数几何的严密推导,作者不仅计算出了该模型在函数空间中的真实维度,还揭示了参数中隐藏的对称性冗余。结果表明,我们通常认为的模型规模(参数量)远大于其真实的表达自由度——这种“虚胖”正是由模型架构内在的代数结构决定的。
核心动机:模型真的有那么多参数有用吗?
在深度学习中,我们习惯于用参数量(Parameters count)来衡量模型的复杂度。然而,从数学视角看,多层神经网络定义的函数空间是一个复杂的、带奇异点的几何对象。由于 可识别性(Identifiability) 问题的存在,不同的权重可能对应同一个数学函数。
作者选择 Lightning Self-Attention 作为突破口,是因为它省去了复杂的 Softmax 归一化,使其在数学上呈现出优雅的 多项式特性:它关于权重是三线性的,关于输入是三次的。这为利用代数几何这一“重武器”扫平了障碍。
架构解析:从权重到神经流形
闪电自注意力将输入序列映射为输出,其核心公式为: 其中 被定义为注意力矩阵。
为了研究深层网络的几何性质,作者引入了 虚拟权重 (Virtual Weights) 转换。
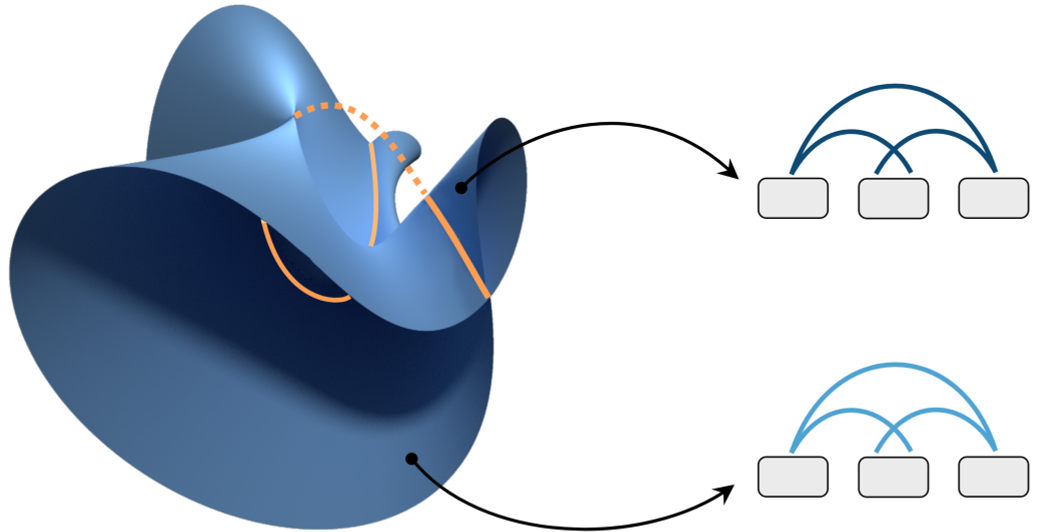 图 1: 闪电自注意力机制空间的切片可视化,展示了其复杂的流形结构。
三大核心对称性
研究发现,深层闪电注意力网络存在三类主要的参数冗余,这意味着这些变换不会改变模型所代表的函数:
- 各层缩放对称性:每一层都可以进行常数倍缩放,只要总乘积保持平衡。
- Query-Key 内部对称性: 的分解本身具有可逆矩阵变换的冗余。
- 层间抵消对称性:前一层的输出被某种变换放大,而后一层的输入将其精准抵消。
关键发现:流形的维度与奇异性
通过刻画上述对称性(即参数化映射的“纤维”),作者给出了深层网络维度的解析公式。在经典的瓶颈(Bottleneck)架构中,维度的增长远慢于参数的增加。
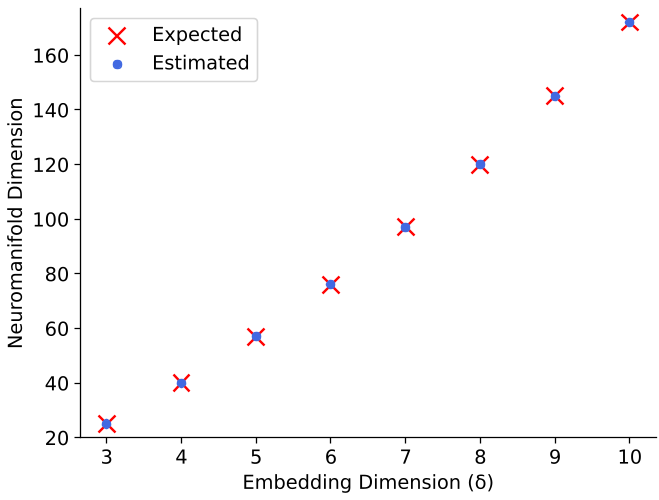 图 3: 理论计算的期望维度与其数值估计值的完美契合,验证了猜想的正确性。
训练动力的隐形手:奇异点
研究进一步指出,当注意力矩阵 或权重 的秩 时,流形会出现 奇异点(Singular Points)。在学习理论中,奇异点往往对梯度下降具有强大的吸引力,这在数学层面解释了为什么注意力机制倾向于学习到“极低秩”的特征表达。
深度洞察:这对 AI 研究意味着什么?
- 更精准的样本复杂度估计:传统的学习理论基于参数计数,而本文提供的维度公式能给出更精确的训练数据量需求。
- 优化器设计的启示:既然参数空间充满了“空转”的方向(纤维),我们是否可以开发出能够沿着这些纤维“瞬移”的优化算法(如 Teleportation),从而跳过训练中的平台期?
- 对归一化的新认识:作者证明了增加 Softmax 后,虽然打破了缩放对称性,但流形的核心几何维度变化微乎其微。这暗示了 Lightning 变体在理论能力上与传统注意力是高度一致的。
总结
这篇论文将抽象的代数几何与前沿的 Transformer 架构相结合,完成了一次漂亮的“黑盒拆解”。它提醒我们,在疯狂堆砌算力的同时,深入理解神经网络定义的“功能空间几何形态”,可能是通往下一代高效架构的关键钥匙。
局限性:当前分析尚未涵盖残差连接(Skip Connections)和多头注意力(Multi-head)。残差连接会打破齐次性,进一步压缩参数间的冗余。