
理由的几何学:利用光谱指纹识别 Transformer 的真伪推理
Geometry of Reason: Spectral Signatures of Valid Mathematical Reasoning
本文提出了名为“理由几何学 (Geometry of Reason)”的框架,利用光谱图论(Spectral Graph Theory)在无需训练的情况下验证 Transformer 模型的数学推理有效性。通过分析注意力矩阵的光谱特征(如 HFER 和 Fiedler 值),研究揭示了合法推理在注意力机制中产生的独特“光谱指纹”,在多款 SOTA 模型中实现了 85-96% 的验证准确率。
TL;DR
验证语言模型是在“真推理”还是在“套公式”一直是 AI 界的难题。本文提出了一种全新的视角:有效的逻辑推理在 Transformer 的注意力机制中会留下独特的光谱指纹。 这种方法无需任何训练(Training-free),仅通过分析注意力图的光谱特征,就能以高达 96% 的准确率识别数学证明的有效性,甚至能纠正编译器的错误判断。
背景定位
目前大模型在奥数级证明上屡创新高,但即便最强的模型也经常陷入“推理幻觉”——看起来逻辑严密,实则漏洞百出。本文作者 Valentin Noël 指出,推理的有效性与其说是语义问题,不如说是一个拓扑问题。该工作在学术坐标系中处于“机械可解释性”与“形式化验证”的交汇点,是一篇利用经典数学工具(谱图论)解决前沿深度学习黑盒问题的佳作。
痛点深挖:编译器也会“误判”
传统的推理验证依赖编译器(如 Lean)。但这产生了一个悖论:一个数学直觉完全正确、逻辑严密的证明,可能仅仅因为环境配置错误、缺少 import 或运行超时而被编译器判定为“Invalid”。作者称之为“编译有效性”与“柏拉图有效性(Platonic Validity)”的脱节。现有基于监督学习的探测器虽然能解决部分问题,但它们需要海量标注数据,且对模型架构极其敏感。
核心方法论:注意力即动态图
作者的核心 Insight 是:将 Transformer 的自注意力矩阵视为一个动态加权图。
1. 架构解析
- 图转化:将 个 Token 视为节点,注意力权重视为边权重,通过对称化处理得到拉普拉斯矩阵 。
- 信号投影:将每一层的隐藏状态(Hidden States)视为定义在图节点上的信号,并通过图傅里叶变换(GFT)将其投影到光谱域。
- 光谱诊断:提取关键指标,其中最显著的是 HFER (高频能量比)。有效的推理通常表现为能量集中在低频模态(低 λ 值),意味着信息流在 Token 之间是连通且平滑的。
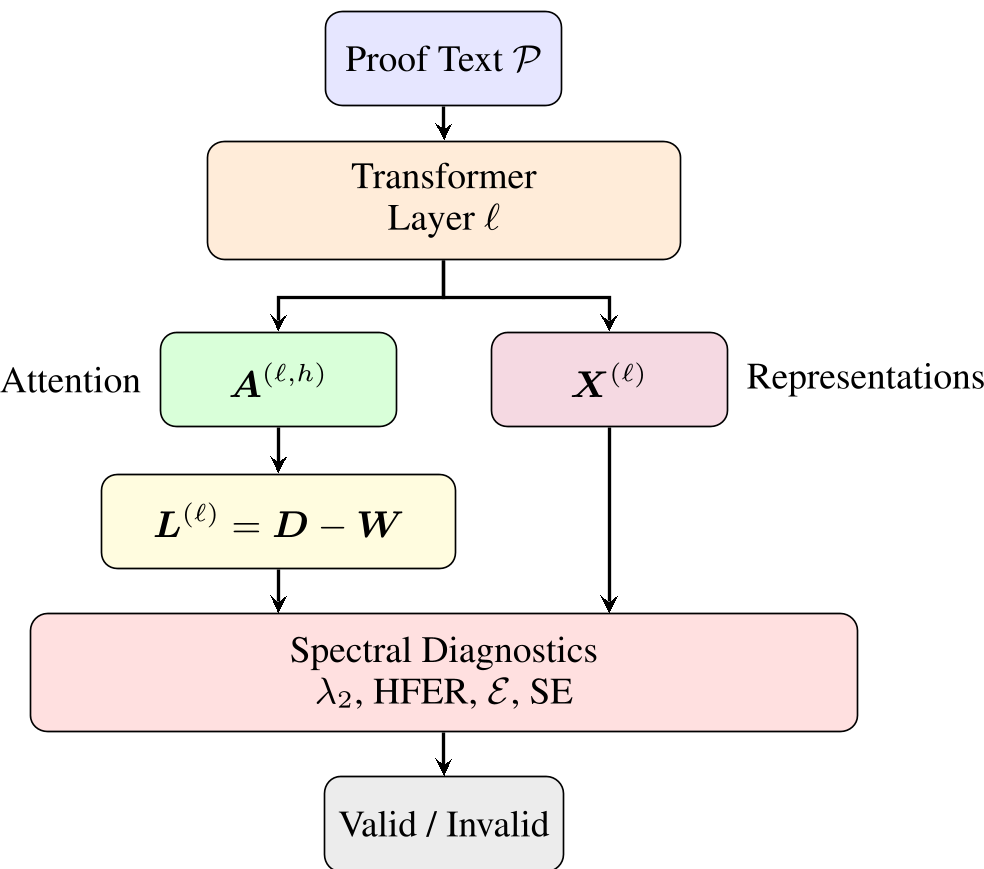 图 1:光谱分析流水线。从注意力矩阵提取拉普拉斯矩阵,并计算四个核心光谱诊断指标。
实验战绩:真理的形状
研究覆盖了 Llama-3、Qwen、Phi-3.5 和使用滑动窗口注意力的 Mistral。
- 近乎完美的区分度:在 Llama-3.1-8B 上,HFER 指标在 30 层展现出了惊人的分布分离。Cohen's d 效应量达到 3.0,这意味着有效证明和无效证明在统计上几乎完全不在一个量级。
- 逻辑连通性(Fiedler Value):研究发现,有效的推理能够诱导更强的全局连通性。如果推理断层,Fiedler 值会骤降,意味着信息图发生了“骨折”。
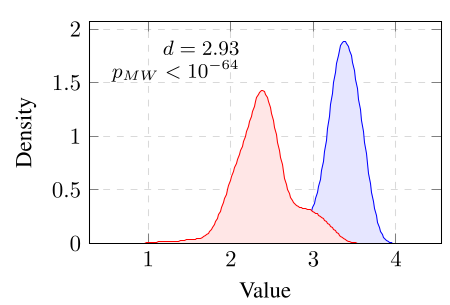 图 2:Llama-3.1-8B 的 HFER 密度图。蓝色(有效证明)与红色(无效证明)几乎实现了完全分离。
深度洞察
1. 柏拉图有效性发现
这是本论文最令人兴奋的发现:当光谱方法判定“有效”而 Lean 编译器判定“无效”时,人工审计发现 64.8% 的情况下,模型其实是写对了证明,只是因为技术细节无法编译。这意味着光谱指纹触及了逻辑的本质,而非仅仅是语法的正确。
2. 架构决定论
针对 Mistral 模型的分析显示,由于其采用了滑动窗口注意力(SWA),其推理指纹从“频率分布(HFER)”转移到了“局部平滑度”。这提示我们:推理验证工具必须意识(Aware)到底层架构的拓扑约束。
局限性与展望
尽管在形式化数学(Lean)中表现近乎完美,但在自然语言(informal CoT)推理中,该信号有所衰减(效应量从 3.02 降至 0.78)。此外,计算图拉普拉斯矩阵的光谱特征在处理极长文本(32k+)时仍有计算压力,虽然作者提出了 Lanczos 加速算法(复杂度降至 ),但工程上的实时部署仍具挑战。
总结
本文为我们提供了一个深刻的启示:逻辑推理不仅仅是符号的堆砌,它在模型内部有着明确的拓扑形态。 有效的理由是平滑且连通的,而幻觉则是支离破碎的光谱噪声。这套无需训练的工具,或许将成为未来可靠推理搜索(Proof Search)的标准配置。