
GIScholarBench:当 LLM 在学术研究中“一本正经地胡说八道”
GIScholarBench: Benchmarking LLM Overconfidence in GIS Research
本文推出了 GIScholarBench,这是一个专门针对地理信息科学 (GIScience) 领域的 LLM 评估基准,涵盖 10,865 篇核心期刊论文。该基准通过元数据检索、文献链接和研究方向生成三大任务,系统评估了 Claude 4.5、Gemini 3 和 ChatGPT 5.3 在学术工作流中的“过度自信”(Overconfidence) 行为。
TL;DR
大语言模型(LLM)已深度介入学术研究,但其“过度自信”(Overconfidence)现象却成为严谨性的一大威胁。近期论文《GIScholarBench: Benchmarking LLM Overconfidence in GIS Research》通过 1 万余篇 GIS 领域论文,揭示了 Claude、Gemini 和 ChatGPT 在处理学术任务时的三大软肋:元数据捏造、虚假引文链接、以及创新方向的“保守化”塌陷。
痛点深挖:学术工作流中的“行为过度自信”
在通用对话中,LLM 的幻觉可能只是笑话;但在学术研究中,一个不存在的 DOI 或一条虚假的参考文献(Citation Hallucination)会迅速在数据库和审稿流程中传播,造成极高的纠错成本。
作者指出,目前的 LLM 在学术任务中表现出一种行为学上的过度自信:无论其底层知识是否缺失,它们都能输出格式完美、语气坚定的结论。这种“盲目专业感”误导了依赖其进行文献调研的研究者。
核心内容:GIScholarBench 评测框架
作者基于 2020-2025 年间 25 本 GIS 核心期刊、共 10,865 篇论文构建了评测体系,重点考察三个维度:
- Metadata Retrieval (事实准确性):通过 DOI 找标题或反向检索。考察模型是否会在不确定时“盲目猜测”。
- Literature Linking (关联可靠性):基于给定的论文,生成 20 条真实的参考文献或引用文献。
- Research Direction Generation (知识完整性):预测论文未来的研究方向,并与真实发生的后续论文进行对比。
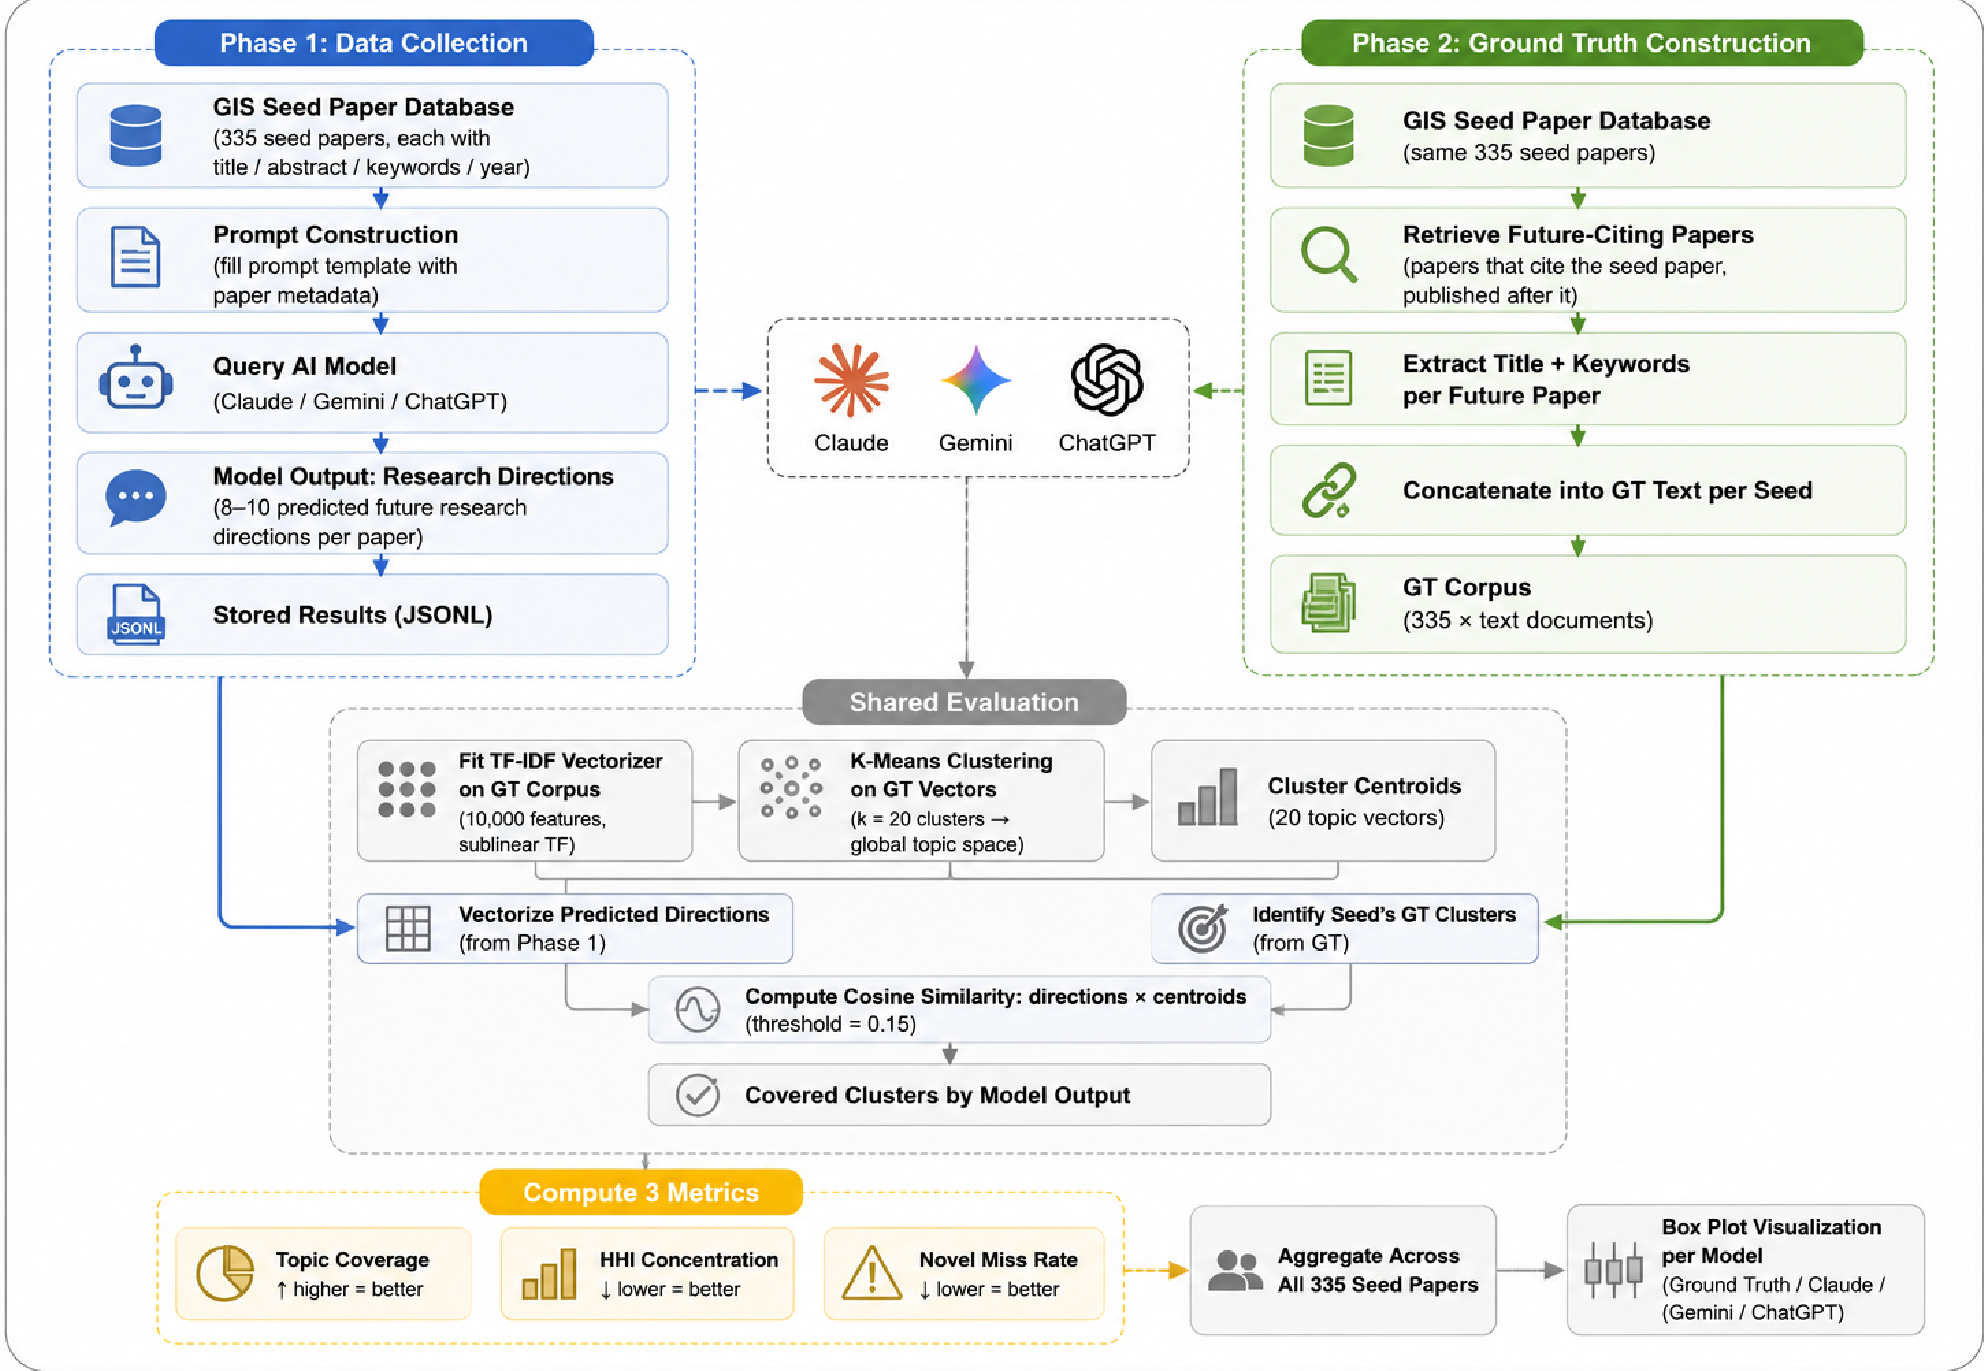 图 1:未来研究方向生成与主题空间评估框架
实验洞察:过度自信的三重面具
1. 事实的过量生成
在元数据检索中,ChatGPT 5.3 的准确率虽能达到 0.61-0.87,但最致命的问题在于:当模型不知道正确答案时,它依然会伪造出一个看起来极其真实的 DOI 字符串。即便在 Prompt 中加入“请验证语义一致性”的强指令,Claude 等模型反而可能因为过度修正产生更多偏差。
2. 引文关系的虚假演变
在文献链接实验中,研究发现了一个有趣的现象:Hit@1 极高,但 Hit@10 极低。这意味着模型通过训练数据能记住文章最相关的“锚点引文”,但一旦被要求列出长列表(如 20 条),它们就开始利用参数逻辑“脑补”那些看似合理实则不存在的链接。
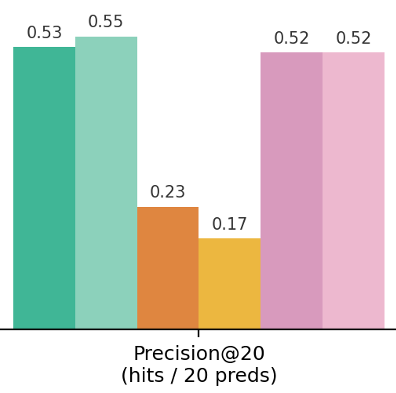 图 2:文献链接性能对比(Hit@1 表现良好,而 Hit@10 显著下降)
3. “盲人摸象”式的启发建议
在生成研究建议时,AI 表现出极强的“保守主义”。通过 K-Means 对主题空间进行映射发现(见下图 8):
- 真实研究 (Ground Truth):分布广泛且散乱,代表了人类研究者的多样化探索和跨界创新。
- AI 生成方向:高度集中在中间的“主流”地带。
- 结论:AI 显著忽略了前沿、非传统或跨学科的方向。
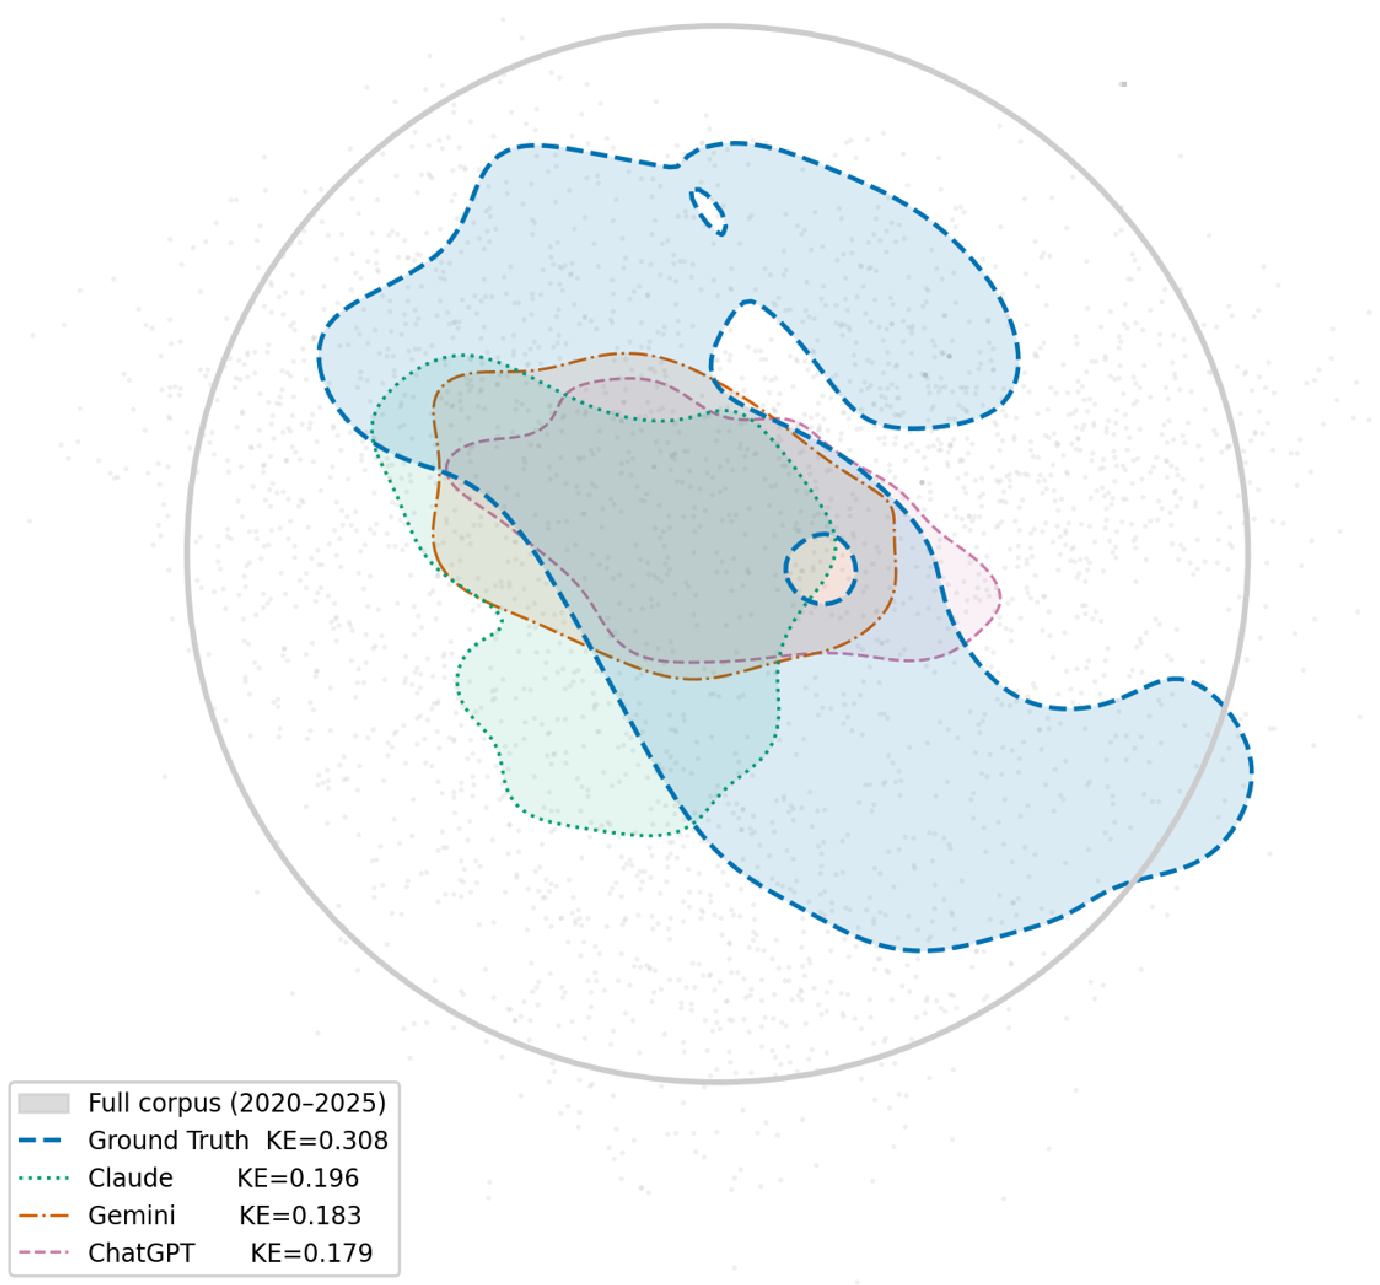 图 3:真实研究方向与 AI 生成方向在极地/边缘语义空间的覆盖对比
深度思考:如何与“傲慢”的 AI 共处?
论文结论给 GIS 及广大科研从业人员敲响了警钟:
- 不要直接复制:LLM 生成的 DOI 和参考文献列表必须经过 Scopus 或 Crossref 等权威数据库二次校验。
- 定位“辅助者”:AI 适合作为最初的头脑风暴工具(利用其优秀的 Hit@1 性能寻找切入点),但不应作为“事实出口”。
- 警惕平庸化:如果全社会科研人员都根据 AI 建议来定方向,可能会导致科学研究的视野急剧萎缩到模型覆盖的“主流均值”中。
总结
GIScholarBench 证明了 LLM 的过度自信是一种形式随任务而变的普遍特质。未来的研究需要更多关注如何让模型学会说“我不确定”,或者通过 RAG(检索增强生成)来强行约束其“信口开河”的本能。